5.2 循环优化
5.2 循环优化
本节摘要:程序的热点高度集中在循环,循环优化因此是一档"投资回报率"最高的优化:循环不变量外提把计算搬出循环,强度削减把乘法换成加法,展开摊薄循环控制开销并开指令级并行,分块修补缓存局部性,向量化把标量循环压成 SIMD 指令——科学计算内核向量化后的典型加速在 2 到 8 倍。每个变换都带安全前提:出口支配保证外提不算白算,别名分析保证向量化不读写串行,归纳变量的 SSA 形式(3.2 的循环 phi)是强度削减的识别载体。读完你应当能对给定循环判断"哪些变换合法、收益量级多大",并解释为什么它们总是打包出现。
局部与全局优化对所有代码一视同仁,循环优化是"按热度定靶"的:4.3 圈出的自然循环(循环树上的每个结点)就是靶标。先看本节的主角长什么样,再逐一上武器。
一、循环不变量外提:把计算搬出重复区
循环不变量(loop-invariant):值在循环各圈之间不变化的计算。识别不难——操作数要么是常量、要么是循环外的定值、要么本身已是不变量(这个递归定义要求迭代到不动点);真正的门槛是合法性,教科书常讲一半:
for (i = 0; i < n; i++) { x = a * b; // 不变量?看起来是 c[i] = x + d[i]; }
外提 x = a * b 前要过三道闸。其一,出口支配:若循环内可能有异常或提前出口,外提会把"本不会发生的计算"变成"必发生的"——除零、空指针解引用这类可能陷阱的指令,只有在"出口块支配循环内所有执行 x 的块"(即走到就一定执行)时才可外提,否则把异常时序改了。其二,别名:若循环里有 store 可能写 a 或 b,x 的值圈圈不同——外提前必须确认 a、b 在循环内不被写。其三,频度:只有循环确实要转多圈,外提才有收益;一次都不进的循环,外提纯属白干(这个问题由 guarded 外提解决:包一层 if,进圈才算)。
三道闸里两道是第4章的直接应用:支配(4.4)管异常安全,别名(4.5)管内存安全。循环优化是前面全部分析的最大买家。
二、强度削减与归纳变量:乘法换加法
归纳变量(induction variable,IV):随循环圈数线性变化的变量,i 是标准的。派生 IV:i 的线性函数 j = c1 * i + c2。强度削减的基本观察:既然 j 每圈增加固定步长 c1 * step,何必每圈做乘法?维护"加法进度条"即可:
原始(i 步长 1): 削减后(SSA 记法): i1 = phi(i0, i2) i1 = phi(i0, i2) j1 = phi(j0, j2) j1 = phi(j0, j2) i2 = i1 + 1 i2 = i1 + 1 j2 = 4 * i2 j2 = j1 + 4 ← 乘 4 变加 4
注意 SSA 的循环头 phi(3.2 的"循环头是天然汇合点")正是识别 IV 的语法标记:循环 phi 的回边输入是"步长加法"的,就是 IV。削减后 j 的乘法定义消失,只剩加法链;若 j 从此再无别的用处,死 IV 删除把它的 phi 与加法一并清掉。历史故事值得一提:早期机器乘法比加法慢几十倍,强度削减是杀手锏;现代流水线乘法只慢 3–5 拍,削减的主要价值转向了让地址表达式变得规整——规整到下一站向量化能认出"这是步长固定的扫描"。
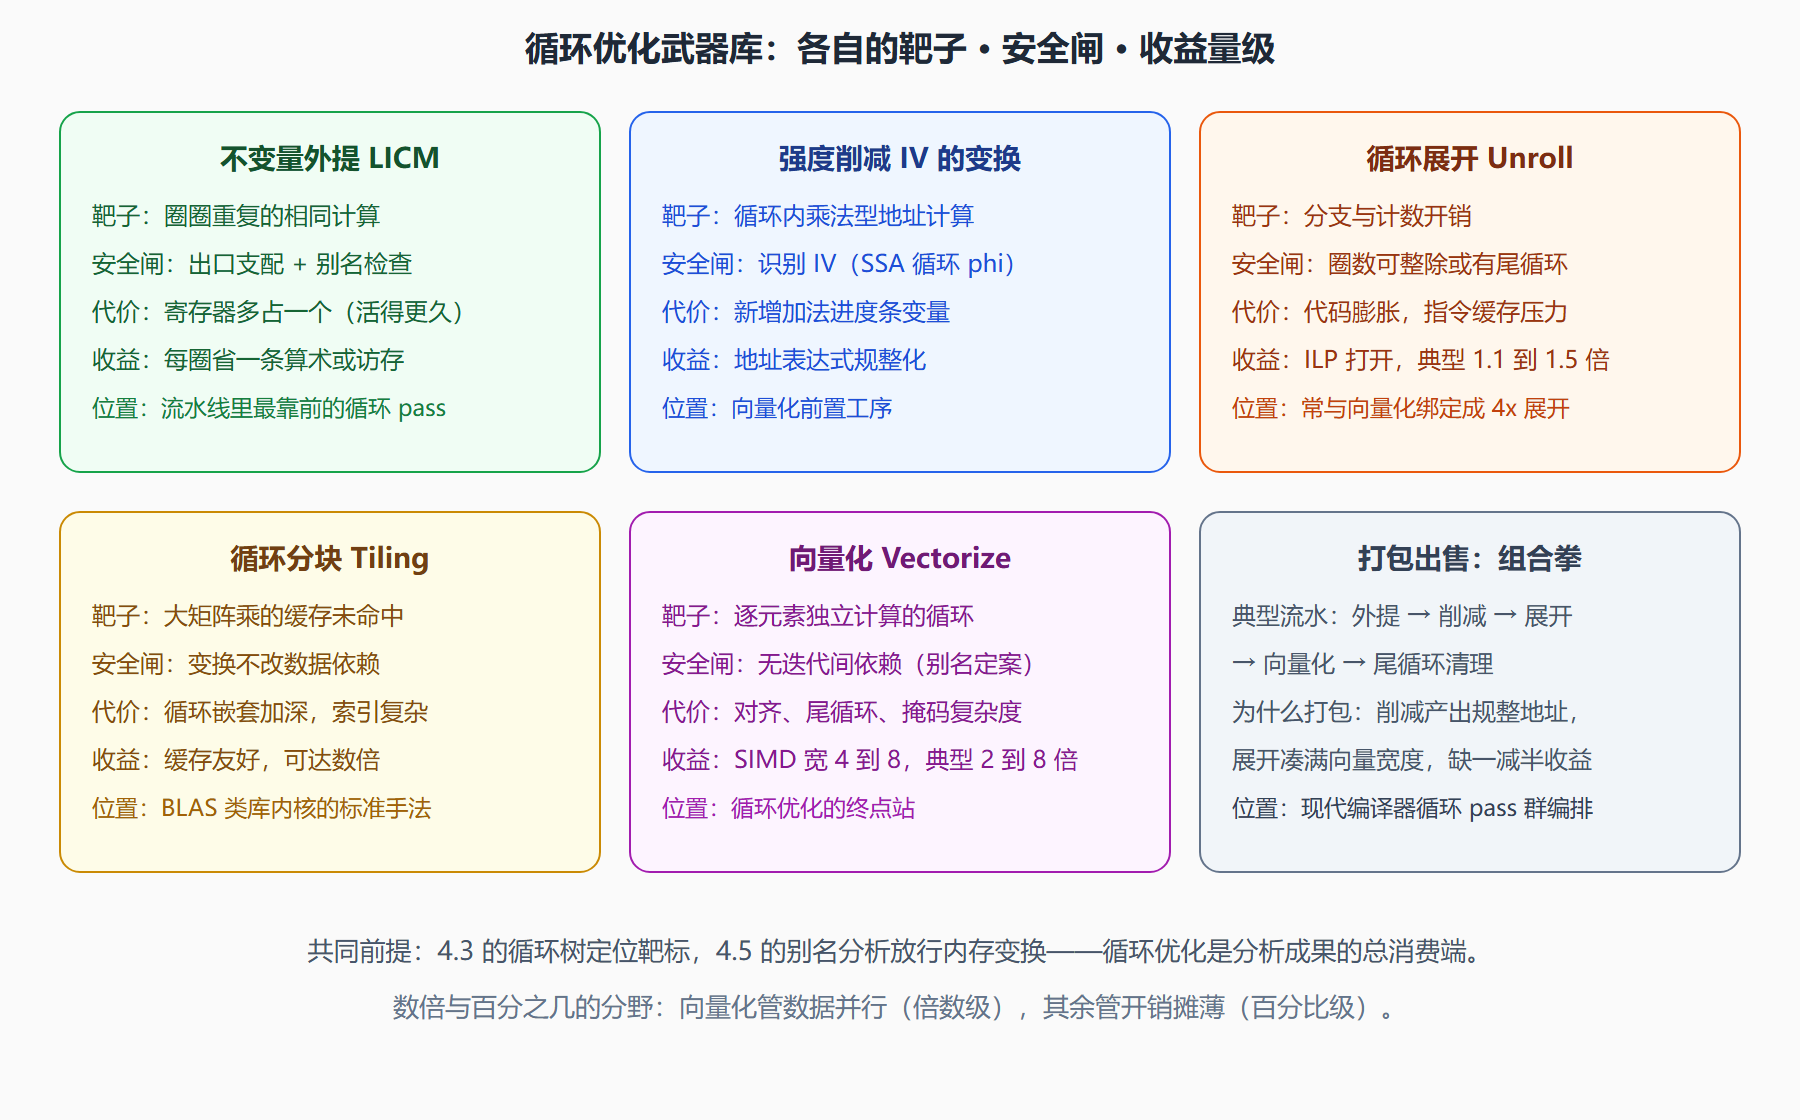
图:五个循环变换各自的靶子与代价
三、展开、分块与向量化:空间换时间的三种姿势
展开把循环体复制 N 份、计数器步长改 N:分支次数除以 N,更关键的是暴露指令级并行——原来"下一圈的加载"必须等分支裁决后才开始,展开后可以提前发射。代价是代码膨胀:展开因子过大反而把指令缓存(L1i)挤爆,性能掉头向下,所以编译器只展开"小而热的内核",且有尾循环(remainder loop)处理圈数不整除的情形。
分块打的是另一个瓶颈——内存。朴素矩阵乘三重循环,B 列与 C 行在内层反复扫过整块缓存,缓存未命中主导时间。分块把循环拆成"块循环 + 块内循环",让一块数据在被换出前榨干复用:块尺寸取缓存大小的若干分之一,大矩阵乘的加速可达数倍。分块不改计算语义、只改遍历次序,合法性由依赖分析(循环内两次访存是否冲突)背书。
向量化把"逐元素独立"的循环压成 SIMD:一条指令并行处理 4/8/16 个通道。合法性的全部重量压在别名与依赖分析上——a[i] = a[i] + b[i] 可向量化,a[i] = a[i-1] + b[i] 带迭代间依赖不可直接向量化(归约型依赖则要用掩码特殊处理)。加上对齐与尾循环的预处理后,这是循环优化的终点站,也是科学计算性能的分会场:矩阵内核向量化前后 2–8 倍是业界常见量级。
四、实战观察:变换为什么总是排队出现
单独看每个变换的收益都平平:外提每圈省一条指令(百分比级)、削减省一次乘法(百分比级)、展开 1.1–1.5 倍。但它们是一条流水线上的工序:外提清走无关计算让循环体变小,削减把地址算规整,展开凑出连续的同构操作,向量化最后收网。产品编译器里这组 pass 由循环树(4.3)驱动,从最内层向外逐层处理;跑完一轮后全局 DCE(5.1)清场,寄存器分配(第6章)为"活得变长的外提变量"重新记账——一个循环变换的成败,最后要在干涉图上称重。这也是为什么循环优化调参(展开因子、块尺寸)从来没有放之四海的答案:参数的最优值随缓存、流水线、循环体大小联动变化,第7章会看到 LLVM 把这些暴露成命令行旋钮。
本节要点回顾:
- 外提三道闸:出口支配(异常时序)、别名(内存安全)、guarded 包装(防白算);
- 强度削减:SSA 循环 phi 识别 IV,乘法换加法,现代价值在地址规整化;
- 展开:摊控制开销 + 开 ILP,1.1–1.5 倍,膨胀有反噬;
- 分块:改遍历次序修缓存局部性,矩阵内核数倍收益;
- 向量化:SIMD 数据并行 2–8 倍,别名与依赖分析是生死线;
- 组合拳:变换互相成就,打包收益远大于单卖。
循环再热,也热不过程序边界上的另一类机会:函数之间的调用链。下一节把优化的视野推过函数边境线。
一个完整的手算样例
把组合拳打一遍看得更清楚。给定循环体(a、b 为循环外数组,n 循环不变):
for (i = 0; i < n; i++) { int w = 3 * n; // 不变量 c[i] = w / 2 + a[i] + b[i]; }
流水线各站的工作:外提把 w = 3 * n 搬到循环前(无副作用、无别名风险、进圈即执行);强度削减把 w / 2 在搬出时直接折叠成 w >> 1(w 是编译期可追踪的整型值,非负时移位与除法等价);规整化后循环体变成三段访存加两次加法——这正是向量化想要的标准形态,c/a/b 三数组经别名分析确认互不相交后,SIMD 改写畅通;展开凑满向量宽度并补尾循环。最终内层每次迭代的有效指令数从"一乘一除三访存两加"压到"三访存两向量加"。每个变换单独看都只省一点,串起来是数倍差距——组合拳的价值就在这条工序链上。