7.5 LLVM Pass 管理器机制
7.5 LLVM Pass 管理器机制
本节摘要:pass 管理器(Pass Manager)是优化管线的调度中枢:它按声明次序执行 pass,但真正的价值在两件幕后工作——分析的生命周期管理(谁需要支配树?缓存起来给谁用?IR 一改何时失效?)与管线的模块化编排(pass 组合成模块级/函数级/循环级三层跑,扩展管线不用改编译器本体)。旧版管理器被"隐式全局状态"拖垮的历史教训,正是理解新版设计动机的最佳入口。读完你应当能解释"为什么 pass 要声明分析依赖"、分析失效的触发时机,并读懂一条 O2 管线的扩展描述。
7.3 的清单有上千个 pass,7.4 演示了逐个开关——但全量跑时,谁记住"这个 pass 要用支配树、那个 pass 刚把支配树弄脏"?pass 管理器。它是优化管线的操作系统。
一、旧管理器的教训:隐式依赖的债务
早期 LLVM 的 pass 互相"顺手依赖":某个 pass 默认内存里有现成的支配树,自己不声明、直接取用——上游一旦改动,这个隐含假设悄悄破产。这类问题的共同根源是全局状态 + 隐式契约:pass 之间不通过显式接口交换信息,而靠"跑在我前面的 pass 大概会把东西备好"。症状是:加一个 pass、调一个顺序,远处莫名其妙错一版——管线越长,定位越像玄学。工程上凡是"换个顺序就崩"的系统,病根几乎都是同一味:依赖没被显式化。
新 pass 管理器(2014 年起逐步接管)的处方只有一剂猛药:一切依赖显式声明,一切分析显式请求。pass 构造时注册"我需要什么分析";管理器看到声明,才决定构造、缓存或失效。旧的自由换来了旧的混乱,新约束换来可组合性。
二、分析的生命周期:缓存与失效
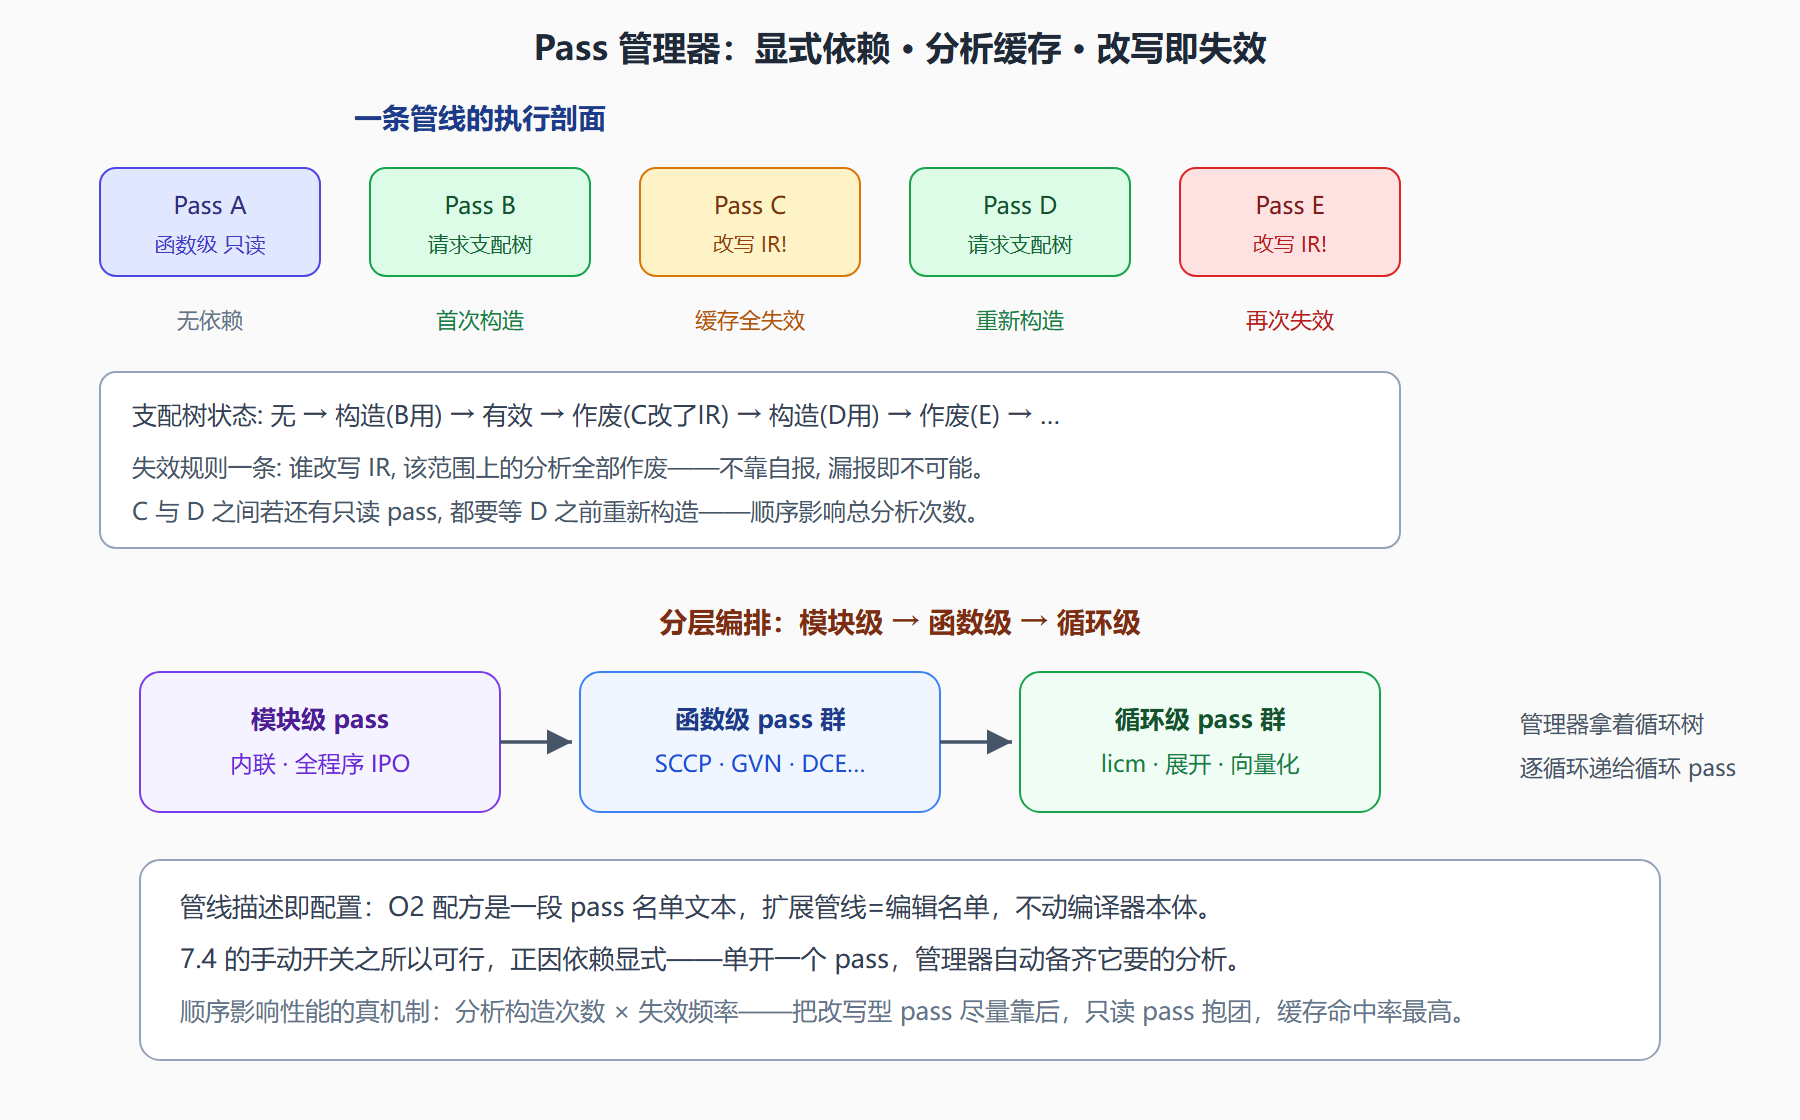
显式依赖让"分析的缓存"成为可能。典型场景:一条管线上 5 个 pass 都要支配树。没有缓存,支配树被构造 5 次(4.4 讲过它近线性,但架不住一遍遍重算);有缓存,第一次构造、后四次直接领——前提是中间没有人弄脏 IR。于是失效规则只有一条:任何 pass 改写了 IR,管理器把该 IR 范围上的全部分析结果标脏,下一个需要者重新构造。粗粒度但正确——"改写即失效"不需要 pass 自报改动明细,杜绝了"漏报导致拿陈旧分析优化"的一整类 bug。
管理器还有一层"范围匹配"的编排智慧。pass 按工作粒度分三层:模块级 pass(看全程序,如内联)、函数级 pass(一个函数一个函数过,如标量优化群)、循环级 pass(一个循环一个循环过,如展开、向量化)。管理器把三种粒度穿插编排:函数级 pass 群进入每个函数执行,遇到循环 pass 群时把循环树(4.3)逐个喂进去——循环 pass 从此不用自己遍历 CFG 找循环,拿着管理器递来的循环对象干活即可。7.4 手动逐 pass 开关时感受到的"分工",其组织者就是这套分层。
图:pass 管理器的一天——依赖、缓存、失效、分层
三、顺序为什么是玄学以及怎么不玄
"pass 顺序影响结果"有三个具体机制,全部可以显式推理:
- 分析构造次数:如上图,改写型 pass 让缓存反复失效。同样的 pass 集合,"只读抱团、改写殿后"与"读写交错"的分析总开销可差数倍——这是编译时间层面的顺序效应。
- 机会窗口:licm 外提后常量才能折叠;mem2reg 不跑,SCCP 无从下口。后一个 pass 的收益以前一个 pass 的产出为前提——7.3 的"互相吃蛋糕"在编排层的体现。
- 不满足依赖直接算错:若某个 pass 的正确性前提是"运行时变量已 SSA 化",顺序错了它拿到的是栈版 IR——验证器会拦下大部分,但语义类问题可能漏网。这是顺序影响正确性的通道。
新管理器把前两条变成可优化的工程问题(管线配方进版本控制、调序走基准测试),把第三条变成显式声明的责任(谁需要什么,写进注册代码)。所以"调 pass 顺序"这门玄学,正确的打开方式是:先把依赖声明读一遍,再用 7.4 的 A/B 工作法实测——玄学就退成了工程。
💡 关键直觉:pass 管理器之于优化管线,正如操作系统之于进程:单个 pass 是算法,管理器决定它们如何共享资源(分析)、如何被调度(次序与粒度)。理解一个编译器的优化行为,一半在读 pass,一半在读管理器的编排策略。
本节要点回顾:
- 历史教训:隐式全局状态让管线"换序即崩",新管理器用显式依赖声明根治;
- 分析生命周期:按需构造、缓存复用、改写即失效——一条规则封死陈旧分析;
- 三层粒度:模块/函数/循环级 pass 由管理器穿插编排,循环 pass 吃现成循环树;
- 顺序三效应:分析构造次数(编译时间)、机会窗口(收益链)、依赖满足(正确性);
- 管线即配置:O2 配方是一份名单文本,扩展与调序都是工程动作而非改源码。
IR 的工业形态到本章画完句号。最后一章看看这套范式正在长出的新枝:多级中间表示与 MLIR。
再进一步:观察管线运行的三个实用手法
看管线清单。O2 配方可以用命令行打印出来——一大串 pass 名按执行次序排列,是理解"编译器实际做了什么"的第一手材料。读清单的诀窍不是逐个查文档,而是用 7.3 的四坐标给它们分组:哪些是 mem2reg 的铺垫、哪些是循环 pass 群、哪些是收尾清理,几分钟后结构自然浮现。
看分析复用。带统计开关运行优化管线,可以看到每个分析被构造与失效的次数。拿两段同代码的管线对比——"只读 pass 抱团"版与"读写交错"版——支配树的构造次数差距一目了然。这个数字就是 7.5 开头那句"顺序影响性能"的实物形态。
看 pass 级时间。管线支持按 pass 计时,跑一个中型项目即可得到"哪个 pass 吃掉了编译时间"的排行榜。常见的意外是内联(5.3)与向量化(5.2)常年霸榜——它们的工作量与代码规模强耦合。给大型项目调编译时间,第一刀通常砍在向量化阈值与内联阈值上,而不是关掉整个档位。
这三个手法合起来回答一个初学者常有的疑惑:"编译器是不是个黑盒?"恰恰相反——成熟编译器的可观测性设计得相当周到:管线清单、分析统计、pass 计时、逐 pass 的 IR dump,全都从命令行可达。真正的门槛不是工具不在,而是读不懂输出里那些 pass 名在说什么。学完本册的你应该已经跨过了这道门槛:7.3 的坐标体系给名字归位,7.4 的工作法给数字对照,本节给调度行为画像。