6.1 指令选择
6.1 指令选择
本节摘要:指令选择(Instruction Selection)把"无限寄存器机器"上的 IR 运算映射成目标处理器的具体指令。同一个 IR 模式常有多种指令方案——
a + a可以是乘法、可以是移位、可以是 LEA——选哪条要看延迟、吞吐、寄存器压力的联合账。本节把指令选择形式化为"表达式树的模式覆盖"问题:指令模式是树的碎片,选择 = 用碎片拼满整棵树且成本最小,并讲贪心、动态规划、BURS 三档实现。读完你应当能对一个小表达式树手工做最优覆盖,并解释复合指令(fused multiply-add、带位移的寻址)为什么是这个框架的免费午餐。
优化的 IR 说的是"计算什么",指令选择决定"用哪条指令算"。这一步做得好不好,直接写进每条指令的延迟里。
一、同一个加法,三条指令:为什么选择是个问题
看一个最小的例子。目标 x86-64 上,t = a + a(a 在寄存器)至少三种写法:
方案A: mov rax, a; add rax, a 两条指令 方案B: imul rax, a, 2 一条乘法(3 拍延迟) 方案C: lea rax, [a + a] 一条地址运算(1 拍延迟) ← 赢
再放大一点,t = a * 5 + b 在 x86 上可以整个塞进一条 lea rax, [b + a*4 + a]——复合寻址模式把两步算术折叠成一条。选择不当的代价不是百分比级:热循环里一条错误选择(本可移位的用了除法、本可折叠的拆成三条)能把内层耗时翻倍。指令选择的本质困难在于:局部最优不等于全局最优——单看一条 IR 指令选得再精,组合起来可能次优。
二、形式化:树覆盖与碎片成本
把问题收拾成数学形状。IR 的 DAG(表达式树带共享)上,每条目标指令对应一个"树碎片"(tree pattern):根是一个操作、叶子是寄存器/立即数/内存,碎片带成本(延迟、尺寸、功耗任意折算)。指令选择 = 用碎片拼满整棵树,总成本最小。这正好是加权区间覆盖在树上的推广,动态规划自底向上(叶子向根)算每个子树的最小成本即可:
TreeDP(n): # 后序遍历 for n 的每个孩子 c: TreeDP(c) # 先解子问题 cost[n] = +∞ for 每个匹配"根为 n 的子树"的模式 p: total = cost(p) + Σ cost[孩子子树按 p 的叶子分割] cost[n] = min(cost[n], total) 记录 best[n] = p
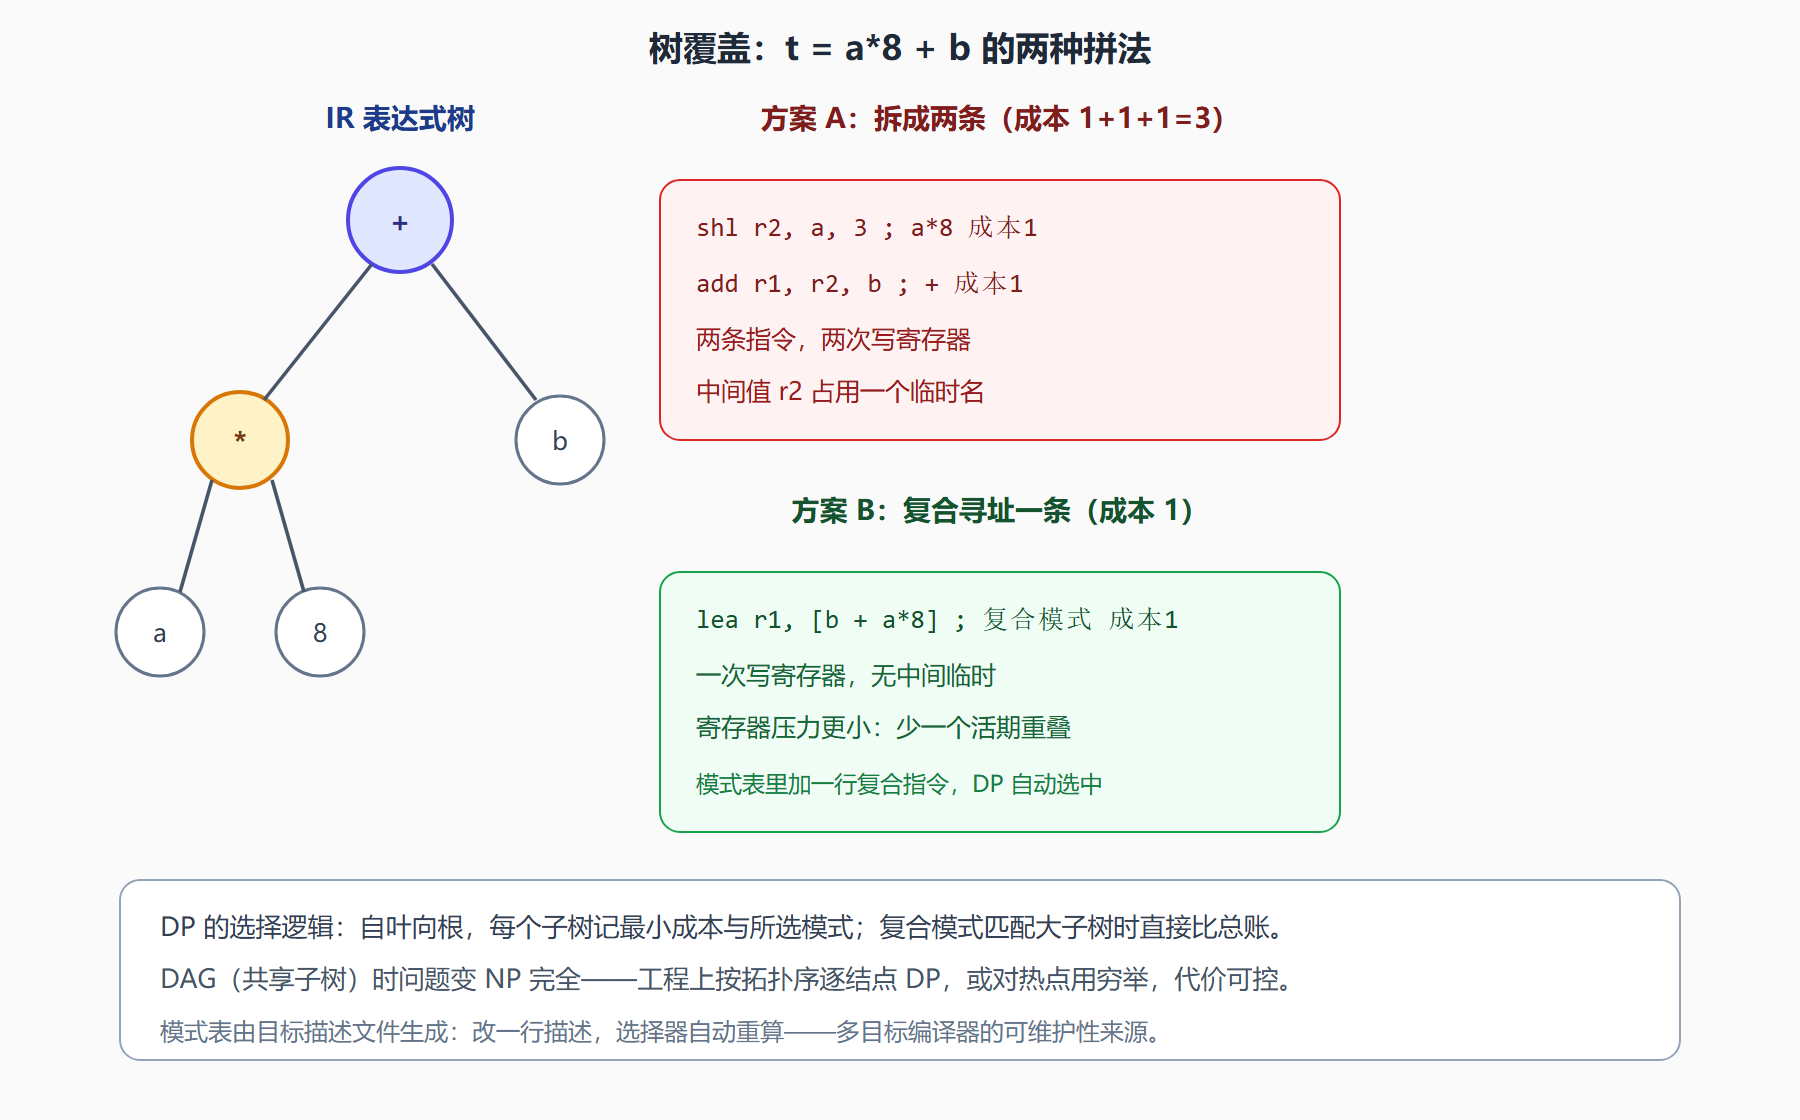
上图手算一个例子(目标是"加法、乘立即数、移位"三模式,成本 1/2/1):t = a*8 的子树,乘法模式成本 2;移位模式成本 1——DP 取移位。t = a*8 + b 整树,"拆成移位+加法"成本 2;若目标有"带移位加法"复合模式(成本 1),DP 自动选出复合指令——复合指令是这个框架的免费午餐:不用改算法,往模式表里加一行就行。x86 的 fused multiply-add、带索引寻址的 load,全靠模式表表达。
图:表达式树的两种覆盖方案与成本比较
三、实现策略三档与工程现实
- 贪心宏展开:每个 IR 操作独立查表选指令。实现最简(早期编译器与教学编译器),代价是复合指令的机会全丢、局部陷阱多(
a*8独立选移位没错,但看不出能折进lea)。 - 树上动态规划:上一节的方法。每函数毫秒级,最优性有保证(树情形),是中等复杂度目标的甜点位。
- BURS(自底向上重写系统):把模式表写成项重写系统,用理论驱动的自动生成器(经典实现是 twig 与 GCC 的 gen* 系列)生成选择器,一条指令一拍完成归类。多目标、多模式的大编译器(GCC/LLVM 这类)用这套或其变体;代价是模式描述的语言学习成本与生成器的调试难度。
工程现实还有两条容易被忽略。其一,选择与 ABI/调用约定耦合:参数放哪个寄存器、返回值走哪条通道,都是选择阶段的硬约束,模式表里必须显式建模。其二,SIMD 让"一条指令多个操作"成为常态:向量化(5.2)产出的 IR 里,一个节点代表 8 路并行的加法,选择器要为每种向量宽度 × 每种元素类型 × 每种操作维护模式——模式表的规模随 SIMD 宽度平方级增长,这正是"目标描述生成选择器"而非手写的根本原因。
💡 关键直觉:指令选择是"翻译中的翻译"——IR 语义不变的前提下,在目标指令集中找最划算的表达。判断选择器好坏只看两件事:热路径上有没有明显多余的三连小指令,复合指令的机会抓住了没有。
本节要点回顾:
- 指令选择 = 树覆盖:指令是带成本的树碎片,DP 自底向上取全局最优;
- 复合指令免费午餐:模式表加一行,DP 自动选中(lea、FMA、复合寻址);
- 三档实现:贪心查表(简单但瞎)、树上 DP(中等目标甜点)、BURS 自动生成(大型多目标);
- DAG 是 NP 完全的:共享子树让最优覆盖变难,工程按需降级;
- 与调用约定、SIMD 宽度耦合:模式表的复杂度大头来自这些目标细节。
指令选定之后,虚拟寄存器的数量仍然超标——下一节面对全编译器最难啃的问题:把无限塞进有限。
追问三则
问:指令选择发生在优化之前还是之后? 两边都有,但产物不同。中端的"选择"发生在通用 IR 上,产出目标无关但目标感知的形态(比如把除以常量换成乘倒数——哪些常数值得这么换,取决于目标有没有便宜乘法);真正的目标相关选择在后端(本章),输入已是目标指令集的抽象形态。两层各管一段:中端管"值不值得",后端管"具体用哪条"。LLVM 的 SelectionDAG 与 GlobalISel 都属于后端这一层。
问:除法、开方这类"贵指令"怎么选? 它们是选择器里最讲究的部分:除以常量 2 可以变移位,除以常量 3 变乘加移位序列(魔数法——编译器现场算出魔数与移位量),除以变量只能老老实实走除法指令(或调用软除法例程)。同一行 C 的 x / 3 与 x / y 生成的代码量可能差十倍——代价模型对"贵指令"的敏感度,直接写进程序性能。
问:目标描述文件长什么样? 每条指令一行模式描述:匹配什么 IR 形状、产出什么指令、成本多少、约束哪些寄存器类。几十种目标架构共享同一套描述语法与选择器生成器——新芯片移植的主要工作量就是在描述文件里补模式,而不是改编译器代码。这是"数据驱动设计"在编译器里最成功的落地之一:把知识放进数据,代码只实现通用的匹配机器。