6.4 指令调度
6.4 指令调度
本节摘要:指令调度(Instruction Scheduling)在不改变程序语义的前提下重排指令次序:真依赖不能动,无关指令则尽量填进长延迟指令的空档,把流水线的气泡挤出去。调度问题建在依赖 DAG 上,经典解法是列表调度(list scheduling):每周期从"就绪指令"里按优先级挑一个发射。本节讲依赖分类、列表调度算法与优先级设计,以及一个贯穿后端的经典两难——调度希望无关指令早发射(活期拉长、寄存器压力变大),分配希望活期越短越好;不同编译器把调度放在分配之前或之后,正是对这个两难的不同答卷。读完你应当能手工对一个 8 指令块做列表调度,并解释为什么顺序不对时流水线会空转一半。
6.1 选定了指令,6.3 给它们分好了寄存器,还剩一件事:次序。同样 8 条指令,排错次序流水线空转,排对次序严丝合缝——调度是后端最后的免费午餐。
一、依赖分类:什么能动,什么不能动
先划红线。两条指令的次序不可交换,当且仅当存在真依赖:
RAW(读后写,真依赖): r1 = add r2, r3 r4 = mul r1, r5 ← r1 是算出来的,必须等 WAR(写后读,反依赖): mul r1, r2, r3 add r1, r4, r5 ← 后者覆盖 r1,前者还没读旧值? WAW(写后写,输出依赖): mul r1, ... add r1, ...
RAW 是数据本体的因果,调度绝对服从。WAR 与 WAW 是名字依赖——冲突的只是"名字",不是值:给其中一条换个寄存器(寄存器重命名),冲突即消失。乱序执行硬件在运行期做重命名,静态编译器则靠分配阶段"顺手"给不同值不同寄存器来消解名字依赖——这也是 6.3 的图着色比线性扫描多出来的隐性收益:着色自由度让更多名字依赖被自然解开。
调度器在依赖 DAG 上工作:结点是指令(带延迟),边是依赖(RAW 是硬边,访存指令之间还要加内存依赖边——两笔对不同地址的 store 理论上可换序,但别名不明的 load/store 必须保守连边,4.5 的别名分析在这里直接决定调度自由度)。
二、列表调度:每周期挑最值钱的就绪者
列表调度的骨架是按周期模拟流水线:
ListSchedule(DAG, 每周期可发射数 w): ready = 无前驱的指令(按优先级排序) for cycle = 0, 1, 2, ...: 发射 ready 前 w 条(资源不冲突时) 更新各指令的"最早可发射周期" 前驱全部发射完的指令进入 ready until 所有指令发射完毕
全部智慧在优先级里。最常用的两把尺子:其一,到叶的最长路径(决定关键路径——它决定整个块的下界,关键路径上的指令永远优先);其二,后裔数(它晚发射会堵住多少条指令)。两把尺子合成一个总分,平手时看延迟(长延迟指令先发射,让它的空档早开始被别人填)。
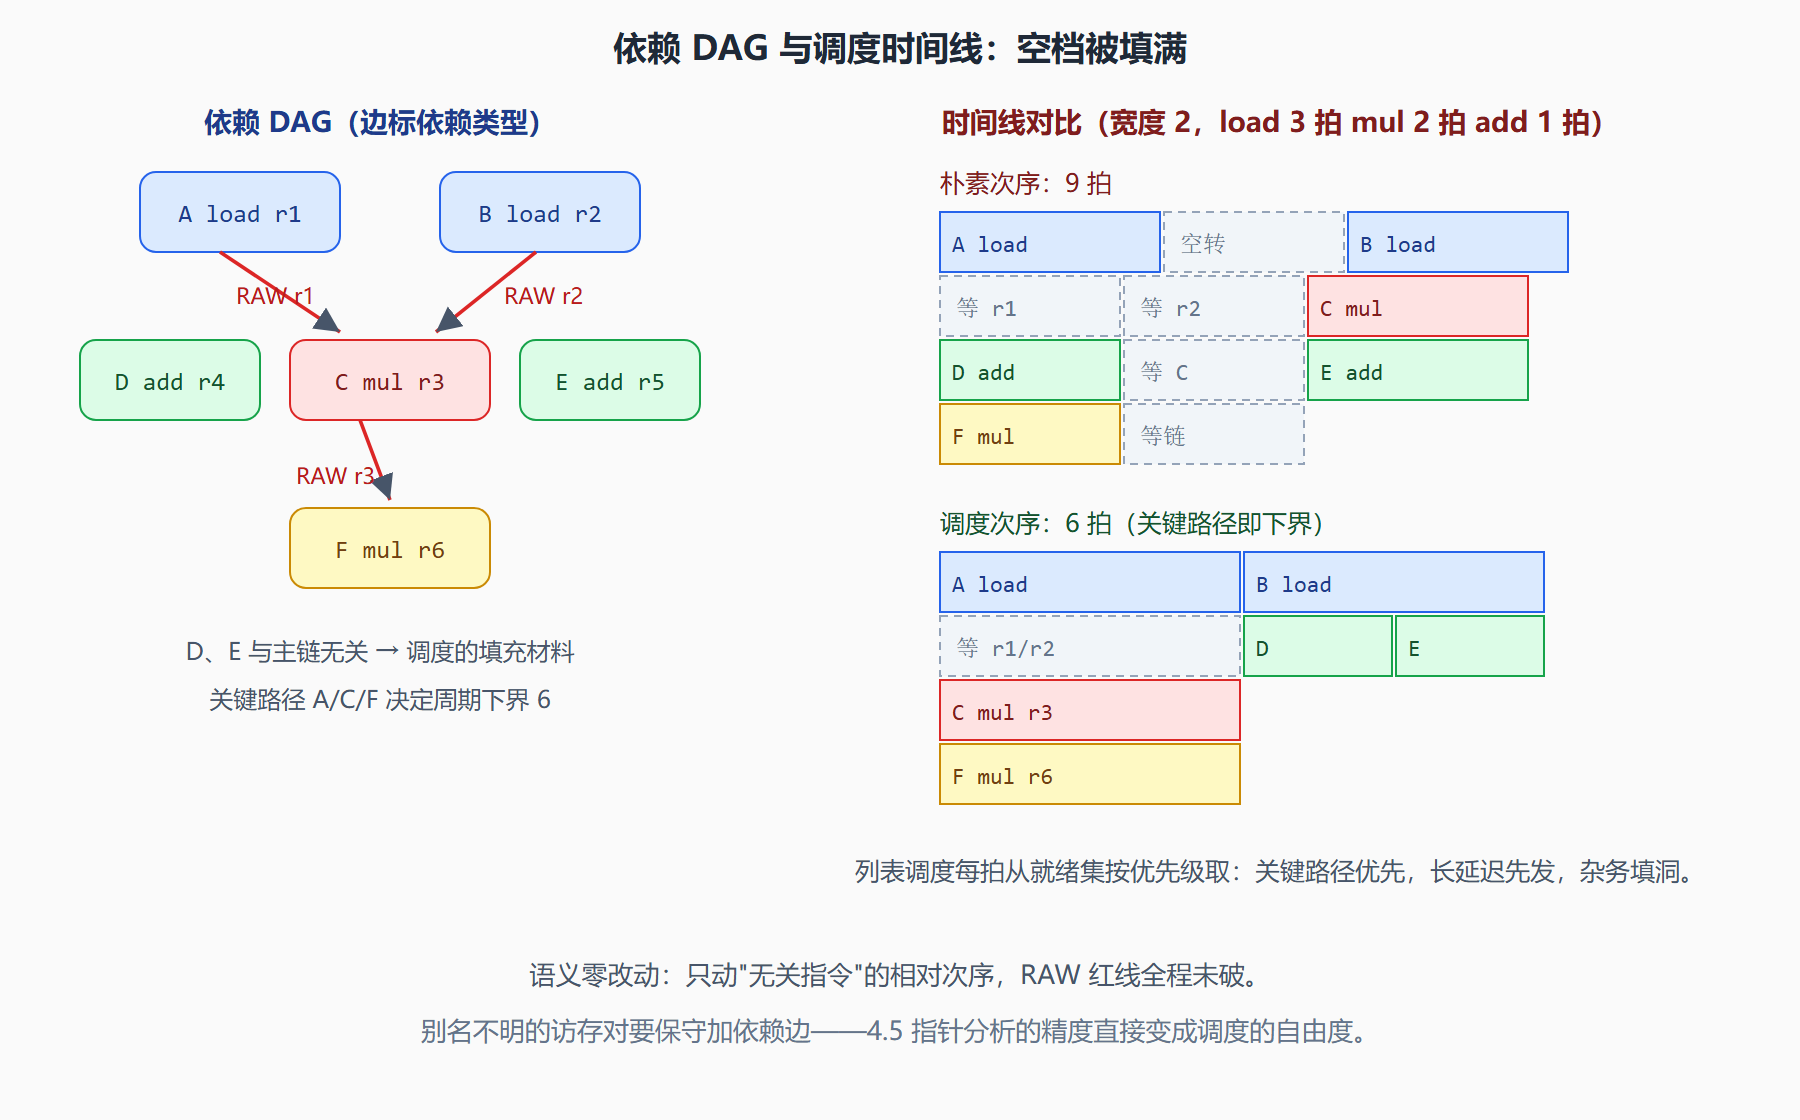
手算一个 4 周期的例子(延迟:load=3, mul=2, add=1;发射宽度 2):
依赖: 朴素次序: 调度后: A: r1 = load [x] A (load) A (load) B (load) ← 两个 load 并行 B: r2 = load [y] B (load) ← 等 A 完 C (mul) 空档←A 未回 C: r3 = mul r1, r2 C (mul) ← 等 B 完 D (add) E (add) ← 无关指令填洞 D: r4 = add r4, 1 D (add) F (mul) ← r1,r2 已回 E: r5 = add r5, 1 E (add) F: r6 = mul r4, r5 F (mul)
朴素次序六条串成一条线;调度后 A/B 并行发射,C 等 r1、r2 的 3 拍空档里塞进 D、E 两件杂务。总周期从 9 压到 5——次序没改语义,时间几乎减半,这就是调度的含金量,也解释了为什么乱序处理器花那么多晶体管做同一件事。
图:依赖 DAG 与两种次序的时间线对比
三、与寄存器分配的拉锯:两难与两种编排
调度的私心是"无关指令早发射"——越早发射,其结果的活期越早开始、越晚结束,寄存器压力越大。分配的私心正相反:活期越短越好。这个两难决定调度在流水线里的两种编排:
- 分配前调度(调度自由度最大:指令还是虚拟寄存器,重排无顾忌;但分配随后插入的溢出访存与拷贝没人再调)。适合溢出少的代码。
- 分配后调度(看到的指令数与真实访存完全一致,能对溢出代码精调;但重排受物理寄存器名约束,WAR/WAW 名字依赖限制了移动自由——分配器把名字绑死后,很多本可移动的对子动不了)。
现代编译器的务实答案是两段调度:分配前粗调(大局次序、给分配一个压力合理的输入),分配后细调(收拾溢出访存)。循环内的调度还有第三个玩家——模调度(software pipelining):把第 i+1 圈的 load 与第 i 圈的运算重叠起来,让循环体的多个圈在流水线上并行流动,密集循环收益显著;代价是寄存器需求上升(同圈的多个叠影同时活)与序言/尾声的复杂化。它再次印证本章主轴:后端的一切自由都拿寄存器支付。
💡 关键直觉:调度的目标是"隐藏延迟"而非"减少指令"。指令条数一条没变,总时间却可能差近一倍——因为现代处理器的瓶颈是"下一条指令能不能立刻发射",不是"指令总共多少条"。
本节要点回顾:
- 红线与自由:RAW 不能动,WAR/WAW 是名字依赖可重命名消解,别名不明加保守边;
- 列表调度:按周期模拟,优先级 = 关键路径 + 后裔数,长延迟先发;
- 手算要领:先画 DAG 找关键路径定下界,无关指令当填充材料;
- 两难与编排:调度拉长活期 vs 分配缩短活期,工程取"分配前粗调 + 分配后细调";
- 模调度:圈间重叠的极端优化,收益与寄存器压力同步上涨。
到这里,从 IR 到硬件的降落完成。下一章进入真实编译器的机械间:LLVM 如何把本册的全部概念组织成一条可运行的流水线。
追问两则
问:既然硬件乱序执行,静态调度还有意义吗? 有,理由有三。其一,乱序窗口有限(典型的只有几百条指令的视野),静态调度把"好的次序"预先排好,等于替硬件省了侦察;其二,乱序核也有不乱序的部分——访存顺序、分支预测的方向性,静态安排得更优就是净赚;其三,嵌入式与低功耗核根本是顺序执行,静态调度是那里唯一的调度。硬件越强,静态调度的边际收益越小,但"小"不等于"无"。
问:函数入口处的"序言"也要调度吗? 要,而且是最需要全局观的地方。压栈、保存被调用者寄存器、建立栈帧、参数就位——这条序列若串行执行,每次调用都白付一串周期;好的调度把它与函数开头的无关计算重叠起来,调用密集的代码上收益可观。类似地,循环的重复序言(每次进入循环都要重做一遍的初始化)值得外提与合并——调度与 5.2 的循环优化在这里握手。