4.1 HPC典型应用领域
4.1 HPC典型应用领域
本节摘要:HPC 不是为跑分而生的,它是为解决"单机搞不定"的真实问题而生的。本节拆解 HPC 在五大领域的角色:气候与天气模拟(多尺度耦合的偏微分方程)、计算流体力学(航空航天和汽车设计)、分子动力学与药物发现(原子级追踪和虚拟筛选)、计算化学与材料科学(量子级模拟预测性质)、AI 大模型训练(数据并行加模型并行)。每个领域都说明同一件事:没有 HPC,这些问题要么不可解,要么不可及时解。
读前必看
阅读完本节,你应当能够:
- 说清 HPC 在五大领域的角色和价值
- 解释为什么这些应用"单机搞不定"
- 区分不同领域对 HPC 的不同需求特征
- 理解 HPC 不可替代性的根源
一、问题与直觉
为什么要花几个亿建一台超算?这个问题最好的回答不是"算得快",而是"不算就解不了"。气候预测、新药研发、飞行器设计、新材料发现——这些关乎国计民生的问题,背后都是规模大到单机无法承载的计算。一台超算的价值,不在于它的峰值浮点数,而在于它让"原本不可解的问题"变得可解。
这些领域有一个共同特征:问题本身是大规模、多尺度、强耦合的。气候模型要同时处理全球尺度的环流和局地尺度的云物理;药物筛选要从上亿个分子里找几个有效的;飞行器气动优化要在海量设计参数里搜索最优解。这些计算的数据量、计算量、耦合复杂度,远远超过任何单机的承载能力。HPC 不是它们的可选项,而是必需品。
这一节拆解五个最典型的 HPC 应用领域,看 HPC 在每个领域扮演什么角色、解决什么核心难题。
二、核心原理
2.1 气候与天气模拟
气候和天气模拟是 HPC 最经典也最重要的应用之一。它的核心是求解描述大气、海洋、陆地、冰冻圈耦合演化的偏微分方程组。这些方程的变量维度极大(全球网格的每个格点都有多个变量),时间步长要足够细(解析快波传播),非线性耦合复杂(辐射、云微物理、湍流互相影响)。
单机根本算不动——全球一公里分辨率的网格、百万级时间步、每个格点十几个变量的耦合计算,总计算量是单机算力的天文数字倍。HPC 把空间网格切给不同节点并行求解,节点间交换边界数据实现耦合,才让这种规模的模拟在可接受时间里完成。天气预报能从"三天预报"做到"七天预报",靠的就是 HPC 算力的持续增长支撑了更高分辨率的模型。
这里的"分辨率"参数直接对应算力消耗的指数级增长,值得用数字感受。把全球网格从十公里分辨率提到一公里,格点数增加一百倍(因为二维网格按面积平方反比);再要解析垂直方向更细的层次,又是几倍到几十倍。加上为了保持数值稳定、时间步长必须随空间分辨率同步缩短一倍,总计算量再翻一番。粗算下来,从十公里做到一公里,算力需求增加两三个数量级。这就是为什么气象部门对超算的胃口几乎是无限的——每代新超算到手,第一件事就是把模型分辨率提一档,去解析过去算不动的局地强对流、台风眼这些精细过程。算力增长的速度,直接决定了预报精度的天花板。
2.2 计算流体力学
计算流体力学(CFD)在航空航天、汽车、建筑领域用得最多——模拟飞机机翼的气流、汽车的风阻、建筑的风载荷。它的核心是求解描述流体运动的纳维-斯托克斯方程,通常用有限元或有限体积法离散化。
CFD 对 HPC 的需求来自两方面:网格规模大(一个飞机整机模拟的网格能到几亿甚至几十亿单元),和迭代步数多(收敛到稳态要成千上万步)。大规模网格的并行要处理好网格分区(让各节点的负载均衡)、边界通信(相邻网格的数据交换)、稀疏线性方程组求解(每步迭代的瓶颈)。HPC 让 CFD 从只能算简化的二维模型,进步到能算真实三维整机的精细模拟。
2.3 分子动力学与药物发现
分子动力学(MD)模拟追踪大量原子(蛋白质、DNA、溶剂分子)在时间上的运动,用于理解生物分子机制和筛选药物。它的计算特征是:原子数大(一个蛋白质加溶剂能到几十万原子)、时间步极短(飞秒级,要解析最快的键振动)、总模拟时长长(微秒级需要十亿步)。
| 需求特征 | 数量级 | 对 HPC 的要求 |
|---|---|---|
| 原子数 | 几十万到几百万 | 大内存、力计算的并行 |
| 时间步 | 飞秒 | 海量步数的吞吐 |
| 总时长 | 微秒 | 长时间稳定运行 |
药物发现里的虚拟筛选更吃 HPC——要从上亿个候选分子里找到能和靶点蛋白结合的,每个都要做分子对接计算,总计算量惊人。HPC 让这个过程从几个月缩到几天,是新药研发加速的关键。
分子动力学还有一个独特的性能特征值得讲:力计算的邻居列表。每个原子受到附近原子的作用力,距离远的可以忽略。但"哪些原子算邻居"是动态变化的——原子在运动,邻居关系在变。每隔一定步数要重建邻居列表,这个重建是数据不规则的、难以向量化的,常常成为性能瓶颈。HPC 上的成熟实现(如 GROMACS、NAMD)用了大量技巧优化这一步:用单元格分解把邻居搜索局限在局部、用 Verlet 列表缓存邻居关系、把力计算搬到 GPU 上但邻居列表留在 CPU。这种 CPU 加 GPU 的异构分工是 MD 代码的典型模式,也说明异构编程不是"全部搬 GPU",而是按数据特征精细分工。
总模拟时长的限制是 MD 应用的另一道坎。生物过程的有趣时间尺度常常是毫秒级(比如蛋白质折叠),而单步积分是飞秒级,要模拟一毫秒需要十亿步。即便用上最大的超算,也只能模拟到微秒量级。这是算法层面的限制,不是单纯堆算力能解决的——所以近年来出现了增强采样、马尔可夫状态模型这些把多次短模拟拼接成等效长模拟的方法,本质是用统计手段绕过时间步数的物理限制。
2.4 计算化学与材料科学
计算化学用量子力学方法(如密度泛函理论 DFT)预测分子的性质和反应,材料科学用它设计新材料。这些量子级模拟的计算量随电子数多项式甚至指数增长——一个几百原子的体系,单机算一次可能要几个月。
HPC 让计算化学能处理更大的体系(从几十原子到几千原子)、做更精确的方法(从半经验到全量子)、做更高通量的筛选(材料基因组计划里一次筛选上万种候选材料)。这是新材料逆向设计——从"想要的性质"反推"该有什么结构"——的计算基础。
2.5 AI 大模型训练
这是当下最热的 HPC 应用。训练千亿参数的大模型,单次迭代要在海量数据上做巨大的矩阵运算,单 GPU 根本装不下,必须用数据并行(把数据分给多卡)、张量并行(把模型切到多卡)、流水线并行(把网络层分到多卡)等多种并行组合。
大模型训练对 HPC 的需求特征和传统科学计算不同:计算强度高(矩阵乘法)、通信模式相对规则(梯度同步的 Allreduce)、但规模极大(几千上万张 GPU)。它推动了 HPC 的硬件(专用 AI 加速器、高速互连)和软件(混合精度训练、梯度压缩、ZeRO 优化器)的快速演进。某种意义上,大模型训练正在重塑整个 HPC 生态。
三种并行的取舍值得细看。数据并行最简单,但每张卡都要装下完整模型,大模型放不下;张量并行把单层切开,通信频繁但对带宽要求高,通常只在节点内(靠 NVLink 高速互连)做;流水线并行把层切到不同卡,通信少但引入气泡(前一批没算完后一批不能进下一阶段),需要微批次调度填气泡。实际训练千亿参数模型时,三者必须组合:节点内张量并行、节点间流水线、外层数据并行。这个组合的调参极其复杂,通信和计算的占比、气泡大小、显存占用互相牵扯,是当前大模型工程化的核心技术难点。
三、工程实践要点
3.1 不同领域的 HPC 需求差异
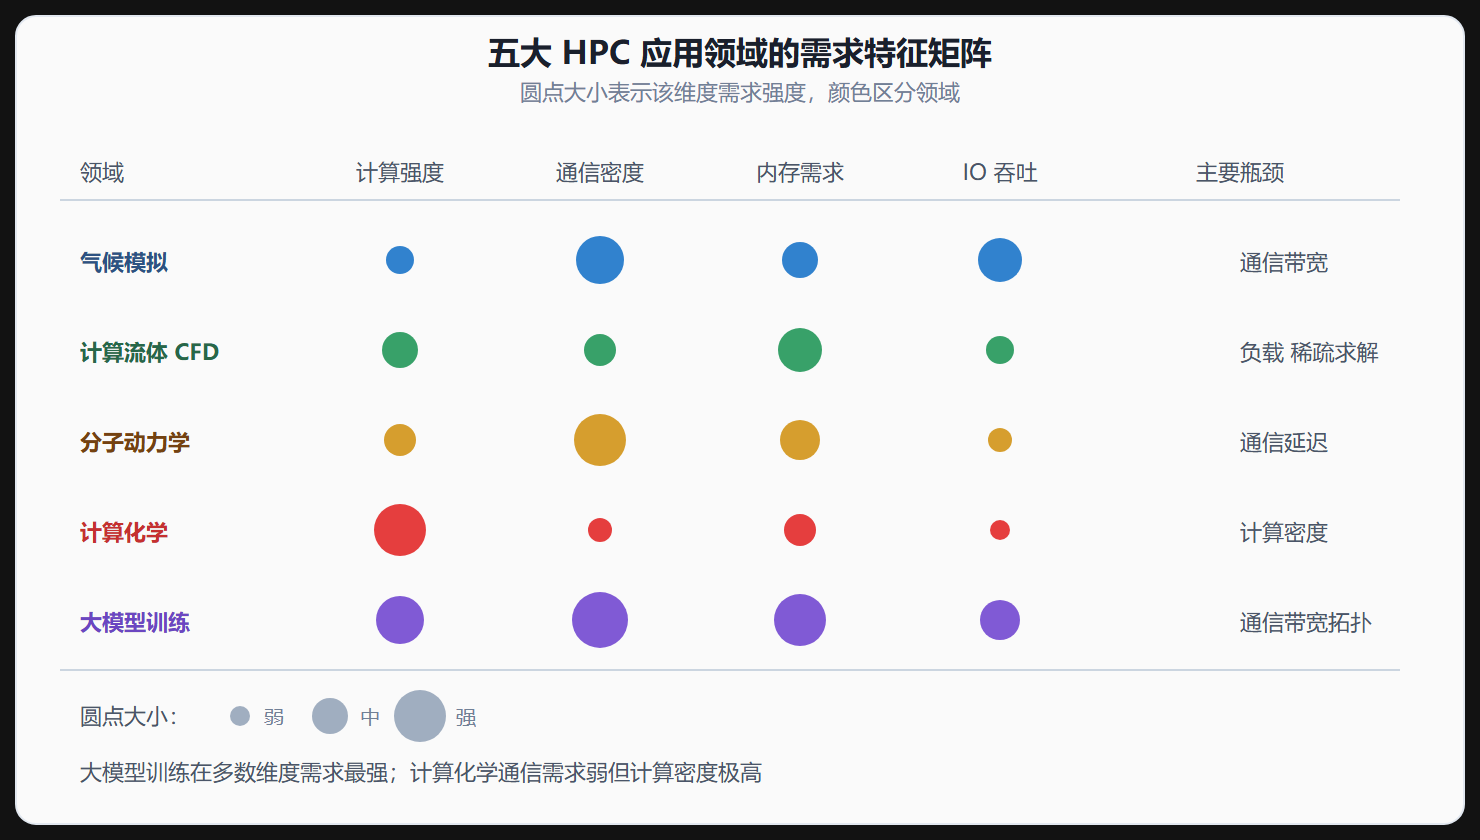
| 领域 | 计算特征 | 通信特征 | 主要瓶颈 |
|---|---|---|---|
| 气候模拟 | 规则网格 | 规则边界交换 | 通信带宽 |
| CFD | 非结构网格 | 不规则边界 | 负载均衡、稀疏求解 |
| 分子动力学 | 粒子相互作用 | 力计算的邻居通信 | 通信延迟 |
| 计算化学 | 量子计算 | 密集矩阵 | 计算密度 |
| 大模型训练 | 矩阵乘法 | 梯度同步 | 通信带宽和拓扑 |
理解这些差异很重要,因为不同领域对硬件和并行策略的偏好不同。气候模拟要高带宽互连;CFD 要好的网格分区和稀疏求解器;分子动力学对通信延迟敏感;计算化学要高计算密度;大模型训练要特殊的拓扑和优化器。
图 五大应用领域对 HPC 的需求矩阵
3.2 跨学科协作的挑战
💡 关键直觉:HPC 应用落地的最大障碍往往不在技术,而在跨学科协作。一个气候模拟项目需要气象学家、数值方法专家、并行计算工程师、系统管理员协同。气象学家懂物理不懂并行,计算工程师懂并行不懂气象,中间的鸿沟常导致"科学家写的代码能跑但不高效,工程师能优化但不理解物理含义"。培养既懂领域又懂并行的复合人才,是 HPC 发挥价值的关键瓶颈。
3.3 从模拟到决策
HPC 的最终价值不是产出一堆数据,而是支撑决策。气候模拟支撑政策制定、CFD 支撑工程设计决策、药物筛选支撑临床试验决策。这意味着 HPC 的结果必须可信、可解释、可传递给决策者。这就把可验证性、不确定性量化这些话题推到了前台——一个不可信的模拟,算得再快也没用。
核心回顾
- 五大典型应用:气候、CFD、分子动力学、计算化学、大模型训练,每个都是 HPC 不可替代的领域。
- 共同特征是大规模、多尺度、强耦合,单机根本承载不了。
- 不同领域对 HPC 的需求不同:气候要带宽、CFD 要负载均衡、MD 对延迟敏感、化学要计算密度、大模型要拓扑。
- 跨学科协作是落地最大障碍,复合人才是关键瓶颈。
- HPC 的价值在支撑决策,可信和可验证比算得快更重要。
下一节看 HPC 当前面临的挑战和未来方向。