2.1 表格:从对齐到单元格换行
2.1 表格:从对齐到单元格换行
表格由管道符分隔列、减号分隔行构成,冒号位置控制对齐。它是 GFM 扩展里使用率最高的一个,也是"单元格里想换行"这一名需求的集中爆发地。这节从手写第一张表到解决换行难题,一次练完。
动手:手写一张选型表
| 方案 | 学习成本 | 性能 | 适用规模 | | --- | :--- | :---: | ---: | | 方案甲 | 低 | 中 | 小型 | | 方案乙 | 中 | 高 | 中大型 | | 方案丙 | 高 | 极高 | 海量 |
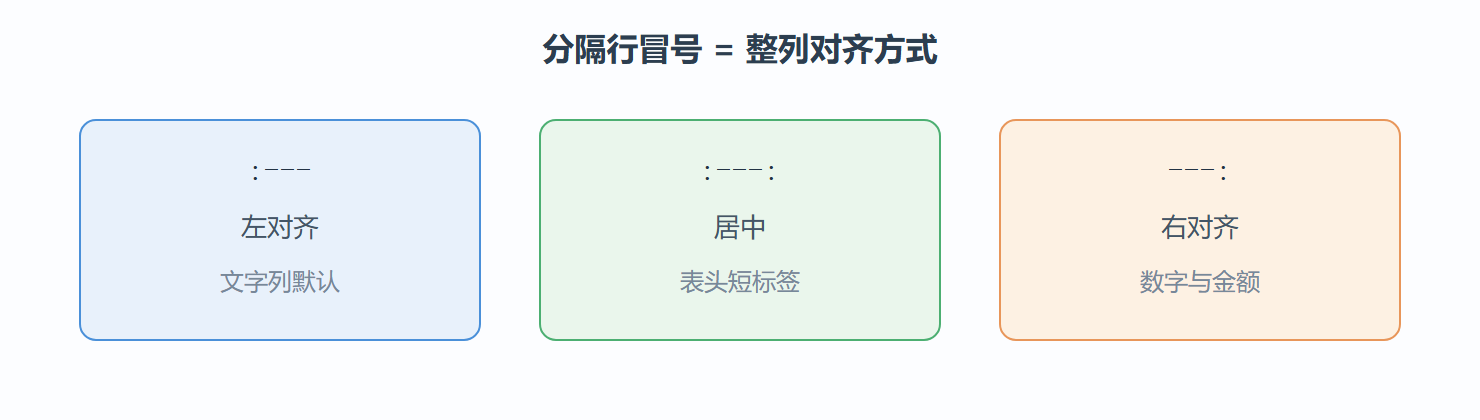
三行结构:表头、分隔行、数据行。分隔行的冒号决定整列对齐——:--- 左对齐、:---: 居中、---: 右对齐(写在右边)。数字列右对齐是个好习惯,个十百千天然对位。
源码里管道符不必对齐得整整齐齐,下面这样也能渲染:
| 方案 | 成本 | | --- | --- | | 甲 | 低 |
但列宽对齐的源码在纯文本态可读性好得多。编辑器的"表格格式化"功能(多数 Markdown 编辑器自带)能一键对齐,写作时先不管宽度,发布前格式化一次即可。
⚠️ 常见坑:表格上下都要有空行。紧跟标题或段落的表格可能不被识别;表格前一行是文字时尤其容易翻车。
单元格里想换行怎么办
标准表格单元格不支持换行、不支持列表——单元格里的一切行内语法都行,块级语法全不行。三条出路:
路线一:HTML 换行标记(最常用):
| 事项 | 说明 | | --- | --- | | 部署 | 分两步<br/>先灰度后全量 |
路线二:把内容拆行成列表——如果信息密到单元格装不下,多半说明它不该待在表格里,改成"表格概览 + 列表明细"两层结构。
路线三:内联 HTML 表格——极端复杂的合并单元格场景,直接写 HTML 的 table 标签。维护成本高,万不得已再用。
单元格里的管道符
想在某格里显示管道符本身,用 \| 转义或 HTML 实体写法,否则它被当作列分隔符,整行多出一列。
表格 vs 列表 vs 图的决策
| 信息形态 | 首选载体 | 反例特征 |
|---|---|---|
| 二到四维、行数适中 | 表格 | 维度再多读者会迷路 |
| 单维并列 | 列表 | 两列表格是"伪装的列表" |
| 有流向/依赖关系 | 流程图(第 3 章) | 表格表达不了先后 |
| 大段解释性文字 | 小节正文 | 单元格塞满长句即失败 |
💡 关键直觉:表格的比较优势是横向对位——读者眼睛能沿一列扫下来。没有"对位比较"需求的表格,都是被滥用的表格。
对齐冒号速记图
本节要点回顾
- 三行起步:表头、冒号分隔行、数据行;表格前后留空行。
- 冒号定对齐:数字列右对齐是纪律。
- 单元格不支持块级语法,换行用 HTML 换行标记,塞不下就拆结构。
- 表格的本质价值是对位比较,没有对位需求就换列表或图。
表格的宽度与排序纪律
表格最常见的失守是列数失控。一张表超过五列,移动端渲染直接横向溢出,读者左右滑动才能看全一行——对位优势荡然无存。治理办法是砍列:一列的价值问一句"读者会比较它吗",答案是否定的列删掉或移到说明文字里。行数同样要设上限:超过二十行的长表,读者扫不了全貌,正确做法是按某列排序后截断为"前十佳",其余折叠进附录或按需给出的完整数据文件。排序本身承载信息——性能表按性能降序、成本表按成本升序,读者从第一行就能拿到结论;不排序的"录入顺序表"等于把整理工作甩给了每一位读者。
列的口径一致性是更深一层的纪律。同一列里"快、很快、极快"这种模糊量级并排出现,比较就失效了;要么统一为测量数值(带单位),要么统一为同一组离散档位并在表前声明档位含义。单位必须写进表头而不是每个单元格里重复——"延迟(毫秒)"一处写清,全列干净。还有个团队协作里高频的争议:表头用中文还是英文、全角还是半角,这类问题没有唯一答案,但一篇文档内必须唯一。混用口径的表格在评审时最消耗注意力,规范的事交给第 6 章的军规统一。
表格的写作顺序也有讲究:先定表头,再填行。表头是表格的"接口"——定下"维度、数值、单位"三列后,每一行只是机械补数据;反之先随手记几行数据再回头凑表头,经常发现某几行口径对不上,返工量更大。复杂表动手前先在草稿里只写表头与两三行样例,确认列的划分符合读者的比较意图后再补全。另一个高效习惯是给宽表配"首列锚定":把读者用来定位的那一列(名称、日期、ID)放最左,其余列按重要性从左到右递减,读者视线沿首列下滑、需要细节时右移,扫读路径最短。
多平台迁移时还有两条实操经验。其一,管道表对单元格里的 | 极其敏感,哪怕在行内代码里也要写成 \|,从 Excel 粘贴过来的数据里若含竖线(常见于"B2|C3"这类坐标),批量替换成全角竖线或斜杠最省心。其二,需要复杂表头(多级表头、合并单元格)时不要在 Markdown 里硬凑——标准表格语法根本没有这些能力,多层表头的正确去处是 HTML 表格或直接改设计:把两级表头拆成两张单级表,往往比合并表头更易读。判断标准始终是读者的比较路径,而不是数据在源系统里的原始层级。
下一节看两个"状态型"小语法:删除线与任务列表。
从需求到成表:一次完整走查
用一个真实场景把前面的纪律串起来。需求:给团队周报对比三个缓存方案。第一步定读者比较路径——读者关心延迟、内存占用、接入成本三件事,表头就此定为三列加方案名;第二步定口径——延迟统一写 P99 毫秒(测量值),内存写每万键占用兆字节,接入成本用"小时数"而非"简单/中等";第三步排序——主场景是低延迟服务,按延迟升序;第四步补脚注——某方案内存数据是在禁用压缩下测的,这个测量条件只对复核者重要,下脚注而不是挤进单元格。成表如下:
| 方案 | P99 延迟(ms) | 内存(MB/万键) | 接入(人时) | | --- | ---: | ---: | ---: | | heap-lru | 0.4 | 96 | 2 | | redis | 1.8 | 41 | 6 | | sqlite | 7.3 | 18 | 4 |
走查里最值得体会的是第四步:测量条件下脚注这个动作,让表格保住了"每个单元格一个数字"的干净,同时不丢失复现实验所需的信息。