4.1 CommonMark:语法的共同底线
4.1 CommonMark:语法的共同底线
CommonMark 是一份对基础 Markdown 语法的精确定义规范,含六百多条可执行的测试用例。它回答的问题很朴素:同一段输入,所有解析器必须产出同一段 HTML。听起来天经地义,但在它出现之前,恰恰做不到。
一段历史:为什么需要规范
2004 年原版 Markdown 只有一篇说明文章,很多边界情况没写清楚——"列表里的引用块怎么缩进""星号离文字多近才算强调"。各家解析器作者只能自行发挥,结果就是:换一个工具,文档就微妙地变形。
2014 年前后,两位开发者发起 CommonMark 项目,做法很工程化:把每个语法点写成输入与期望输出的成对测试,任何声称兼容 CommonMark 的解析器都要跑通这套测试。规范至今仍在缓慢演进,它成了后来几乎所有主流实现的底座。
CommonMark 精确定义了什么
我们前两章练过的基础语法,几乎全部在它的管辖范围内:
| 语法 | CommonMark 态度 |
|---|---|
| 标题、段落、强调 | 精确定义(含 Setext 下划线式标题) |
| 列表与嵌套缩进 | 精确定义(这也是它测试用例最密集的区域) |
| 代码块(围栏与缩进式) | 精确定义 |
| 链接与图片 | 精确定义(含引用式定义) |
| 块引用、HTML 混写 | 精确定义 |
| 表格、删除线、任务列表 | 不在规范内(GFM 扩展) |
| 脚注、数学、图表 | 不在规范内(各家方言) |
两个"较真"的例子
体会一下"精确"到什么程度:
*苹果 **和 橙子** 是水果*
内层强调的起始符与文字之间的空格关系,决定了它到底渲染成什么——CommonMark 对这类情形给了明确答案,而旧解析器们答案各异。又如:
1. 第一项 2. 第二项 两段之间有空行的有序列表,起始数字会不会保留?
起始数字(比如从 3 开始编号)是否被尊重,规范也写死了(围栏内某些宽松列表语法被视为过时但兼容)。写文档不需要背这些细节,但知道"这些争议都有裁判"就够了。
💡 关键直觉:CommonMark 之于 Markdown,类似标准语法之于各地方言——你可以讲方言,但要心里有数:讲出标准语法的部分,走到哪都听得懂。
对写作者的实际意义
- 基础语法放心写:标题、列表、代码、链接在不同平台高度一致,这是 CommonMark 十年耕耘的成果。
- 排错有依据:渲染结果诡异时,可以判断是"解析器不合规"还是"语法本来就如此"。
- 极端可移植场景,把文档约束在 CommonMark 子集内(放弃表格任务列表),可以做到逐字节跨平台。
规范化前后的解析一致性
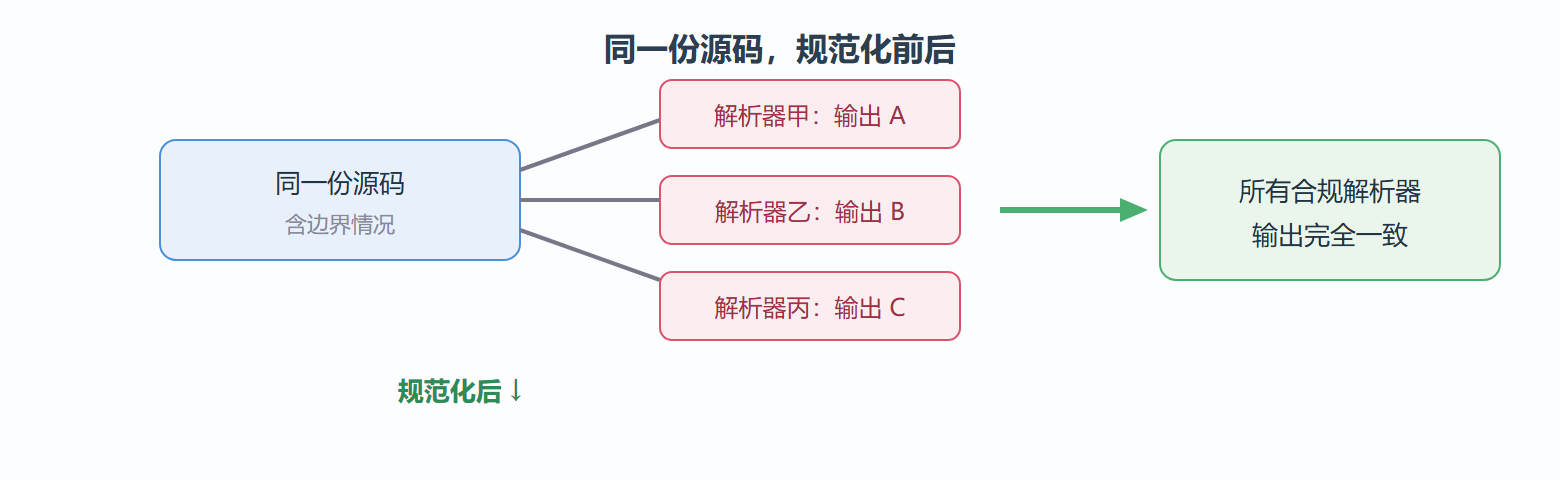
规范如何帮你判断"怪渲染"的责任方
CommonMark 的存在给排错带来一个质的改变:渲染异常第一次有了"对错"可判。判断流程是三步。第一步,把可疑片段精简到最小复现——删到只留出问题的两三行,这一步本身常常就暴露了病因(比如罪魁是一处看不见的全角空格)。第二步,查这段写法是否属于 CommonMark 管辖的基础语法:属于,则到规范或其在线演示环境跑一遍,规范环境渲染正确而你的平台不对,责任在平台的解析器(或它启用了非标准扩展覆盖了默认行为);规范环境与你的平台一致,说明语法本身就如此,改写文档即可。第三步,若写法属于扩展语法(表格、任务列表、脚注),那就不存在共同裁判,只能查目标平台自己的文档——这正是上一章"扩展语法要查方言"的原因。
团队协作里这套流程可以沉淀成一份"怪渲染登记表":每次遇到并判定完责任方的案例记一行——现象片段、所属语法层、结论(平台问题还是写法问题)、处理方式。三个月后这张表会覆盖团队环境的九成怪象,新人接手时先查表再排查,等于把 CommonMark 的"有裁判"延伸到了自家方言环境。规范的价值从来不是让所有人背下六百条用例,而是让"谁说了算"这个问题永远有答案:基础语法规范说了算,扩展语法目标平台说了算,登记表让后者也变得可查。
本节要点回顾
- CommonMark = 基础语法的精确规范 + 六百多条测试,2014 年起成为行业底座。
- 基础语法(标题/列表/代码/链接)跨平台高度一致,功劳在此。
- 表格、任务列表、脚注不在规范内,属于 GFM 与各方言。
- 极端可移植:把写作约束在 CommonMark 子集内可逐字节一致。
判定方言归属的实操流程
"这段渲染为什么怪"的第一步是判定语法归属哪一层,流程可以固化成一棵排查树:先问该语法在不在 CommonMark 规范里——标题、列表、代码块这些在,行为怪异基本是平台实现偏差,查平台已知问题清单;不在(表格、脚注、任务列表),再问是不是 GFM 内容——是,则多数互联网平台可用,怪象来自平台对 GFM 的取舍(比如某些平台禁用任务列表交互);也不是 GFM(数学、Mermaid、提示容器),那就是平台层方言,唯一权威是该平台自己的文档。三步走完,"怪渲染"从玄学变成有明确责任方的工程问题。
配合流程再记一组数字感受 CommonMark 的覆盖面:规范正文定义的基础语法约二十来种记号,配套测试六百五十余条;而生态里方言扩展总数上百。也就是说基础语法是被测试锁死的稳定区,扩展语法是各平台自留地——写作时把关键信息压在稳定区、扩展只做增强,是所有多平台策略的出发点,也是下一节 GFM 能成为"默认赌注"的原因。
规范测试集的用法:给工具做体检
CommonMark 的六百多条测试用例不只是规范附件,还是现成的工具体检包。怀疑某个渲染器行为怪异时,把对应特性的测试样例(规范网站按特性分类列出)喂给它,与规范给出的期望输出对照——一致说明怪象另有原因(多半是扩展或主题层),不一致则坐实实现偏差。团队引入新渲染工具前跑一轮抽样测试,把偏差条目记进内部已知问题清单,比上线后逐个踩坑的成本低一个数量级。这个习惯把"感觉这个工具不太标准"变成了"该工具在第 N 条测试上与规范偏离"的工程语言,讨论与决策都随之清晰。