5.2 渲染器与解析器:方言的执行者
5.2 渲染器与解析器:方言的执行者
解析器(渲染器)是把 Markdown 源码转成 HTML 的程序——第 4 章讲的方言差异,正是由它执行的。同一份源文件,换个解析器或换个配置,输出就能不同。理解"平台背后跑的是什么解析器",你就掌握了排查渲染问题的地图。
解析器在链路里的位置
你的源文件(.md) │ ▼ 解析器 ──→ HTML ──→ 浏览器/平台样式 ──→ 读者看到的页面 │ └── 配置项决定:允许哪些扩展、过滤哪些 HTML、如何处理换行
配置的权力比想象中大:同是 GFM 系解析器,一个开了脚注扩展、一个没开,你的脚注就一处在页脚一处在正文悬浮。平台上"某语法时灵时不灵",十有八九是解析器配置差异而非你的语法错误。
主流解析器速览
| 解析器(语言生态) | 方言立场 | 特点 |
|---|---|---|
| CommonMark 参考实现 | 严格 CommonMark | 规范的"标准尺" |
| cmark-gfm | GFM | 大型代码平台的内核 |
| markdown-it(JavaScript) | CommonMark + 插件 | 插件体系发达,前端产品常用 |
| remark(JavaScript) | 可组合 AST 工具链 | 文档工程的乐高 |
| Pandoc(Haskell) | 全家桶 + 开关 | 格式转换中枢(5.3 节主角) |
不必都会用,但要知道:查平台文档时搜"它用什么解析器、开了哪些扩展",比瞎试语法快十倍。不少知识库产品会在文档里直接写明"基于 markdown-it,支持以下扩展……"。
用解析器的眼光看三个老问题
为什么我的图没显示? Mermaid 与 SVG 围栏需要解析器配套相应插件渲染成图或图片;平台没配,围栏就只是普通代码块。这不是你写错了,是这条链路上缺一环。
为什么换行行为不一致? 解析器的 hardbreak/softbreak 配置不同——GFM 系单回车换行,严格 CommonMark 合并(4.2 节讲过的根源在此)。
为什么 HTML 被吞了? 解析器带了 HTML 白名单过滤(3.3 节),script 之类直接丢弃。
动手感受:同一个输入,两种配置
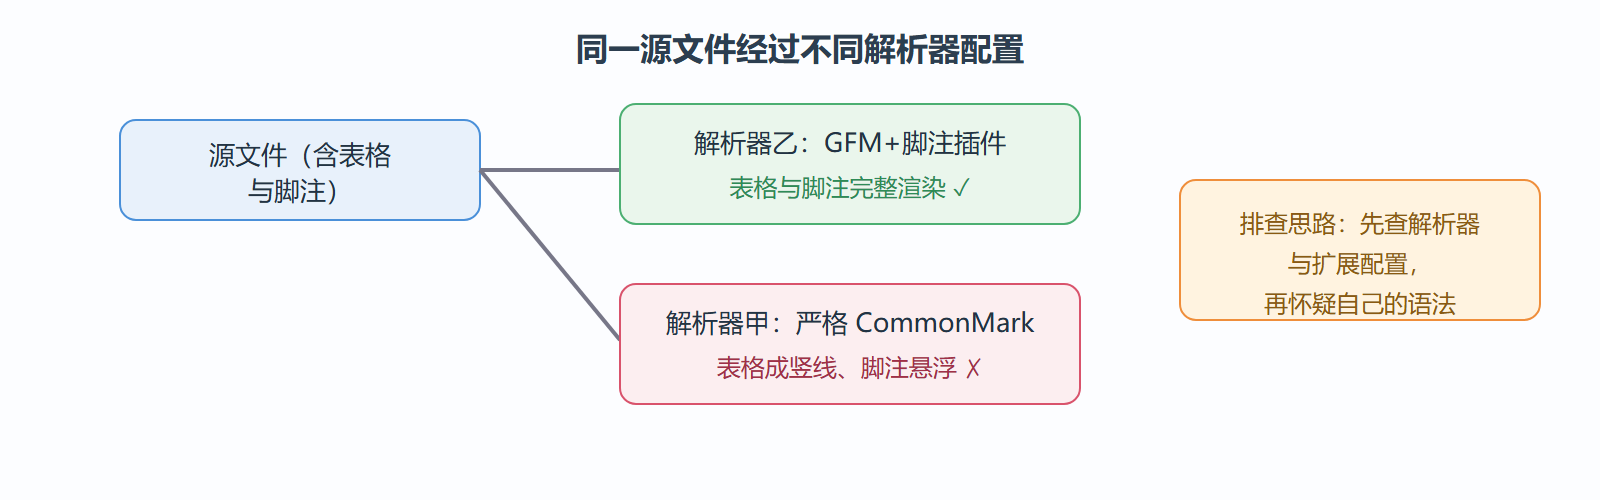
假设有解析器甲(严格 CommonMark)和解析器乙(GFM + 脚注插件),输入:
| 接口 | 状态 | | --- | --- | | 查询 | 已上线 | 这是术语[^1]。 [^1]: 注释内容。
甲输出:表格还原为竖线文字,脚注标记原样显示。乙输出:完整表格 + 页脚编号注释。源码一个字没改,结果天壤之别——这就是"解析器是方言执行者"的直观含义。
同源异构:解析器配置决定输出
⚠️ 常见坑:自己在本地装了个全功能解析器预览,效果惊艳;发布到平台(解析器配置保守)后大打折扣。预览环境要尽量贴近发布环境——能用平台的预览就别只用本地工具。
自建渲染管线的选型考量
当你不只是写文档,而是要给自己的产品或站点搭"输入 Markdown、输出页面"的能力时,就从选编辑器进入了选解析器的工程决策。考量有四层。第一层是方言立场:选严格 CommonMark 内核加按需插件,还是选 GFM 内核——取决于你的用户主要从哪里把文档搬进来,从代码仓库搬进来就选 GFM 系。第二层是扩展机制:以插件生态著称的解析器能让你按需开脚注、图表、数学,每个扩展是独立升级的模块;单体式解析器功能齐全但升级牵一发动全身。第三层是安全:渲染用户提交的内容必须配置 HTML 白名单过滤,这一项没有商量余地——第 3 章讲过的过滤逻辑,在你自建管线时就是你自己要配的责任。第四层是性能与确定性:高频渲染的服务要关注解析耗时,而"同一输入永远同一输出"的确定性关系到缓存有效性。
还有一条容易被低估的工程经验:把解析器版本也当依赖锁定。解析器的小版本升级可能改变边界行为的裁决(毕竟是实现方言的程序),你的文档站某天渲染突然微妙变化,查半天发现是依赖自动升了级——把解析器与扩展插件全部写进锁文件,升级变成显式决策,配合一组语法样张(4.2 节的体检样张)做升级前回归,渲染输出就从"随缘"变成"受控"。
本节要点回顾
- 解析器 = 方言的执行者,配置项(扩展开关、HTML 过滤、换行语义)决定输出。
- 查平台用什么解析器、开了哪些扩展,是渲染排错的第一动作。
- 图表、换行、HTML 三大疑难都能追溯到解析器配置差异。
- 预览贴近发布环境,避免本地惊艳、上线翻车。
认识解析器的两条主脉络
生态里的解析器虽多,理清两条脉络后就能举一反三。第一条脉络是 CommonMark 系:marked(快、浏览器可用)、markdown-it(VS Code 与无数站点在用、插件生态最全)、cmark-github(GitHub 官方、GFM 的参考实现)——这一系的差异主要在扩展加载方式,基础行为高度一致。第二条脉络是 Pandoc 系:单体覆盖数十种输入输出格式,扩展靠开关,学术与出版场景统治级。选型口诀由此而来:网页与工具链用 markdown-it 系,文档转换用 Pandoc,想与 GitHub 行为完全一致就上 cmark-github。遇到新平台,先问"背后是哪一家",答案出来,它的方言脾气、已知怪癖、可配开关就都能从对应主家的文档里查到——这就是"解析器是方言执行者"的实战含义:认主家,胜过背平台清单。
亲手感受解析器差异的五分钟实验
理论讲再多不如亲手跑一次对照。用同一段"故意含坑"的文档(含紧贴标点的强调、词内下划线、--- 紧贴文字、GFM 表格各一处),分别丢进 VS Code 内置预览、GitHub 页面、以及 markdown-it 的在线演示页,三处输出并排截图。你会直观看到:VS Code 预览对词内下划线的处理与 GitHub 不同、表格在非 GFM 渲染器里退化成文字、Setext 标题误判在哪家出现。这组截图建议存进团队 wiki 当"方言差异标本",之后任何人问"为什么这里渲染不一样",甩标本比讲原理有效十倍。五分钟实验换来的是整个团队对"解析器决定输出"的具象共识。