6.3 渲染原理:从文本到 HTML
6.3 渲染原理:从文本到 HTML
解析器处理一份文档分两个阶段:先把源码切成块级结构,再在每个块内解析行内记号。这个"先块级行内"的顺序解释了你在前五章遇到过的大部分怪现象——为什么列表里的段落要缩进、为什么星号在代码块里失效、为什么嵌套规则那么挑剔。知其所以然,排错就不用猜。
第一阶段:分块
解析器逐行扫描源码,把文档切成互不重叠的块:
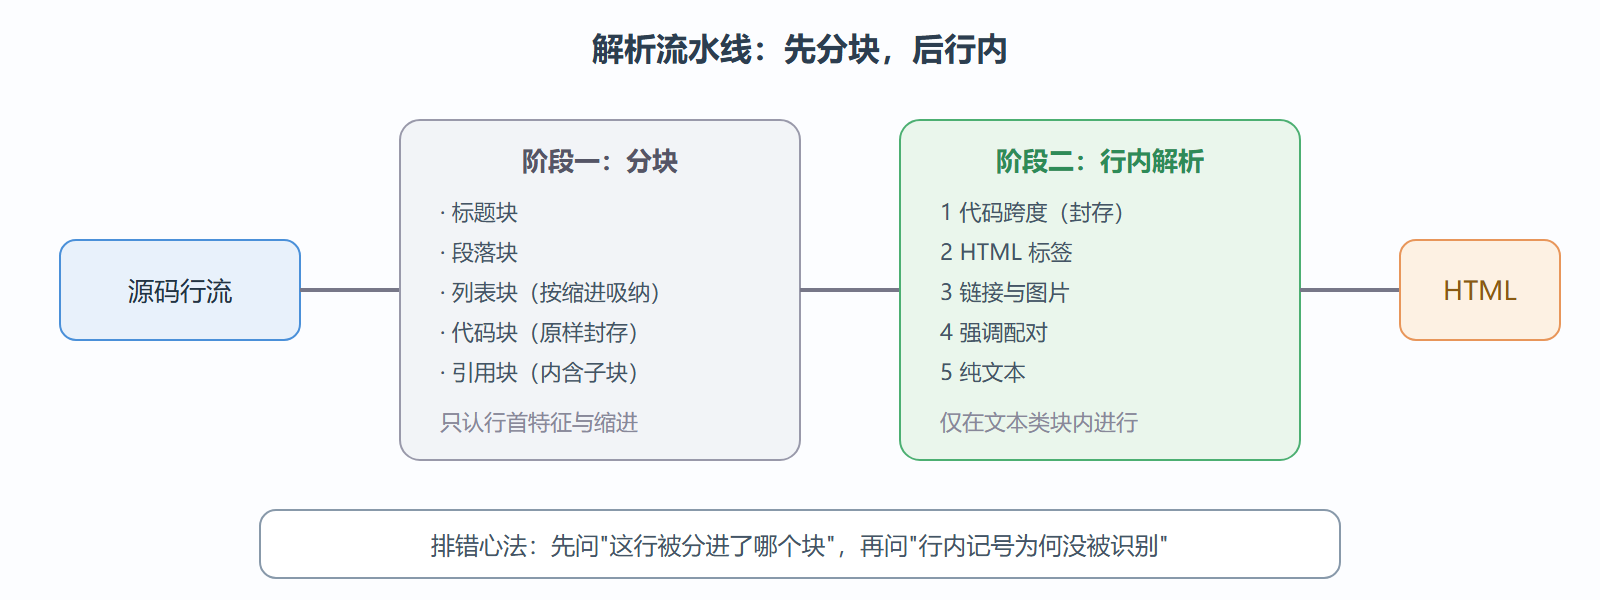
源码行流 ├── 空行 → 块边界信号 ├── 井号行 → 标题块 ├── 列表标记行 → 列表块(内容可继续吸纳后续缩进行) ├── 围栏反引号行 → 代码块(原样保留直到闭合) ├── 大于号行 → 引用块(内含子块) └── 其他 → 段落块(直到空行)
关键认识:分块只认行首特征。一旦某行进入代码块,它后续内容不再参与任何识别——这就是为什么代码块里的星号井号都安好。反过来,列表块的"吸纳规则"(缩进对齐 1.3 节)之所以挑剔,是因为解析器要用缩进判断"这行属于列表项,还是一个新的顶层块"。
第二阶段:行内解析
块切好后,解析器在每个文本类块内部(段落、标题、列表项文字)解析行内记号,而且是有顺序的:
行内处理顺序(大致) 1. 代码跨度(反引号)优先——内容立即免疫后续一切 2. HTML 标签与实体 3. 链接与图片(方括号结构) 4. 强调(星号/下划线,按配对规则) 5. 剩余纯文本
顺序解释了一个经典现象:行内代码里的链接不生效、代码里的星号不变斜体——因为代码跨度在第一优先级就被"封存"了。也解释了转义反斜杠的时机:它在最早期把字符变回字面量,后续所有环节都跳过它。
用原理回看三个老问题
问题一:列表项的第二段为什么必须缩进? 分块阶段,解析器看到未缩进的行,判断为顶层新段落,列表块就此关闭——缩进让它识别为"仍属于列表项内容"。
问题二:为什么 *文字* 有时不生效? 行内阶段有"左边界/右边界"规则:星号与文字之间、星号与外侧标点之间的空格关系决定它是否算强调定界符(4.1 节的例子)。中文标点紧贴星号时的行为,各解析器历史上分歧最大。
问题三:为什么 HTML 块内的 Markdown 失效? 分块阶段块级 HTML 被整体识别为原始块,根本不进入第二阶段的行内解析——除非解析器实现了"块级 HTML 内恢复 Markdown"的扩展(3.3 节空行技巧的由来)。
两阶段解析流程图
这套原理对写作的指导
- 块级问题查行首与缩进(列表断裂、段落合并、表格不识别),行内问题查定界符边界(星号失效、链接变文字)——两类症状两套药方,别混着试。
- 想让内容免疫解析,用代码块或行内代码,它们在流水线里被最优先封存。
- 嵌套结构的本质是块包含块,缩进就是在告诉分块器"我属于上面那个块"。
原理的三次方应用:解析树直觉
两阶段之上还能再建一层直觉:解析器眼里没有"文档",只有一棵块级树。顶层是若干块(标题、段落、列表、代码块),列表块内部又是子块(列表项,各自可含段落、代码块),引用块同理。渲染怪象几乎都能翻译成"你写的行落在了树上错误的位置":列表第二段没缩进,等于把新段落挂到了树的顶层而不是列表项下;表格前少了空行,表格行被吸纳进上一段落的文字流,树上根本没有表格节点。学会在心里把文档画成树,排错就从"试各种改法"变成"查这行挂在哪"。
这个直觉还有一个建设性用途:规划复杂嵌套时从树往下设计,而不是从行往上试。想在列表项里放代码块,先想清楚目标树形——列表项节点之下挂代码块节点,再翻译成写法(代码块围栏随列表项缩进);直接上手敲,多半在缩进上反复碰壁。同样的道理反过来解释了为什么"太深的嵌套是坏味道":树深超过三层(文档、列表、列表项里的引用块再含列表),分块器的归属判断就进入各实现分歧最大的地带——第 1 章劝你少嵌套,原理层的理由在这里。树直觉是把本章原理、前五章语法与第 4 章方言差异串成一根线的那个结:语法是树的书写形式,方言是树的裁剪规则分歧,排错是查树上的节点挂错了地方。
本节要点回顾
- 两阶段:分块只认行首特征与缩进;行内解析按"代码 → HTML → 链接 → 强调"优先级。
- 代码块免疫一切,因为它在最早阶段被封存。
- 块级症状查行首,行内症状查定界边界——排错的第一分流。
- 嵌套 = 块包含块,缩进是归属声明。
用渲染原理解释三个经典怪象
拿两阶段模型当透镜,三个流传甚广的"玄学"立即有解。怪象一:列表里的代码块失效——缩进式代码块要求四空格,列表项内容列起算后需要补足父项缩进再加四空格,少一层就只是普通段落;这解释了"为什么列表里的代码块怎么缩进都不对"。怪象二:强调记号紧贴标点失效——行内解析对定界符两侧的字符类型有规则(见 1.2),全角标点在部分实现里被当标点也可能被当文字,行为就不稳定。怪象三:链接文字里的方括号毁掉整个链接——行内解析先处理链接再处理强调,一个未转义的 ] 让链接解析提前终止,后面所有记号全部错位。三个怪象的共同教训:块级怪象先数缩进,行内怪象先查定界符两侧——这就是把渲染原理当作排错导航的用法。
动手观察:渲染中间产物
理解渲染原理最直接的办法是看中间产物。拿 VS Code 预览举例:装一个"显示渲染 HTML"的开发者工具(或直接在浏览器预览页按 F12 检查元素),找到某个列表对应的 DOM 结构,亲眼看到 <ul><li> 的嵌套与源码缩进的对应关系、看到引用块变成 <blockquote> 内嵌 <p>。再对比"懒续行"写法生成的 DOM——引用块内部结构与逐行 > 写法完全一致,就明白为什么两种源码渲染相同。十分钟的开发者工具之旅,胜过十页原理解读:抽象规则一旦落到亲眼所见的标签树上,就再也不会忘,排错时你脑中有一张从字符到标签的完整地图。
行内解析顺序的验证实验
"代码 → HTML → 链接 → 强调"这条优先级可以亲手验证:写一行 <b>*text*</b> 与一行 `*text*`,前者输出加粗但星号仍被强调处理(HTML 标签外的记号照常解析),后者星号原样保留(行内代码封存一切)。再写 [**链接文字**](url),链接文字里的加粗成立——说明链接解析先于强调却又保留了内部上下文。三个小实验把抽象的"优先级"变成具体的预期,之后遇到任何行内怪象,先按这条流水线推演一遍输出,再对照实际渲染,差异点即问题所在。理解了解析器的世界观,你就再也不是在与格式搏斗,而是在与一台行为完全确定的机器合作。