1.1 什么是Linux:从一次生产事故说起
1.1 什么是Linux:从一次生产事故说起
本节摘要:Linux 是一个以内核为核心的操作系统生态,内核管理 CPU、内存与设备,发行版在内核之上组装工具链与包管理。本节从一起"把正常服务器当成中毒机器"的真实事故切入,讲清内核、系统调用、发行版的分层关系,以及为什么服务器领域几乎被 Linux 垄断。
事故现场:一台"中了毒"的服务器
先讲一个我亲眼见过的事故。一家电商公司的促销活动前一晚,运维群里炸了锅。新入职的同事小王被安排检查一台备用的应用服务器,他远程连上图形控制台,看到的是一个黑色屏幕上一行行滚动的白色字符,没有桌面,没有图标,鼠标点哪儿都没反应。他的第一反应是:这台机器中毒了,而且毒得不轻,连桌面都被破坏了。
他做了什么?他在这台机器上跑了 Windows 时代的思维定势下的动作——尝试重启,没反应;尝试再多等一会儿,还是黑屏滚字。于是他在群里发了句"3 号机疑似中病毒,建议重装系统"。带他的老运维看到这句话,隔着屏幕都能感觉到血压升高。因为那台机器不是中毒了,它正在正常地往控制台输出启动日志——那是一台按公司标准装的最小化安装的服务器,压根就没有桌面环境,黑屏滚字就是它本来的样子。真正的问题不是机器,而是小王的认知模型里没有"没有图形界面的服务器"这个类别。
这个事故没有造成直接损失,因为老运维及时拦住了"重装系统"的建议——那台机器上跑着次日促销要用的降级预案服务,真重装了才是事故。但它暴露了一个普遍问题:很多人对 Linux 的理解是碎片化的,知道它存在,知道它免费,知道命令行很厉害,但从来没建立过一个完整的认知模型。没有模型,遇到不符合预期的现象就只能瞎猜。
这一节的目标就是把这个模型补上。我们从里到外拆:内核是什么、系统调用为什么是边界、发行版到底"发行"了什么,最后回答那个统计数字背后的原因——为什么全球绝大多数服务器跑的都是 Linux。
一、内核:整个系统的发动机
Linux 这个词,严格来说只指内核。1991 年 Linus Torvalds 发布的第一个版本只有大约一万行代码,做的事情也很纯粹:管理 CPU 时间、管理内存、驱动硬件设备、给上层程序提供一组统一的调用接口。三十多年过去,内核已经超过两千万行代码,但这四件事仍然是它的核心职责。
用一个具体的场景来理解。你在服务器上同时跑着一个数据库、一个 Web 服务和一个日志收集程序,三个进程都觉得自己独占着 CPU 和内存。这个"觉得"就是内核制造的幻觉:内核用调度器把 CPU 时间切成毫秒级的小片,轮流分给各个进程;用内存管理单元给每个进程一套独立的虚拟地址空间。进程之间互不干扰,不是因为它们素质高,而是因为内核在底层强制隔离。
我们可以直接观察到这个调度行为。在任意一台 Linux 机器上执行:
top -b -n 1 | head -15
输出类似这样:
top - 22:41:07 up 46 days, 3:12, 1 user, load average: 0.08, 0.03, 0.05 Tasks: 112 total, 1 running, 111 sleeping, 0 stopped, 0 zombie %Cpu(s): 0.3 us, 0.1 sy, 0.0 ni, 99.6 id, 0.0 wa, 0.0 hi, 0.0 si MiB Mem : 3897.0 total, 2450.3 free, 812.1 used, 634.6 buff/cache PID USER PR NI VIRT RES SHR S %CPU %MEM COMMAND 2381 mysql 20 0 1794.6m 512.4m 12.1m S 0.3 13.2 mysqld 942 www-data 20 0 148.2m 24.6m 8.3m S 0.1 0.6 nginx
这几行输出里全是内核工作的痕迹:load average 是内核调度器眼里的负载画像,多个进程能同时列出来说明分时调度在起作用,每个进程有独立的内存占用数字说明地址空间隔离在起作用。你不需要现在读懂每一列——第 2 章会专门讲负载排查——这里只需要建立一个直觉:你看到的每个数字,都是内核某个子系统对外暴露的窗口。
再看内核本身的信息:
uname -r
5.15.0-91-generic
这就是当前内核版本号。5.15 是主版本线,后面是发行版自己打的补丁编号。生产环境排查某些疑难杂症(比如某个系统调用行为异常)时,确认内核版本是标准动作之一,因为不同内核版本的行为差异可能很大。
⚠️ 常见坑:把"Linux 系统出问题"笼统地当成"内核出问题"。绝大多数故障跟内核无关,是用户态的配置、权限、磁盘空间这些层面的事。真正需要动内核的场景(升级、调参数)在运维生涯的前几年极少遇到。
二、系统调用:一切用户程序的边界
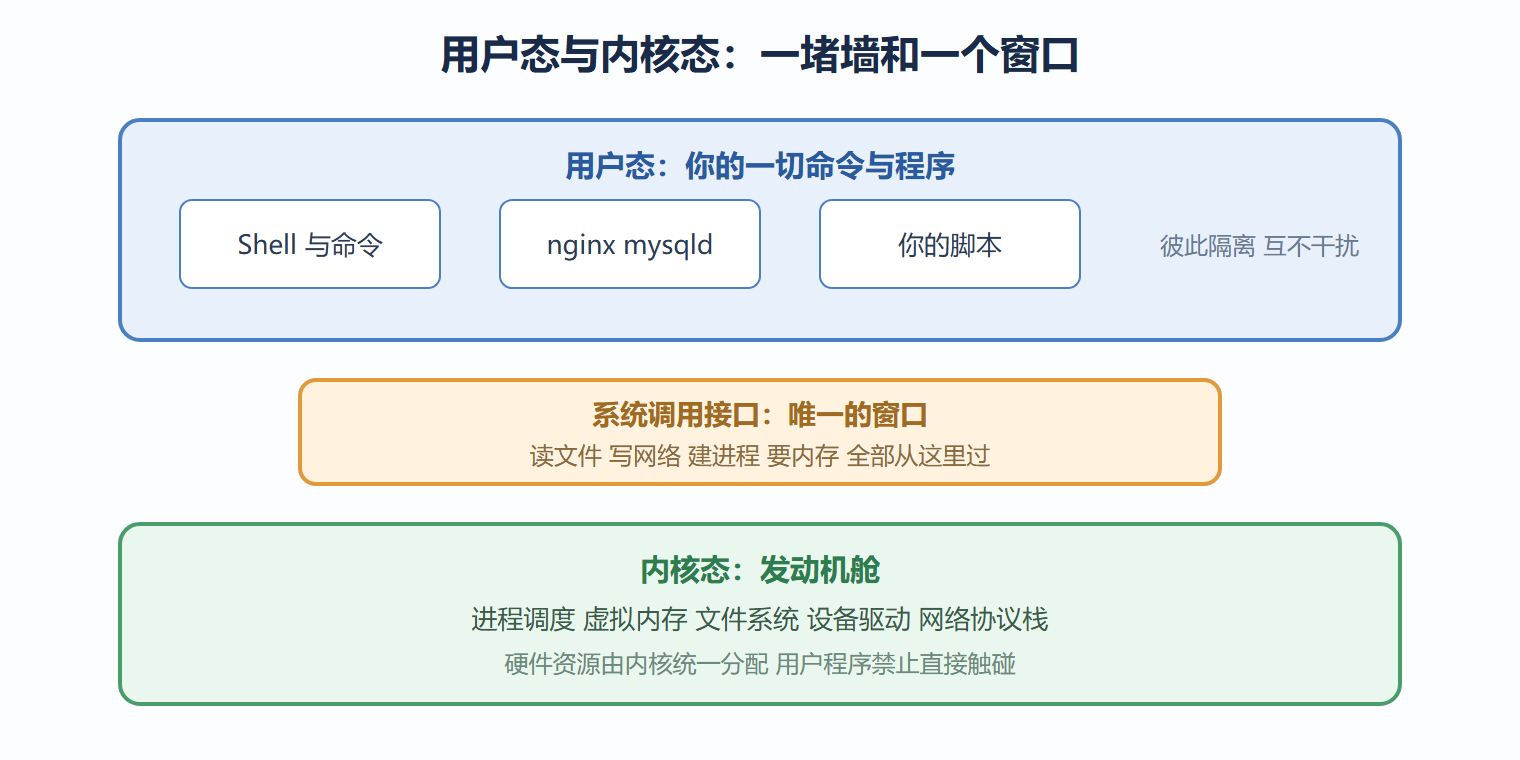
内核很重要,但你写的程序、你敲的命令,都不能直接碰内核里的数据结构。它们只能通过系统调用这个唯一的窗口请求内核办事。打开文件、读写网络、创建进程、申请内存,全都是系统调用。
这个设计是理解很多运维现象的钥匙。举个例子:进程"打开文件"时,内核返回的是一个文件描述符——一个小整数。后续的读写都用这个小整数指代文件。你可以亲眼看到:
ls -l /proc/self/fd
total 0 lrwx------ 1 root root 64 Aug 16 22:43 /proc/self/fd/0 -> /dev/pts/0 lrwx------ 1 root root 64 Aug 16 22:43 /proc/self/fd/1 -> /dev/pts/0 lrwx------ 1 root root 64 Aug16 22:43 /proc/self/fd/2 -> /dev/pts/0
0、1、2 这三个描述符就是 Unix 世界最著名的惯例:标准输入、标准输出、标准错误。命令行里所有关于管道、重定向的魔法,本质都是在动这三个描述符指向哪里。1.3 节会大量用到这个概念,这里先埋个种子。
系统调用还解释了一个经典故障:"Too many open files"。每个进程能持有的文件描述符有上限,这是内核的防滥用机制。跑着大量并发连接的服务(比如反向代理)经常撞上这个限制,报错就是这么直白。处理方法是调高限制并重启服务,具体操作属于第 4 章的治理范畴。这里想强调的是因果链:内核设限 → 进程撞限 → 服务报错。看到报错能立刻反应到"这是内核的描述符上限",排查方向就不会错。
用下面这张分层图把"内核—系统调用—用户程序"的关系固定下来,后面每一章都在这张图的不同楼层里活动。
图 1-1 内核与用户态的边界
三、发行版:同一个内核 一百种取舍
内核只是发动机,能开上路的整车是发行版。一个发行版 = 内核 + 一套用户态工具(命令行工具、系统库、初始化系统)+ 一个包管理器 + 仓库里成千上万个软件包。不同发行版的差异,本质上是对"给谁用、追求什么"这两个问题的不同回答。
主流阵营可以这么记:
| 阵营 | 代表 | 包管理 | 气质 |
|---|---|---|---|
| Debian 系 | Debian、Ubuntu | apt / dpkg | 生态最大,文档最多,上手友好 |
| Red Hat 系 | RHEL、CentOS Stream、Rocky、Fedora | dnf / rpm | 企业市场根基深,生命周期管理规范 |
| 独立系 | Arch、Gentoo、openSUSE | pacman 等 | 滚动更新或高度可定制,面向折腾爱好者 |
服务器场景下,Debian 系和 Red Hat 系占了绝对主流。选哪个 often 不是技术问题而是团队问题:团队里的人都熟 Ubuntu,那就用 Ubuntu;公司已有 RHEL 的订阅和审计流程,那就跟着走。发行版选型的最大成本不是系统本身,而是围绕它的运维经验积累。
小王那个事故的补救措施之一,就是团队给新人加了半天的"系统形态"培训,第一条就是:登录任何机器先看它是什么发行版。命令很简单:
cat /etc/os-release | head -4
NAME="Ubuntu" VERSION="22.04.4 LTS (Jammy Jellyfish)" ID=ubuntu VERSION_ID="22.04"
这台是 Ubuntu 22.04。换成 CentOS Stream 看到的 ID 就是 centos。排查问题去搜资料时,带上发行版和版本号搜索,命中率会高很多——同一件事在不同发行版上的做法经常不一样,比如防火墙前端、服务名、包名。
四、为什么服务器几乎全是 Linux
回到那个统计事实:全球绝大多数公共云实例和全部顶尖超算跑的都是 Linux。原因不是"免费"这么简单,可以从三个角度看。
第一,可裁剪。内核加上最小的用户态,可以塞进几百兆的镜像里,没有授权费、没有必须安装的组件。云厂商卖的是密度,一台物理机上塞的虚拟机越多越赚钱,每个实例底座越薄越好。Windows 的授权模式与组件重量在这件事上天然吃亏。
第二,可自动化。Linux 的一切配置几乎都是纯文本,SSH 加命令行就能完成全部管理动作,天然适合脚本化、批量化和后来的基础设施即代码。你可以用同一段脚本管一千台机器,这在图形界面为主系统上是噩梦。
第三,生态正循环。开发者用 Linux 桌面或容器环境开发,服务器自然也选 Linux,工具链无缝衔接;跑得越多,文档、问答、内核修复就越丰富;生态越丰富,新项目越倾向选它。这个飞轮转了快三十年,结果就是你今天看到的格局。
对运维新手来说,这个格局的直接含义是:学好 Linux 不是诸多选项之一,而是进入服务器运维领域的入场券。
常见疑问解答
学 Linux 必须先会用图形界面的发行版吗
不是必须,但我建议初学者至少在虚拟机里装一个带桌面的发行版玩两周。目的不是依赖桌面,而是降低心理门槛——能打开浏览器查资料、能图形化浏览文件系统,学习曲线会平缓很多。两周之后主动把桌面环境停用(1.2 节会讲怎么切回纯命令行),强迫自己全面转向终端。过渡期是糖,别把糖当饭。
Ubuntu 和 CentOS 我该先学哪个
先学哪个不重要,重要的是学透一个。两个阵营的命令行基础高度重合,差异集中在包管理和少部分工具的默认值上。我的建议是先用 Ubuntu 系:社区文档量大、报错信息搜起来命中率高、教程资源(包括本书)示例大多基于它。等一个阵营玩熟了,花一个周末在另一阵营做对照实验,理解"差异点在哪里、为什么要这样设计",比一开始就两头下注高效得多。生产环境用什么,最终跟着你服务的团队走。
内核需要自己编译吗
现代运维几乎不需要。发行版厂商维护着经过大量测试的内核包,通过包管理器升级即可。自己编译内核的场景——特殊硬件驱动、极致裁剪、内核开发——在前几年的运维生涯里大概率遇不到。你需要的是会看内核版本号、理解升级内核意味着重启、知道某些软件对内核版本有要求,这就够了。
“发行版停服”是什么意思 该担心吗
发行版的每个版本都有维护周期,到期后不再提供安全补丁。CentOS 8 曾经的提前停止维护就引发过一轮大规模迁移潮。判断要不要担心的标准很简单:你的生产系统用的版本还处在维护期内吗?定期检查这件事,是系统管理员日历上的固定动作,第 5 章讲包管理时会再遇到它。
本节要点回顾
- Linux 严格指内核:管 CPU 调度、内存隔离、设备驱动,是系统的发动机舱
- 系统调用是唯一窗口:用户程序读文件、写网络都要经过它,文件描述符是它的回执
- 0、1、2 三个描述符:标准输入、输出、错误的惯例,是后面管道与重定向的基石
- 发行版等于整车:内核加工具链加包管理器,选型跟着团队经验走
- 看清脚下是什么:读版本信息是登录陌生机器后的第一个动作
- 服务器垄断地位来自可裁剪、可自动化、生态飞轮,三者互相加固
下一节我们把系统真正装起来——装机路上的每一个默认值,都可能是半年后某个深夜故障的伏笔。