3.1 文件系统原理与挂载
3.1 文件系统原理与挂载
本节摘要:文件系统由超级块、inode 表与数据块三部分构成,inode 存元信息、数据块存内容,两者配额独立。"磁盘有空间却写不进文件"多半是 inode 耗尽。本节从这样一起事故复盘讲起,讲透文件系统内部结构,再讲挂载如何把存储接入统一目录树,以及挂载配置的读写方法。
事故现场:df 明明显示还有 200G
某个周一早晨,某公司的邮件服务大面积报错,用户发不出附件。运维登录服务器,第一反应是磁盘满了:
df -h /var
Filesystem Size Used Avail Use% Mounted on /dev/vdb1 300G 98G 202G 33% /var
还有两百G,空间充裕。但写入测试当场失败:
touch /var/spool/mail/testfile
touch: cannot touch '/var/spool/mail/testfile': No space left on device
报错坚持说没空间。值班同学盯着 df 的输出愣了几分钟,怀疑文件系统损坏,差点提出重建。旁边一位老运维看了一眼,换了个命令:
df -i /var
Filesystem Inodes IUsed IFree IUse% Mounted on /dev/vdb1 1.0M 1024k 3 100% /var
inode 用满了。这个分区的 inode 总量约一百万个,已经用掉百分之百。邮件服务每个用户的每封邮件都是一个小文件,几百万封小邮件把 inode 配额吃得干干净净——空间总量还有两百G,但"文件的户口本"一个都腾不出来了。
处置分两步走。先止血:找出占 inode 大头的目录清掉可删的旧邮件。定位命令用的是 2.4 节的 find 变体:
for d in /var/spool/mail/*; do echo "$(find "$d" -type f | wc -l) $d"; done | sort -rn | head -5
214301 /var/spool/mail/qa-notify 98220 /var/spool/mail/bot-alert 12043 /var/spool/mail/marketing 3301 /var/spool/mail/support 988 /var/spool/mail/hello
前两名是机器人和告警邮箱,二十几万封自动通知邮件,占掉三成 inode。清理后服务恢复。再治本:这个分区的邮件场景属于"海量小文件",mkfs 时的默认 inode 密度按通用负载设计,小文件场景应该在建文件系统时就调大 inode 数量。事后该分区重建时把每 inode 字节数调小了一档,同样容量多出近一倍 inode 配额。
这起事故是理解文件系统内部结构的最佳入口:空间和数据块有关,而"能不能创建文件"和 inode 有关——两本账,独立核算。
一、文件系统内部:三张桌子
把一个文件系统想象成三张桌子,一切就好懂了。
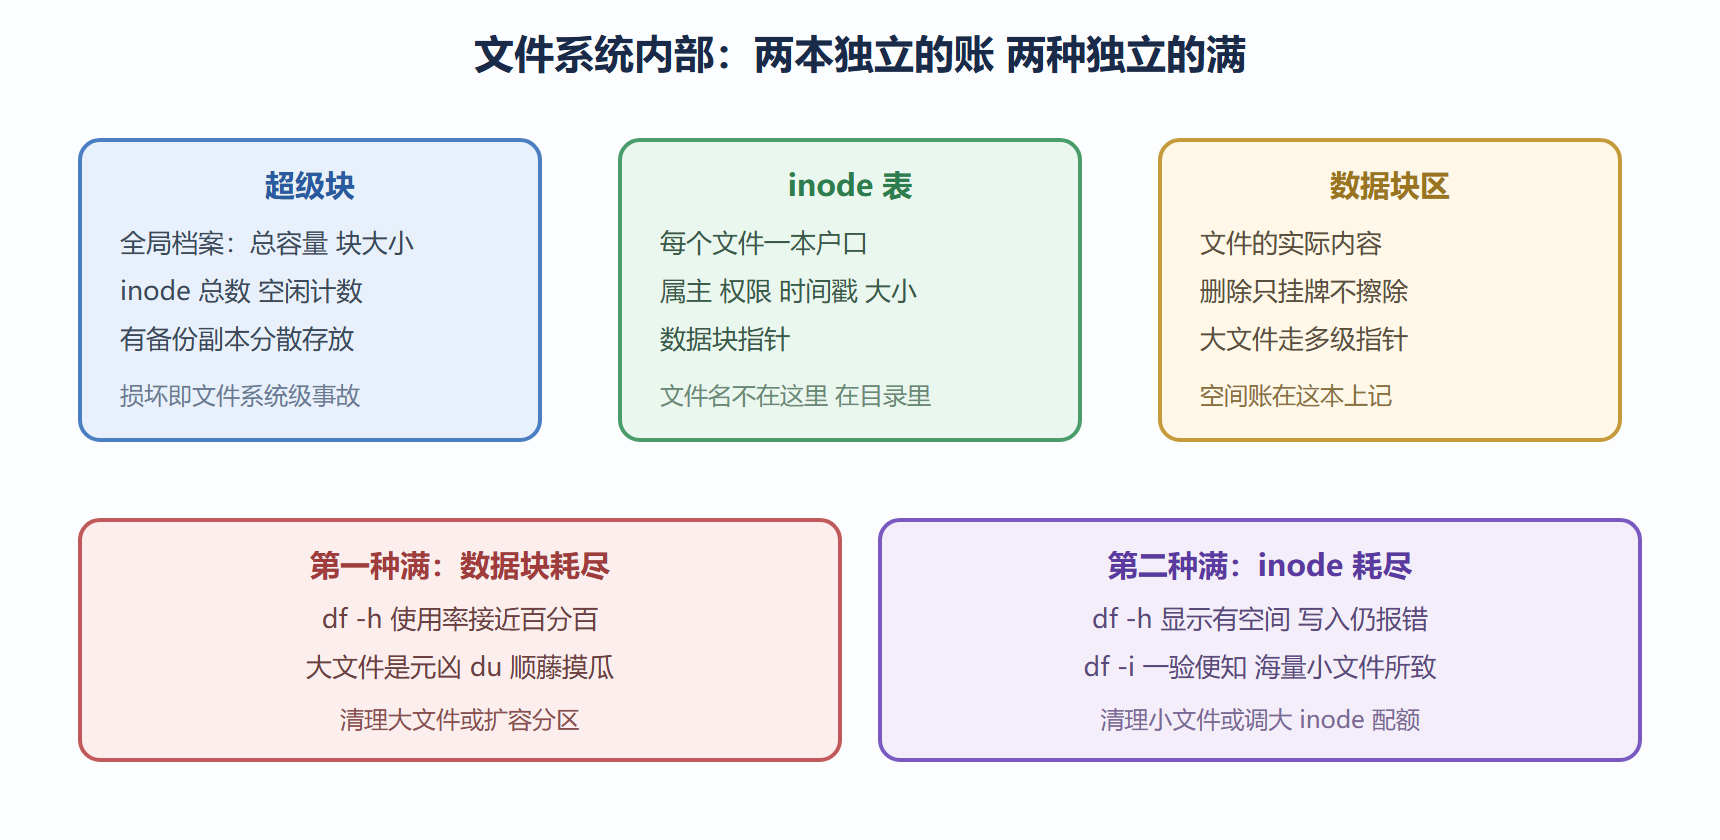
第一张桌子是超级块,存放整个文件系统的全局信息:总容量、块大小、inode 总数、空闲数量、健康状态。它是文件系统的"户口管理局档案"。系统启动挂载时第一个读的就是它,所以它通常还有备份副本散布在磁盘不同位置——超级块损坏是文件系统级的大事故,有了备份就有救。
第二张桌子是 inode 表。每个文件对应一个 inode,里面记着这个文件的一切元信息:属主、权限、三个时间戳、大小、以及指向数据块的指针。注意一个反直觉的事实:文件名不在 inode 里,文件名存在目录里。目录的本质是一张"文件名到 inode 编号"的对照表。
第三张桌子是数据块区,存文件的实际内容。inode 里的指针指到这里。大文件的指针有间接寻址的层级设计,细节不必深究,记住结论即可:文件越大,元数据结构越深。
三张桌子怎么协作?创建文件时,系统分配一个空闲 inode、写入元信息、在父目录的对照表里登记文件名、再分配数据块写内容。删除文件时顺序相反:目录对照表里除名、inode 标记回收、数据块标记可复用——注意数据块的内容并没有被擦除,只是"户口注销、房子挂牌"。2.1 节说删除可恢复的理论依据就在这里。
亲眼看一个文件的 inode:
stat /etc/hosts | head -4
File: /etc/hosts Size: 221 Blocks: 8 IO Block: 4096 regular file Device: fc01h/64513d Inode: 261 Links: 1
inode 编号、占用块数,都摆在明面上。再对照两个 df 的输出——一个看块配额、一个看 inode 配额——本章开头那张"空间故障速查卡"的三张面孔,你已经能解释两张了。
图 3-1 文件系统三桌结构与两种写满
二、挂载:把存储接进目录树
Linux 的目录树是逻辑结构,物理存储可以来自多个设备。挂载就是"把某个设备的内容接到目录树某个节点上"的动作——那个节点叫挂载点,通常是个空目录。你在根下看到的 /var 可能在一块独立的云盘上,/data 可能挂着一整列磁盘,目录树把这一切抹平成统一的路径体验。
看当前挂载布局:
df -hT
Filesystem Type Size Used Avail Use% Mounted on /dev/vda2 ext4 40G 23G 15G 61% / /dev/vdb1 ext4 300G 98G 202G 33% /var tmpfs tmpfs 2.0G 0 2.0G 0% /dev/shm
T 选项多显示了文件系统类型一列。这里根分区与数据分区都是 ext4,tmpfs 是纯内存文件系统——它的数据不落盘,重启即清空,适合放高速临时数据。主流类型速览:ext4 是多年默认,成熟稳健;XFS 是现在企业发行版的默认,擅长大文件高并发;两者选哪个都好,重点是别在同一套环境里混着换来换去。
手工挂载与卸载:
sudo mount /dev/vdb1 /var sudo umount /var
umount 报"目标忙"说明有进程正在使用挂载点下的文件,处理思路与 2.1 节"目录删不掉"相同:找到占用者再处理。强行卸载从不是选项。
三、开机自动挂载:配置文件逐列读
手工挂载重启即失效,持久化要写进挂载配置文件。这是 Linux 风格的又一例:一切都是文本配置。看两行样例:
/dev/vdb1 /var ext4 defaults 0 2 tmpfs /dev/shm tmpfs defaults 0 0
第一列设备,第二列挂载点,第三列类型。第四列选项 defaults 是一组常规选项的打包。第五列控制是否纳入备份转储,现代环境几乎都写零。第六列是开机检查顺序:根分区是一,其他数据盘是二,零表示不检查——检查能修文件系统小损伤,代价是开机变慢,数据盘写二让它在根之后被检查。
写完配置别急着重启验证——又是预演思想。有一条专门的验证命令,模拟开机挂载流程:
sudo mount -a
没有任何输出就是成功。这条命令会挂载配置里所有尚未挂载的条目,写错了当场报错。多少次"重启后起不来是因为挂载配置笔误"的事故,被这一条命令拦截在机房之外。
⚠️ 常见坑:配置文件里设备名写死成 vdb1 这样的内核名,云环境下加盘或重排后名字会漂移,机器直接进紧急模式。稳妥做法是用文件系统在格式化时生成的稳定标识——卷标或文件系统识别码——来引用设备,名字不随插槽变化。第 3.3 节新盘上线的完整流程里会演示。
四、挂载点上的一个经典陷阱
挂载会"遮住"挂载点下原有的内容。目录 /data 原本有文件,把一块新盘挂到 /data 后,原来那些文件看不见了——它们没丢,只是被新盘的根目录盖在下面。卸载后它们又回来了。这个现象解释了一类"诡异丢失":误在挂载前往挂载点目录写了一堆文件,挂载后找不到,急得团团转。
标准防范动作两条:挂载点目录保持空目录;确实需要先写文件的场景(比如数据迁移),记得卸载检查一次。理解"挂载是覆盖视角不是合并"这六个字,陷阱就不再是陷阱。
常见疑问解答
文件系统类型到底怎么选
普通服务器在 ext4 和 XFS 里选,闭眼选都对。有明确画像再细分:海量小文件、在意 inode 配额,ext4 可调空间大;大文件高吞吐(视频、备份仓库),XFS 表现更稳。从旧系统继承什么就用什么,迁移文件系统的收益通常撑不起风险。选型不是每天要做的决定,别在这上面消耗过多心力。
inode 配额平时要监控吗
要,但不必单独建体系——把 inode 使用率纳入现有磁盘监控同一个面板即可,阈值同样八成预警。inode 满的故障爆发极快(小文件增长是指数级的),等出事再查就晚了。2.3 节的体检三连可以顺手加一条带 i 选项的版本,成本一行,覆盖一个整故障类别。
修改挂载选项需要重启吗
多数选项重挂载即可生效:一条 remount 命令带着新选项重挂,不用停机。运行中的服务不受影响。真正要重启的场景极少,别把"改配置"和"重启机器"条件反射地绑定。
tmpfs 里的文件重启就没了 放什么合适
放"丢了能重建、速度要求高"的东西:应用缓存、会话临时数据、中间结果。千万别放任何需要持久化的业务数据——tmpfs 还占内存配额,塞大文件等于双重消耗。判断口诀一句话:能随时再生的,才配住内存盘。
五、观察一次完整的写入旅程
把三张桌子与挂载机制串起来,跟踪一次文件写入的完整旅程,作为本节知识的总装演练。你编辑一个配置文件按下保存:编辑器通过系统调用请求写入;内核的文件系统层先查目录树,定位文件的 inode;inode 里的指针找到对应的数据块位置;新的内容写入数据块(可能是新分配的块);更新 inode 里的三个时间戳与大小;最后把这一切的变更按策略落盘。在这个过程中,写入其实先进入内存中的缓存,由内核在合适的时机批量刷盘——这是性能优化的关键设计,也解释了断电为何可能损坏文件系统:内存里的变更还没落盘,机器就断了。日志式文件系统的革新正在于此:先把"我要改什么"记进日志区再动手改,断电后重放日志即可恢复一致性——5.3 节文件系统检查的底气就来自这套机制。理解这段旅程后,"为什么写文件会卡"(等刷盘)、"为什么断电要跑检查"(日志未完成)都有了因果答案。
💡 关键直觉:文件系统的一切设计都在"快"与"安全"之间走钢丝。缓存放宽了快但不安全,日志收紧了安全但慢一点。看到任何文件系统参数调优的文章,先问它在动钢丝的哪一端。
最后给想深挖的读者指几条路:文件系统的块组与分配策略、日志的几种模式与调优参数、以及不同工作负载下的基准测试方法,都值得在实际需要时再展开。本节给你的地图足够日常排错与容量规划使用;更深的层属于文件系统调优专题,等你的工作真的把你带到那一步——比如负责一个写入密集型的存储服务——再去啃也不迟。带着问题学深层知识,效率远高于预防性的深挖。
本节要点回顾
- 空间与 inode 是两本独立的账:写入报错但 df 有空间,先查 inode 使用率
- 文件名在目录里 元信息在 inode 里:目录是文件名与 inode 编号的对照表
- 删除是注销户口不擦房子:数据块挂牌可复用,这是恢复工具的理论基础
- 挂载是覆盖不是合并:挂载点下原内容被遮住,卸载即现
- 配置写完先模拟挂载:一条命令验证,避免重启进紧急模式
- 设备引用用稳定标识:内核设备名会漂移,卷标与识别号不会
下一节往文件之上走一层——是谁在管"这个文件谁能读、谁能写",以及那串神秘权限位的完整读法。