3.3 磁盘分区与故障处置
3.3 磁盘分区与故障处置
本节摘要:新盘上线要走分区、格式化、挂载、持久化四步,每一步都有对应的工具与验证动作;磁盘侧两大经典故障——已删文件不释放空间、文件系统变只读——各有标准处置流程。本节从一起"删了 50G 文件磁盘还是满的"深夜事故讲起,走完全部流程并给出巡检清单。
事故现场:删了 50G 磁盘还是满的
凌晨一点,某数据库服务器磁盘告警,值班同学登录检查,数据盘使用率百分之九十七。他很熟练地定位到最大的过期日志文件,删除:
rm /data/mysql/slow-query-202605.log
文件五百多G,删完松了口气。可再看 df:
df -h /data
Filesystem Size Used Avail Use% Mounted on /dev/vdb1 500G 485G 3.2G 97% /data
使用率纹丝不动。他删了第二次——文件已经不存在了。那一夜的恐慌值得每个运维经历一次(在测试环境):明明删掉了巨型文件,空间去哪了?
答案是:被进程占着。3.1 节讲过,删除只是把目录里的登记除名、数据块挂牌,但如果仍有进程打开着这个文件的句柄,内核认为文件还活着,空间不归还。数据库进程正开着那个慢查询日志的句柄。验证与定位:
lsof /data | grep deleted | head -3
mysqld 2431 mysql 38u REG 253,17 524288000 612 /data/mysql/slow-query-202605.log (deleted)
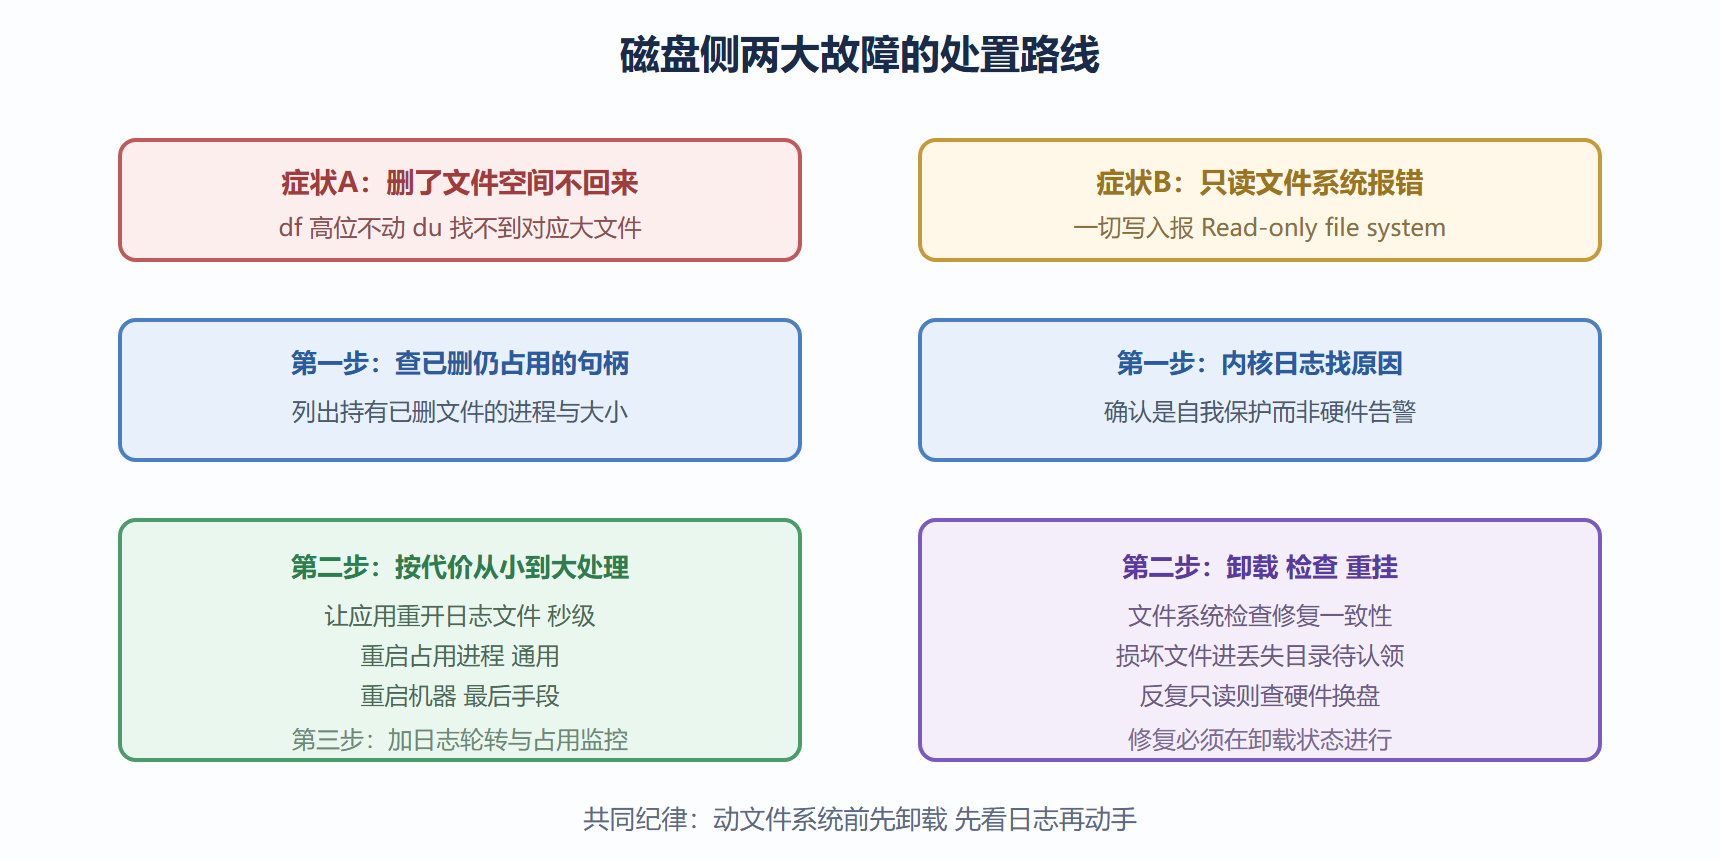
输出一目了然:mysqld 进程、进程号 2431,文件已删但仍被占用,句柄持着五百多G。处置方式按代价从小到大排:让应用主动关闭并重开日志文件(数据库有专门的日志刷新命令,最佳);重启占用进程(通用但影响服务);重启机器(最后手段)。这次用了第一种,秒级生效,df 立刻回落到百分之四十。
复盘改进:日志类大文件不该裸奔到这么大,轮转配置加上容量上限;监控里加一条"已删文件占用空间"的采集项,让这类隐患在白天现形。
一、新盘上线四步曲
云主机加了一块新盘,从零到能用,四步走完。第一步确认设备名:
lsblk
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT vda 252:0 0 40G 0 disk └─vda2 252:2 0 39G 0 part / vdb 252:16 0 500G 0 disk
新盘是 vdb,五百G,还没有分区(没有子节点)、没有挂载点。这里要复习 3.1 节的提醒:设备名可能漂移,接下来的命令里用它没问题,但持久化配置要用稳定标识。
第二步分区。现代工具一条命令交互完成,也有非交互的精准打法——指定起点与大小,机器可读、脚本可重放:
sudo parted /dev/vdb --script mklabel gpt mkpart data ext4 0% 100% lsblk /dev/vdb
NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINT vdb 252:16 0 500G 0 disk └─vdb1 252:17 0 500G 0 part
分区 vdb1 出来了。这里有个值得知道的细节:整盘做文件系统(不分区)也是合法做法,单一大数据盘常见;要多个分区或对齐习惯有要求就分区。GUID 分区表是现代默认,老式的主引导记录分区表只在兼容老系统时出现。
第三步格式化,建立文件系统。先给分区打卷标,卷标就是我们的稳定标识:
sudo mkfs.ext4 -L appdata /dev/vdb1
mke2fs 1.46.5 (30-Jan-2022) Creating filesystem with 131072000 4k blocks and 32768000 inodes Filesystem label: appdata ...
输出里的两个数字值得多看一眼:块数与 inode 数。3.1 节的 inode 教训在这里兑现——海量小文件场景,此刻就是调大 inode 密度的时机,格式化之后再想调就得重来。
第四步挂载并持久化:
sudo mkdir -p /data sudo mount LABEL=appdata /data df -h /data
Filesystem Size Used Avail Use% Mounted on /dev/vdb1 492G 24K 492G 1% /data
挂载成功,按卷标引用,不怕设备名漂移。然后把条目写进挂载配置,第四列开始同样用卷标,写完跑模拟挂载验证——3.1 节的完整闭环在这里完成。
⚠️ 常见坑:格式化与分区都是不可逆操作,敲回车前核对三件事——设备名是不是目标盘、有没有挂载点说明它正在服役、容量是不是预期值。核对的动作是再跑一次 lsblk。误格式化在役磁盘是运维行业最贵的手滑之一,防线永远在敲命令之前。
二、第二种经典故障:文件系统变只读
另一类深夜常客:写文件报错"只读文件系统"。这不是权限问题,是内核检测到文件系统不一致后,把它切到只读模式自我保护。诱因常见是底层存储抖动或异常断电。
确认状态与原因:
dmesg | tail -8
[ 8312.114] EXT4-fs (vdb1): error detected since last unmount [ 8312.120] EXT4-fs (vdb1): Remounting filesystem read-only
内核日志说得很直白:检测到错误,重挂为只读。处置是标准三步:能卸载就卸载(问一句谁在用,3.1 节的老朋友);跑文件系统检查修复;重新挂载。
sudo umount /data sudo fsck -y /dev/vdb1 sudo mount -a
fsck 的输出会列出发现并修复的问题,损坏的文件可能被挪进名为丢失加找到的目录等待人工认领。修复后服务恢复。两个提醒:检查必须在卸载状态下跑,挂载中强行检查等于边开车边换发动机;如果同一块盘反复进入只读,别再治文件系统了——查硬件与底层存储,反复的"不一致"是盘要坏的经典前兆。
图 3-3 磁盘故障处置决策树
三、巡检清单:让磁盘问题在白天现形
夜间故障的九成隐患白天都有征兆,巡检就是把征兆变成日常。磁盘巡检四项,每周一次足够。
第一项空间趋势:连续记录 df 使用率,算周增长率,推算到达阈值的时间——增长率突增比绝对值更值得警惕,业务没变而增长翻倍,一定有新东西在偷写。第二项 inode 使用率:本章开篇教训的直接落实,一条带 i 选项的命令。第三项大文件与增长点:du 与 find 的大户名单对比上周,新晋大户要能说出名字。第四项错误信号:内核日志里扫磁盘相关关键词,有硬件重试或超时记录就要提级处理。
四项全部可以写成脚本定时跑、结果落盘、异常才推送——2.3 节的体检脚本思路直接复用。巡检的自动化不是取代人,是把人从"逐台看数字"里解放出来,只处理异常项。
常见疑问解答
分区对齐是什么 还需要关心吗
老问题,现代工具默认已对齐,手工分区时用百分比指定起点就不会错。唯一要避免的是用古老的柱面单位指定起点。结论:知道有这回事即可,默认值可信。
磁盘用到多大该扩容
在监控里设两道线:八成预警、九成紧急。到达预警线就启动扩容计划,而不是等到紧急线再熬夜。扩容本身有停机或性能抖动的成本,留出从容的窗口期做演练,是容量管理的成熟标志。数据增长快的业务要按月评审增长率。
LVM 和直接分区 我该用哪个
服务器默认 LVM:空间可在线伸缩、快照能力对备份友好,多一层抽象换来的灵活性在故障与变更时兑现。学习环境或简单单盘场景,直接分区概念更少、排错更直接。这个选择在 1.2 节装机器时就该做完,事后改造成本高。
发现坏道或硬件报错 第一反应是什么
第一反应是确认备份的完整性——盘随时可能整体阵亡,数据安全优先于一切修复动作。然后收集硬件日志、联系供应商换盘,软件层面的修复工具只能延缓、不能治愈物理损伤。带病运行的盘是定时炸弹,处置越快损失越小。
四、扩容:数据盘长大的两种方式
业务增长后数据盘要扩容,云环境下有两条路。第一条是"换大盘":新买一块更大的盘,挂载到临时位置,用块级复制把旧盘数据整体搬过去,再改挂载配置指向新盘。整个过程可验证、可回退,代价是要搬运全量数据。第二条是"原地扩":云厂商支持在线扩大磁盘容量,之后对分区表与文件系统做扩展——分区表用工具改大小,文件系统用各自的扩容命令在线放大,ext4 与 XFS 都支持。原地扩快,但分区表操作风险高,必须先做快照。两条路的选择标准:数据量小用换盘(简单稳妥),数据量大用原地扩(快但要做足快照)。无论哪条路,先确认备份完整性再动手,这是磁盘操作的通用第一课——本节讲过的所有不可逆操作,备份都是唯一的全额保险。
顺带一个容易忽略的点:扩容后记得同步更新监控阈值与容量预测表。盘变大了,八成预警线对应的空间绝对值也变了,巡检基准不更新,容量管理就断档了。
磁盘话题收尾时,值得把视角拉高一层:单机的磁盘管理做得再好,也只是数据安全故事的一半。另一半是备份与容灾——重要数据必须有本机之外的副本,最好有异地的副本;备份必须定期做恢复演练,没验证过可恢复的备份只是心理安慰。磁盘故障处置的所有技能,目标都是减少损失,而备份的存在让最坏情况从灾难降级为事故。这是下一阶段的学习方向,本章先把地基打牢。
还有一个细节值得单独提醒:所有磁盘操作命令的输出都值得读,而不是只看最后的成功或失败。格式化输出里的块数与索引节点数、检查修复输出里的每一条修复记录、挂载输出里的容量差异,都是机器在向你汇报它的内部状态。养成读输出的习惯,你会在某次格式化时提前发现容量不对、在某次检查输出里看到反复出现的同一类错误——那时你会感谢自己读过这些滚动的文字。
本节要点回顾
- 删除不释放空间是句柄占用:列出持有已删文件的进程,让应用重开文件是代价最小的解
- 只读模式是自我保护不是故障本身:内核日志找原因,卸载后检查修复再挂载
- 新盘四步:看设备、分区、格式化打卷标、按卷标挂载并写入配置
- 格式化是调 inode 密度的唯一窗口:海量小文件场景此时决策
- 不可逆命令敲下前三核对:设备名 在役状态 容量,用 lsblk 复核
- 巡检把夜间故障搬到白天:空间趋势 inode 大户名单 错误信号,四项自动化
第 3 章收束。下一章把视角从文件拉到人——用户、组与 sudo,权限的治理层。
最后谈一个容易被忽略的配套话题:磁盘信息也要进配置管理。手工做过一次的分区、格式化、挂载配置,如果没有留档,半年后的紧急换机就是一场考古。值得记录的字段包括:设备与卷标映射、文件系统类型与创建参数(尤其是 inode 密度这类定制项)、挂载点与挂载选项、用途与负责人。一张表几个字段,换机、扩容、排障全都要回来查它。磁盘是硬件资产,它的配置信息同样是资产——3.3 节的全部操作动作,最终都应该沉淀成这样一张表。
再补一个云时代的观察:云盘的"物理故障"不再是你能摸到的那种坏道,而是表现为底层存储的静默降级——表现为偶发的高延迟、周期性的写入抖动。识别这类问题要看趋势不看单点:某块盘的写延迟连续几天缓慢爬升,而同宿主机其他盘正常,就该联系云厂商了。云把硬件问题抽象掉了,但没消灭它,只是换了身衣服。监控指标里的延迟分位数,就是识破这身衣服的工具,这也是磁盘巡检清单里"错误信号"一项在云环境下的新含义。