3.2 循环与效率:从 while 到缓存友好
3.2 循环与效率:从 while 到缓存友好
本节摘要:循环在机器上是"往回跳"——条件测试加一条向后跳转指令。理解这个形态后,死循环、边界差一、空语句陷阱都有了解释;更重要的是,循环是缓存性能的主战场:按内存顺序访问的循环与跳跃访问的循环,速度能差出几倍到几十倍。本节把循环的机器形态与缓存效应一次讲透。
循环的机器形态:往回跳
int sum(const int *a, int n) { int s = 0; int i = 0; while (i < n) { s += a[i]; i++; } return s; }
汇编骨架:
mov eax, 0 ; s = 0 mov ecx, 0 ; i = 0 .L1: cmp ecx, esi ; i 与 n 比较 jge .L2 ; 不满足则跳出 add eax, [rdi + ecx*4] ; s += a[i] inc ecx ; i++ jmp .L1 ; 往回跳,下一轮 .L2: ret
jmp .L1 这条向后跳转就是"循环"的全部秘密。for 与 while 在这个层面没有区别——for (int i = 0; i < n; i++) 与等价 while 生成完全相同的指令,选哪个只关乎可读性。do-while 倒有细微差别:它先执行后判断,只有一条条件跳转且在底部,编译器在确定循环体至少执行一次时会自动把 while 改写成这种"底部跳转"形态——又一条"写的代码不等于执行的代码"的证据。
三要素检查法(来自机器形态):初始化、边界测试、步进。缺任何一条,循环就失控。经典事故逐一对照:
/* 事故一:循环变量无符号,i >= 0 恒真,死循环 */ for (unsigned i = n - 1; i >= 0; i--) { ... } /* 事故二:分号多打一个,循环体是空语句,while 白转 n 次 */ int i = 0; while (i < n); i++; /* 事故三:条件里赋值,把 == 写成 = */ if (x = 0) { ... } /* x 被赋值为 0,条件恒假 */
事故三属于分支章,但与事故二同源:语法糖掩盖了机器动作。把 -Wall 打开,这三个都会被警告。
缓存:循环性能的真正主角
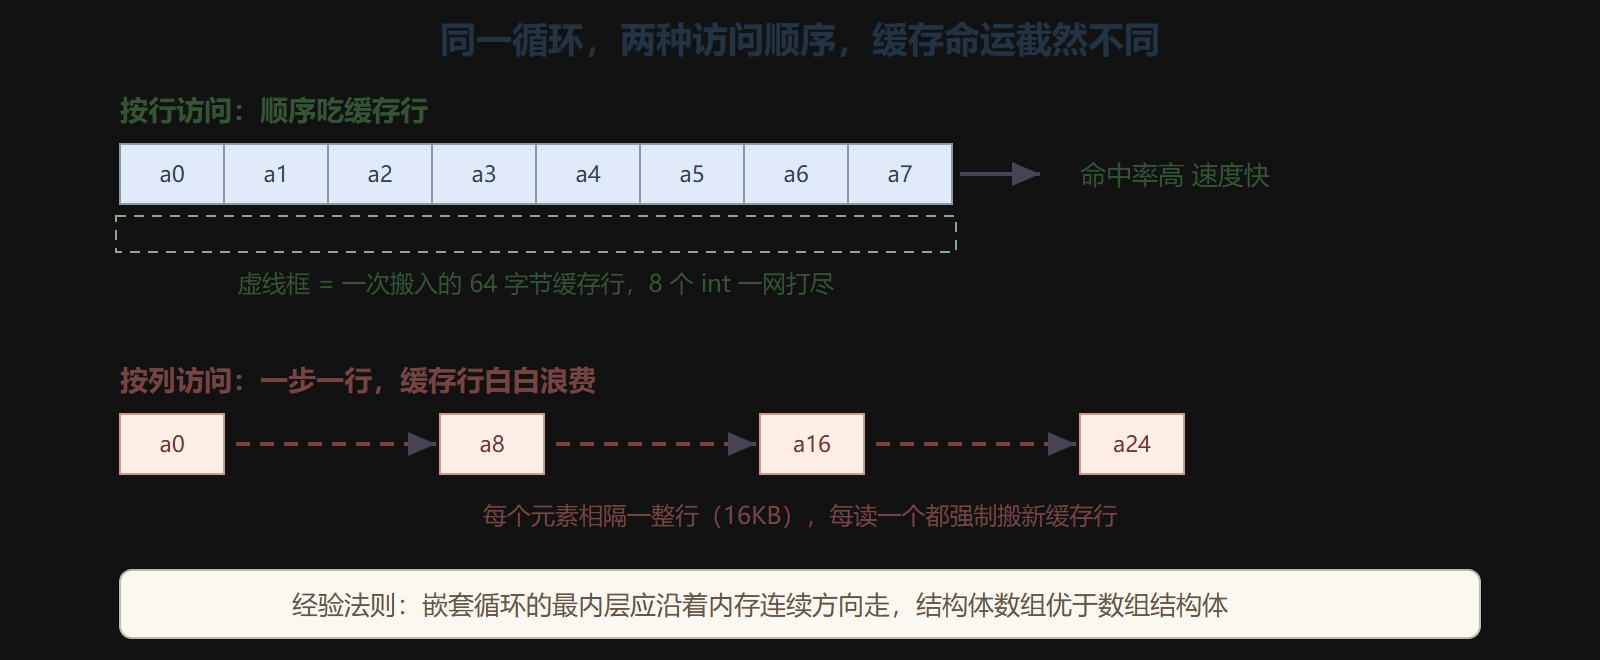
现代 CPU 与内存的速度差以百倍计,靠多级缓存(L1/L2/L3,几十 KB 到几十 MB)弥补。缓存按缓存行(通常 64 字节)为单位搬运——你读 1 个字节,硬件实际把你周围 64 字节都搬了进来。于是:
- 顺序访问:读完第一个 int,同缓存行的后 15 个 int 免费到手,命中率高;
- 跳跃访问:每读一个数都要搬一个新的缓存行,大量带宽浪费在"搬了不用"上。
一个能亲手跑出差距的实验——同一矩阵,两种遍历顺序:
#include <stdio.h> #include <time.h> #define N 4096 static int m[N][N]; int main(void) { clock_t t0, t1; long sum = 0; t0 = clock(); for (int i = 0; i < N; i++) for (int j = 0; j < N; j++) sum += m[i][j]; /* 按行:内存顺序访问 */ t1 = clock(); printf("按行 %ld ms\n", (long)((t1 - t0) * 1000 / CLOCKS_PER_SEC)); t0 = clock(); for (int j = 0; j < N; j++) for (int i = 0; i < N; i++) sum += m[i][j]; /* 按列:每步跳 16KB */ t1 = clock(); printf("按列 %ld ms\n", (long)((t1 - t0) * 1000 / CLOCKS_PER_SEC)); printf("%ld\n", sum); return 0; }
典型结果:按行几十毫秒,按列几百毫秒,差 5 到 10 倍——指令一条没变,变的只是访问顺序。这就是"缓存友好"的含义:让下一次要用的数据,恰好在上次搬来的缓存行里。
图 2 顺序访问与跳跃访问的缓存对照
循环效率的工程清单
把机器原理压成可执行的实践:
| 手段 | 原理 | 注意 |
|---|---|---|
| 内层沿内存连续方向 | 提高缓存命中 | 二维数组按行遍历 |
| 大循环合并(循环融合) | 一次搬运多次使用 | 可读性下降,量测后再做 |
| 减少循环内分支 | 分支预测惩罚 | 排序数据或改算术 |
| 循环不变量外提 | 避免重复计算 | -O2 通常自动做 |
| 避免循环内系统调用 | 上下文切换昂贵 | printf 会拖慢热循环 |
| 分块处理大矩阵 | 让工作集装进缓存 | 高级手段,第 6 章再见 |
最后一条值得展开一句:当矩阵大到缓存装不下时,把它切成几十 KB 的小块逐块处理,每块都能在缓存里"热"完再换下一块——分块是 BLAS 数学库的核心技术之一,本质仍是"让下一次用的数据在缓存里"。
死循环的两面性
死循环不全是事故。嵌入式主循环 while (1) 配合中断与状态机是标准架构;服务器的事件循环同样常驻不退。事故性死循环的特征是条件永远为真而非设计为真:无符号下溢(事故一)、更新语句被空语句吞掉(事故二)、共享变量被优化器缓存(忘了 volatile,循环条件永远读寄存器旧值)。区分设计性常驻与事故性失控,就看退出条件是否被有意管理——中断、超时、状态迁移。
⚠️ 常见坑:在循环条件里调用 strlen 之类带遍历成本的函数——
for (i = 0; i < strlen(s); i++)每轮都全串扫一遍,复杂度平方级。长度先存变量,或开优化让编译器证明其不变。
💡 关键直觉:循环性能三问——数据访问顺序是否连续、工作集是否装得进缓存、热循环里有没有不可预测分支与系统调用。三问过关,九成的循环性能问题已排除。
本节要点回顾
- 循环 = 条件测试 + 向后跳转:for 与 while 机器层面无差别,编译器还会自动改写成底部跳转形态。
- 三要素检查:初始化、边界、步进;无符号下溢与空语句是死循环两大肇因。
- 缓存按 64 字节行搬运:顺序访问近乎免费,跳跃访问每步搬新行;同矩阵两种遍历顺序实测差 5 到 10 倍。
- 内层循环沿内存连续方向是第一条缓存军规;大矩阵用分块让工作集进缓存。
- 设计性常驻循环要有受管理的退出条件:中断、超时、状态迁移,而不是"碰巧不满足"。
第 3 章结束。下一章进入函数的世界:跳转之上还要加上栈帧——参数、返回地址与局部变量的三层小屋,函数与递归的一切都发生在那里。