4.3 递归调用与栈溢出
4.3 递归调用与栈溢出
本节摘要:递归是函数调用自己,机器上是同一函数的栈帧层层叠加。每层帧消耗几十字节到几百字节的栈空间,栈总量通常只有几 MB——叠过头就是栈溢出,表现为段错误或更糟。本节用阶乘与斐波那契分析递归的栈行为,讲清尾递归与编译器优化,给出"什么时候该递归、什么时候必须改循环"的工程判据。
递归的机器形态:帧叠帧
long factorial(int n) { if (n <= 1) return 1; /* 基线条件:停止叠加 */ return n * factorial(n - 1); }
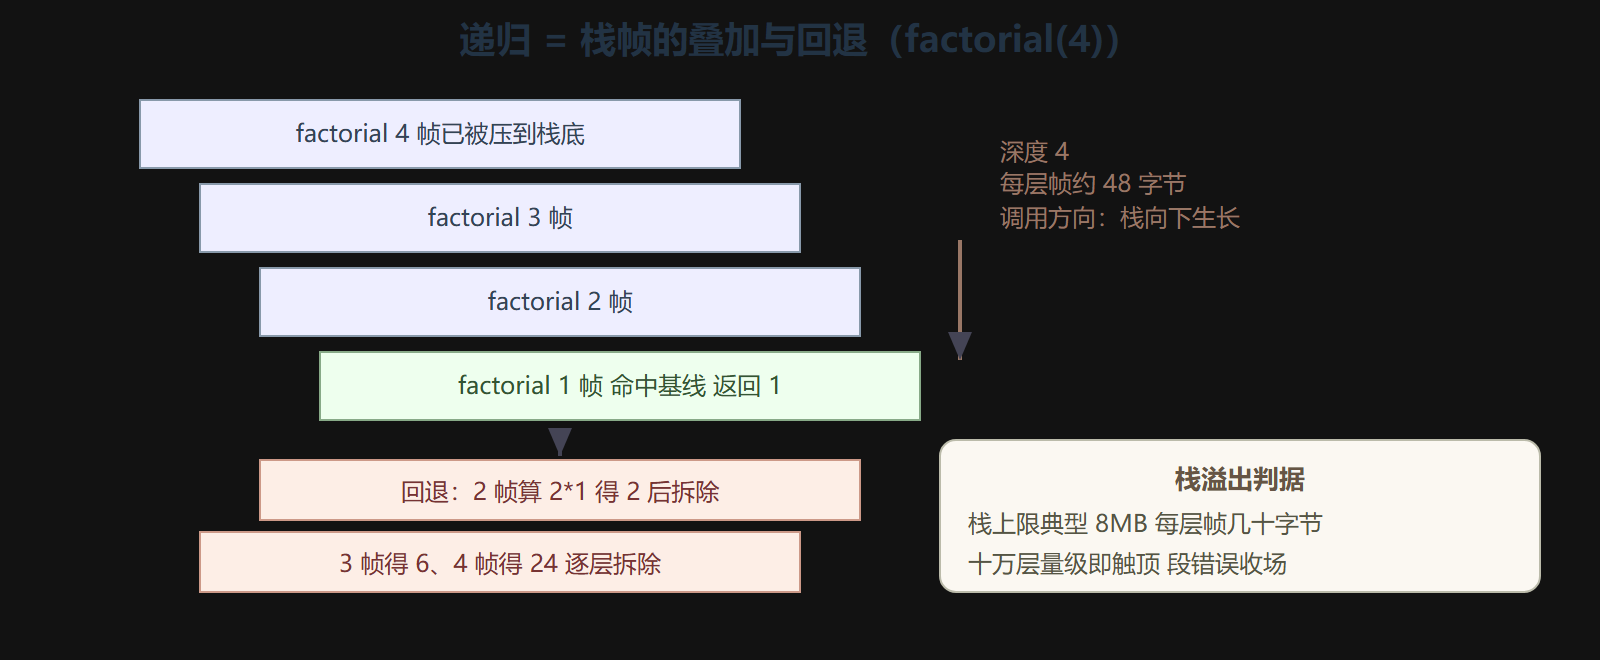
调用 factorial(4) 时栈上的演化:
factorial(4) 的帧 ← 等待 4 * factorial(3) 的结果 factorial(3) 的帧 ← 等待 3 * factorial(2) 的结果 factorial(2) 的帧 ← 等待 2 * factorial(1) 的结果 factorial(1) 的帧 → 命中基线,返回 1 factorial(2) 返回 2*1=2 factorial(3) 返回 3*2=6 factorial(4) 返回 4*6=24
两条铁律缺一不可:基线条件(不再递归的出口)与收敛性(每层向基线靠近)。缺基线或参数不收敛(如 factorial(n) 误写成调用 factorial(n)),栈帧无限叠加直到撞上栈上限——栈溢出。
图 1 递归的栈生长与回退
现场演示:亲手制造一次栈溢出
#include <stdio.h> int depth = 0; void dive(void) { char pad[1024]; /* 每层多占 1KB,加速触顶 */ pad[0] = (char)depth; /* 用一下,防止被优化掉 */ depth++; dive(); } int main(void) { dive(); printf("到不了这里,深度 %d\n", depth); return 0; }
典型结局:
Segmentation fault (core dumped)
在 gdb 里跑,bt 会看到几千行同名帧——栈溢出的标志性现场。默认栈上限 Linux 一般 8MB、Windows 常见 1MB,用命令可以查(栈大小属于进程资源限制)。每层帧的成本取决于局部变量与寄存器保存量,几十到几百字节不等;上面的例子人为放大到 1KB,几千层就触顶。经验数字:递归深度超过一万层就要警惕。
比栈溢出更阴险的:指数级调用树
斐波那契的朴素递归是性能课的经典反面教材:
long fib(int n) { if (n < 2) return n; return fib(n - 1) + fib(n - 2); /* 每次分裂成两个子调用 */ }
fib(5) 会计算 fib(3) 两遍、fib(2) 三遍——调用数随 n 指数增长,fib(50) 就要跑上数小时。问题不在栈(深度只有 n),在重复计算。两种修法:
/* 修法一:迭代,O(n) 时间 O(1) 空间 */ long fib_iter(int n) { long a = 0, b = 1; for (int i = 0; i < n; i++) { long t = a + b; a = b; b = t; } return a; } /* 修法二:记忆化,保留递归形态,算过的存表 */ long memo[100] = {0}; long fib_memo(int n) { if (n < 2) return n; if (memo[n]) return memo[n]; return memo[n] = fib_memo(n - 1) + fib_memo(n - 2); }
尾递归:能被编译器改成循环的递归
如果递归调用是函数的最后一个动作且返回值直接透传,就叫尾递归:
long fact_tail(int n, long acc) { if (n <= 1) return acc; return fact_tail(n - 1, n * acc); /* 结果直接返回,无后续计算 */ }
对比 4.3 开头的写法:那里返回 n * factorial(n-1),外层帧必须留着等结果再乘 n;尾递归版外层帧无事可做,编译器可以复用当前帧,递归被改写成循环——栈深度恒定。GCC 与 Clang 在 -O2 下会做这个变换。但要泼冷水:C 标准不保证尾调用优化,指望它不如直接写循环;它的价值在于"递归形态表达清晰、编译器顺便优化"。
工程判据:何时递归,何时改写
| 场景 | 建议 |
|---|---|
| 树与图的遍历、分治(快排、归并) | 递归天然契合,深度对数级,放心用 |
| 输入规模不可控(用户指定深度) | 必须迭代或显式栈 + 深度上限 |
| 有明显重复子问题 | 记忆化或动态规划 |
| 深度可能上万 | 改循环或显式栈 |
| 每层帧很大(大局部数组) | 缩小帧或把大数组移到堆 |
显式栈改写的一般模式:用堆上分配的数组和循环模拟"待处理工作",深度上限由数组大小控制——把"栈不够"变成"内存不够",可控性完全不同。
⚠️ 常见坑:给递归函数加深度参数防溢出,却把检查写在递归调用之后。检查必须在每次进入函数时先做,超过上限立刻返回错误。
💡 关键直觉:递归的时间成本看调用树的总节点数(fib 的教训),空间成本看树的深度(栈溢出的教训)。两条分开评估,缺一不可。
本节要点回顾
- 递归 = 栈帧层层叠加:基线条件与收敛性二者缺一即死循环或栈溢出。
- 栈上限几 MB、每层帧几十到几百字节:深度过万要警惕;gdb 里几千行同名 bt 是溢出现场。
- 指数调用树比栈溢出更常见:重复子问题用记忆化或迭代消灭。
- 尾递归可被优化成循环但不被标准保证:生产代码深度可控时才依赖它。
- 树形结构递归天然合适,线性结构优先迭代。
下一节把视角拉回变量本身:作用域决定名字的可见范围,存储类型决定变量住在哪、活多久。
常见疑问
问:栈溢出一定立刻崩溃吗? 不一定。撞上保护页会立刻段错误;但如果越界的写入落在栈内其他合法区域,可能只是悄悄踩坏数据,表现为诡异的错乱输出。崩溃反而是较好的结局,至少现场明确。
问:递归深度怎么估算? 用每层栈帧大小乘以深度上限。帧大小可用调试器查看,粗略按几十到几百字节计;再对照栈上限即可得出安全深度。任何可能超过一万层的递归都应改写。
问:编译器开了优化就不会栈溢出了吧? 尾递归形态确实可能被改成循环,但标准不保证,且多数递归(如树遍历的先处理再递归)不是尾递归,无法优化。安全设计不能建立在编译器的善意上。