1.1 从虚拟机到容器:一次部署方式的演化
1.1 从虚拟机到容器:一次部署方式的演化
摘要:容器不是更小的虚拟机,而是被内核隔离技术包装过的普通进程。本节沿部署方式演化线讲清虚拟机解决了什么、容器又用哪三件内核能力把开销压到接近零,并给出隔离强度的工程取舍。
学习目标
- 复述部署方式的四个阶段及各阶段的核心痛点
- 说清容器与虚拟机在隔离层级上的本质差异
- 列出支撑容器的三件 Linux 内核能力及各自职责
- 判断一个业务场景更适合虚拟机还是容器
从一份部署手册说起
2013 年之前,多数团队的部署文档长这样:"在 CentOS 7 上安装 Python 3.6、PostgreSQL 客户端 9.2、libxml2-devel,注意不要用系统自带的那份 OpenSSL"。这份文档每一次执行都可能产出不同的结果——操作系统小版本不同、依赖顺序不同、某台机器上有人手动改过配置。这就是所谓的"在我机器上是好的"问题,它的学名是环境漂移。
部署方式的演化就是对这个问题的一次次逼近:
| 阶段 | 代表技术 | 解决的问题 | 遗留的问题 |
|---|---|---|---|
| 物理机部署 | 手工安装 | 无 | 环境漂移、资源利用率极低 |
| 虚拟机 | VMware、KVM | 硬件隔离、环境封装 | 每台 VM 装整个操作系统,重 |
| 容器 | Docker、Podman | 秒级启动、增量分发 | 隔离弱于虚拟机 |
| 容器编排 | Kubernetes | 多机调度与自愈 | 复杂度陡增,需专门团队 |
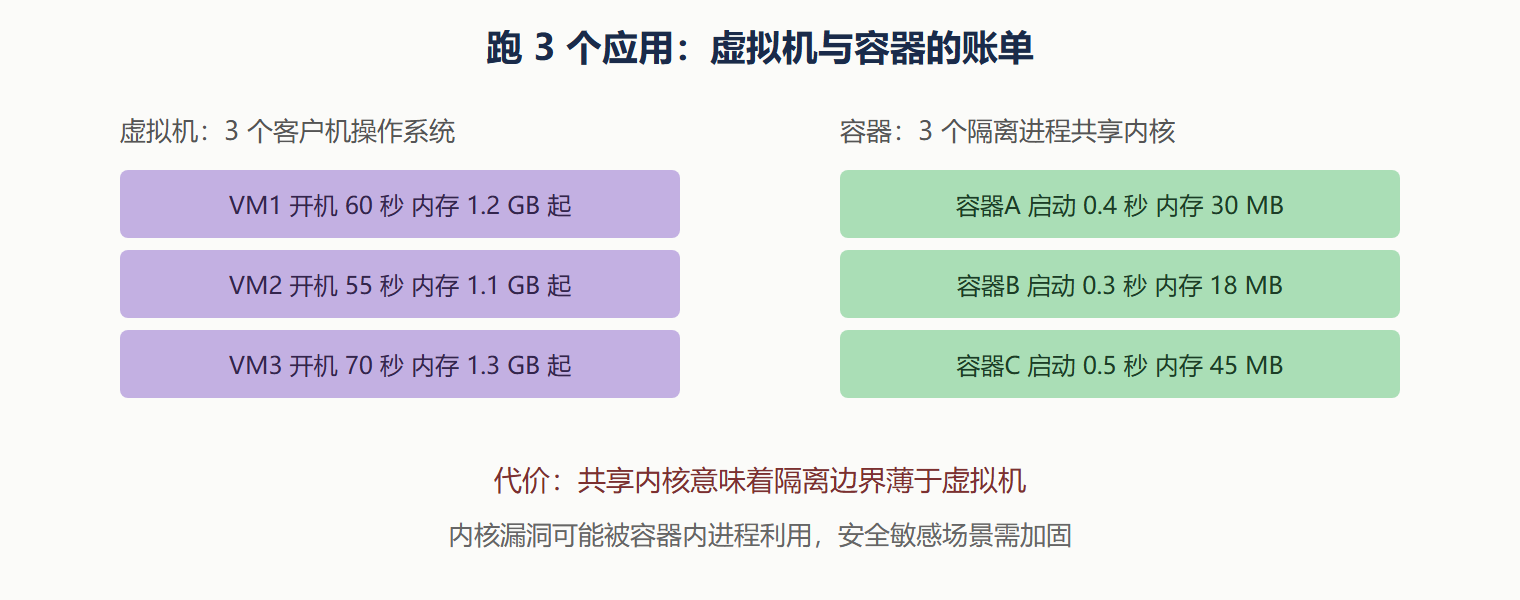
虚拟机把"一台计算机"整体虚拟出来:Hypervisor 之上每个 VM 都有自己的内核、设备驱动、init 进程。这带来了彻底的隔离,但代价是启动一台 VM 要走完整的开机流程,动辄一分钟起步,内存先被客户机操作系统吃掉几个 G。对于"我只想隔离地跑一个 Python 脚本"这种需求,这个代价不成比例。
容器的答案:不虚拟机器,虚拟"错觉"
容器的思路完全不同:不造一台新计算机,而是让宿主机上的一个普通进程"以为"自己独占整台机器。实现这个错觉只需要三件内核能力:
第一件是 namespace(命名空间)。它决定进程能"看见"什么。挂上 PID namespace 后,容器内的进程看不到宿主机上的其他进程,自己编号为一号进程;挂上 Mount namespace 后,它可以拥有独立的文件系统挂载点视图。namespace 是后面第 3 章的主角之一。
第二件是 cgroup(控制组)。它决定进程能"用多少"。CPU 配额、内存上限、块设备读写带宽,都由 cgroup 按组限制。容器不会因为里面跑了一个死循环就把宿主机拖垮,靠的就是它。
第三件是联合文件系统(UnionFS)。它决定进程的根文件系统从哪来。把多层只读镜像层叠加一个可写层,拼出一个完整的根目录,容器因此可以秒级创建、删除后不留痕迹。
这三件能力全部由宿主机内核提供,容器内没有第二个内核,没有第二次开机。所以容器启动就是创建一个进程,毫秒级;内存开销就是进程本身的开销。轻,是从架构里省出来的,不是优化出来的。
同一台机器上两种方案的资源开销对比
亲手摸一下"容器即进程"
不需要理解原理,先在宿主机上验证这个论断。启动一个容器:
docker run -d --name demo nginx:alpine
然后在宿主机上找它的进程:
ps -ef | grep nginx
输出里你会看到熟悉的两行:
root 21453 21431 0 10:02 ? 00:00:00 nginx: master process nginx -g daemon off; 101 21467 21453 0 10:02 ? 00:00:00 nginx: worker process
这两个 nginx 进程就跑在宿主机的进程表里,和你的 sshd 是邻居。再看它的 cgroup 归属:
cat /proc/21453/cgroup
输出形如 0::/system.slice/docker-<容器id>.scope——容器进程被放进了 Docker 创建的 cgroup 分组。也就是说,容器没有藏进另一个世界,它只是被"打了标签、画了圈"的普通进程。这个视角贯穿本文集后面所有章节。
隔离强度是一笔交易
容器用薄隔离换轻开销,这笔交易是否划算取决于场景:
- 同一团队的多套微服务:容器。信任边界在团队内部,编排收益远大于隔离风险。
- 对外提供多租户计算(如托管代码运行):容器需大量加固(rootless、gVisor、Kata),甚至直接用微虚拟机。共享内核面对恶意代码是脆弱的。
- 运行不同操作系统的负载:只能虚拟机。容器共享内核,Windows 程序无法跑在 Linux 容器里。
判断标准一句话:信任边界离内核越近,越该用虚拟机;信任边界在应用之间,容器是更划算的答案。
本节要点回顾
- 环境漂移是部署演化的原动力,每代技术都是对它的一次逼近
- 容器不是小虚拟机:没有第二个内核,是被 namespace、cgroup、UnionFS 包装的普通进程
- 轻是架构性的:启动即创建进程,开销即进程开销
- 隔离是交易:薄隔离换来轻开销,多租户恶意场景要额外加固
- 容器即进程可以用 ps 命令直接验证,这个视角是后续章节的地基
下一节我们看是谁替我们操纵这三件内核能力——Docker 的组件架构与安装。