3.2 cgroup资源限制:容器的账本与手铐
3.2 cgroup 资源限制:容器的账本与手铐
摘要:cgroup 是内核的资源记账与限制框架,容器"用多少"全由它说了算。本节拆解内存、CPU 两类限制的参数语义,区分 OOMKilled 与 CPU 限流两种截然不同的"变慢/死亡",并给出生产环境的限制参数起步值。
学习目标
- 说出 --memory、--cpus、--cpu-shares 各参数对应的 cgroup 机制
- 区分 OOMKilled(内存越界被杀)与 CPU 限流(被节流变慢)的现象与判据
- 从容器状态与宿主机 cgroup 文件两个层面取证资源事件
- 为常见 workload 给出限制参数的起步配置
记账与执法
namespace 管"看见什么",cgroup 管"用掉多少"。cgroup 把进程分组,每组挂一套资源控制器(memory、cpu、blkio、pids……),控制器做两件事:记账(这组进程用了多少内存、多少 CPU 时间)和执法(超限了怎么处理)。
执法方式因资源而异,这是理解容器"死法"的关键:
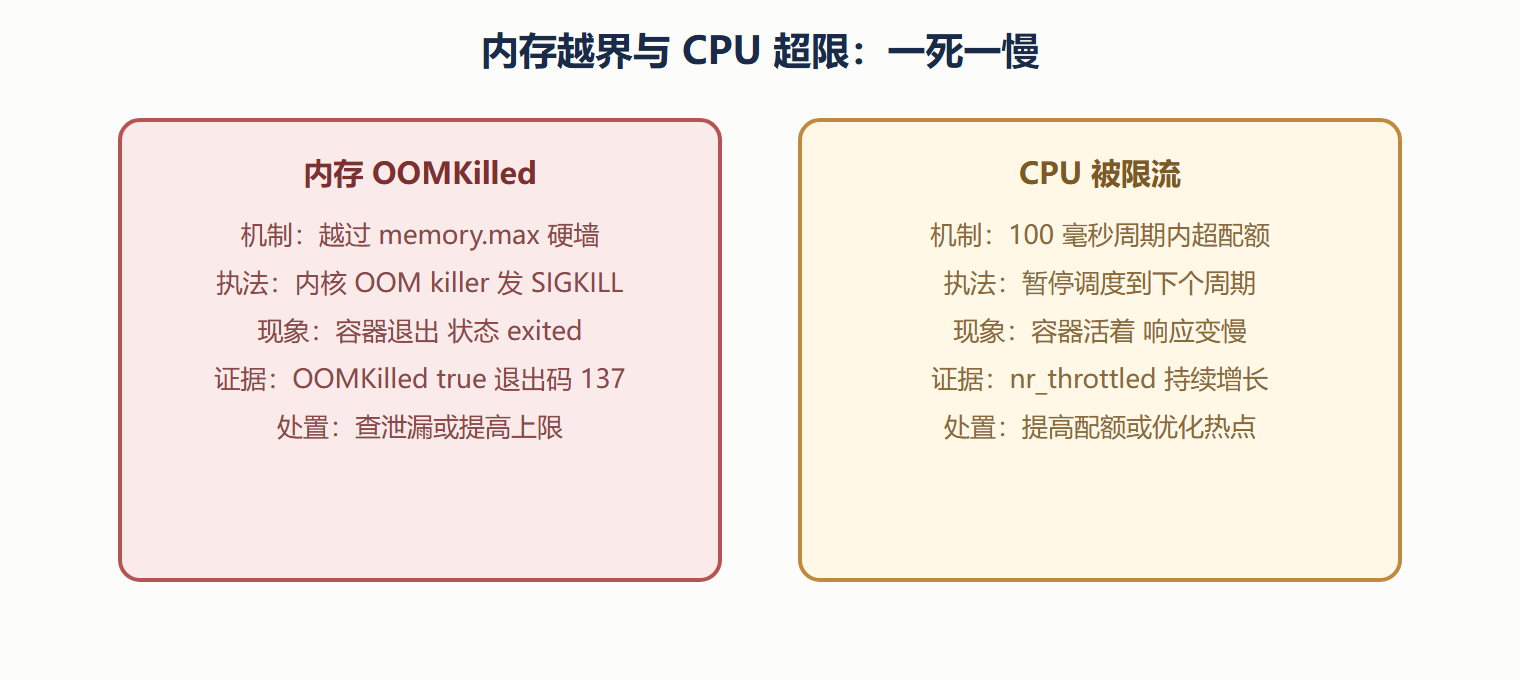
- 内存是硬墙:超过上限,内核 OOM killer 直接杀进程,容器死亡,状态码 137
- CPU 是节流阀:超过配额,进程不会被杀,只是被暂停调度、变慢
- blkio 与 pids:分别限磁盘带宽与进程数,超限表现为 IO 等待或 fork 失败
内存限制:一面硬墙
docker run -d --name mem-demo -m 256m nginx:alpine
-m 256m 把容器的内存上限设为 256 MB(同时 swap 上限默认翻倍,精确控制用 --memory-swap)。验证它挂在哪:
PID=$(docker inspect mem-demo --format '{{.State.Pid}}') cat /proc/$PID/cgroup
cgroup v2 下输出形如 0::/system.slice/docker-<id>.scope,顺着这条路径能在 cgroup 文件系统里找到 memory.max 文件,内容正是 268435456(256 MB 的字节数)。限制不是 Docker 想象出来的,是写在内核账本上的。
现在故意越界,用一个吃内存的进程演示:
docker run -d --name oom-demo -m 100m python:3.12-slim \ python -c "a = bytearray(500*1024*1024)"
几秒后查看:
docker inspect oom-demo --format '{{.State.Status}} {{.State.OOMKilled}} {{.State.ExitCode}}'
输出:exited true 137。OOMKilled 为 true、退出码 137(128 加 9,即 SIGKILL)。这是内存越界的标准尸检报告,第 7 章排错时它会反复出现。
⚠️ 有个常被忽略的细节:Java 这类按容器内存比例分配堆的语言,在没读到正确限制值时会按宿主机内存设定堆大小——宿主机 64 GB、容器限 2 GB,JVM 却以为有 64 GB 可用,堆撑破限制被 OOM 杀掉。较新的 JVM 已默认感知容器,但老版本 JDK 一定要显式设 -XX:+UseContainerSupport 或直接指定堆大小。
CPU 限制:一个节流阀
CPU 的控制有三个常用参数,语义各不相同:
--cpus=1.5:配额制。表示最多使用 1.5 个核的时间片,对应 cgroup 的 quota/period 机制——每 100 毫秒周期里最多跑 150 毫秒 CPU 时间。多核机器上这 1.5 个核可以分散在任意物理核上。
--cpu-shares=512****(或 v2 的 cpu.weight):权重制。只在CPU 争抢时生效:空闲时随便用,争抢时按权重比例分。默认 1024,设 512 意味着争抢时拿一半配额。
--cpuset-cpus=0,1:绑定制。只允许在指定物理核上跑,缓存亲和性最好的同时弹性最差。
三种参数对比:
| 参数 | 机制 | 空闲时 | 争抢时 | 典型用途 |
|---|---|---|---|---|
| --cpus 1.5 | 时间配额 | 可用满 1.5 核 | 仍 1.5 核 | 硬性上限防吵闹邻居 |
| --cpu-shares 512 | 权重 | 随便用 | 按比例分 | 区分优先级 |
| --cpuset-cpus 0,1 | 核绑定 | 限定核 | 限定核 | 低延迟与缓存亲和 |
CPU 超限的现象是变慢而非死亡。判断"容器慢是不是 CPU 限流导致",看容器内 CPU throttlet 统计:
docker run --rm --name cpu-demo --cpus=0.5 alpine \ sh -c 'while true; do :; done' & cat /sys/fs/cgroup/system.slice/docker-$(docker inspect cpu-demo --format '{{.Id}}').scope/cpu.stat
输出里 nr_throttled 与 throttled_usec 两个数字持续增长,就说明进程反复被节流——应用没有故障,是配额给小了,加配额即可,别去重启。
两种"出事"的对照
pids:防 fork 炸弹的暗桩
--pids-limit=200 限制容器内进程与线程总数。一个失控的脚本不停 fork,没有这层限制会把宿主机进程表打满,殃及四邻。Web 类容器给个几百就够,跑 java 的多给些(JVM 线程数不菲)。
生产起步值
给不出万能值,但能给方法:先用 docker stats 观察一周真实用量,把上限设为峰值的 1.5 倍左右,同时给编排层(第 6 章)声明 request 与 limit 两档——request 保底、limit 封顶。内存上限一定要设,CPU 上限可以只设 shares 保弹性。完全不设限制是最危险的选择:一个失控容器拖垮整台宿主机的事故,几乎都从"忘了设限制"开始。
内存是墙,撞上就死;CPU 是闸,关小就慢。分清这两种执法方式,一半的"容器诡异行为"可以直接定性。
一个真实案例收尾
某团队的服务器上跑了十几个容器,某个深夜数据库容器被 OOM 杀掉,业务中断。复盘时发现所有容器都没设内存限制,数据库与一个新上的批处理任务在争内存,内核 OOM killer 按"内存占用大"选中了数据库。修复动作很朴素:给每个容器补上内存与 CPU 限制,给批处理任务单独设了更紧的配额。这个案例的教训不是"要设限制"这一条命令,而是理解 cgroup 的执法逻辑——内核在整体内存告急时的选择是不带业务感情的,把业务优先级翻译成资源边界,是运维者的责任。
本节要点回顾
- cgroup 既记账又执法,执法方式因资源而异:内存杀死、CPU 节流、pids 拒绝 fork
- 137 与 OOMKilled true 是内存越界的铁证;nr_throttled 增长是 CPU 限流的铁证
- --cpus 硬顶、shares 争抢比例、cpuset 绑核,三种语义别混用
- JVM 这类内存感知型运行时要显式确认它读的是容器限制而非宿主机内存
- 上限用峰值 1.5 倍起步,且永远要设内存上限
两台引擎都拆完了,下一节把它们装回容器的生老病死里。