3.2 Flask-SQLAlchemy 数据库 ORM
3.2 Flask-SQLAlchemy 数据库 ORM
问题与直觉:为什么要 ORM
写裸 SQL 的问题:字符串拼接易注入、类型转换繁琐、表结构改了代码到处改、数据库方言差异。ORM 的做法:用 Python 类描述表结构,用对象操作数据,SQL 由框架生成。
直觉类比:ORM 像"翻译官"——你用 Python 说"我要找所有年龄大于 18 的用户",翻译官把它变成 SELECT * FROM users WHERE age > 18 交给数据库。
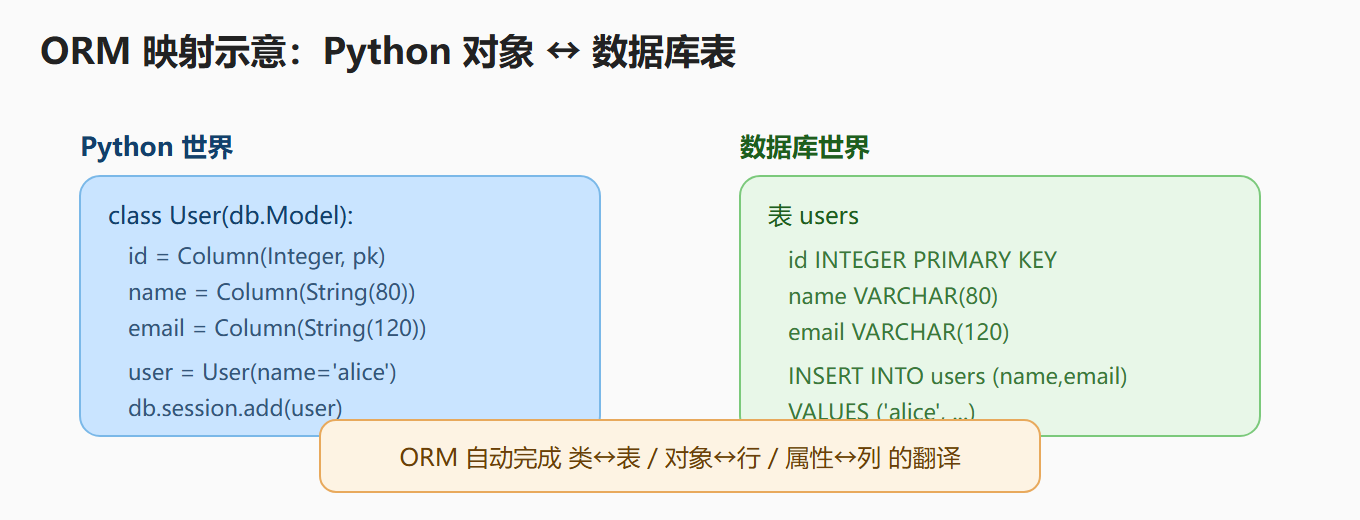
💡 关键直觉:模型类 = 表,实例 = 行,session = 会话。你在 Python 世界里操作对象,ORM 负责与数据库同步。
ORM 映射示意:Python 对象 ↔ 数据库表
核心原理:模型、会话与 CRUD
2.1 安装与初始化
pip install flask-sqlalchemy
# extensions.py from flask_sqlalchemy import SQLAlchemy db = SQLAlchemy() # 工厂中 app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///app.db' app.config['SQLALCHEMY_TRACK_MODIFICATIONS'] = False db.init_app(app)
2.2 定义模型
# models.py from .extensions import db class User(db.Model): __tablename__ = 'users' id = db.Column(db.Integer, primary_key=True) name = db.Column(db.String(80), nullable=False) email = db.Column(db.String(120), unique=True, nullable=False) age = db.Column(db.Integer, default=0) created_at = db.Column(db.DateTime, server_default=db.func.now())
常用字段类型:Integer、String(n)、Text、Float、Boolean、DateTime、Date、LargeBinary。
2.3 增删改查
# 创建表(开发期一次性) with app.app_context(): db.create_all() # 增 user = User(name='alice', email='a@example.com', age=18) db.session.add(user) db.session.commit() # 提交事务,id 此时被赋值 # 查 User.query.get(1) # 按主键(新版本用 db.session.get) User.query.filter_by(name='alice').all() # 等值过滤 User.query.filter(User.age >= 18).all() # 比较过滤 User.query.order_by(User.age.desc()).all() # 排序 User.query.limit(10).all() # 限量 User.query.count() # 计数 # 改 user = db.session.get(User, 1) user.age = 19 db.session.commit() # 删 db.session.delete(user) db.session.commit()
注意:add/delete 只是加入会话,commit() 才真正写库。忘记 commit 是新手最常见的"数据没保存"原因。
会话的完整生命周期可以用一张流程图看清:
2.4 session 与上下文
SQLAlchemy 的 session 生命周期由 Flask 扩展管理:每次请求开始自动创建 session,请求结束自动清理。所以在视图里直接 db.session.add(...) 即可,不用手动关闭。
工程实践要点:关系与查询
3.1 一对多:用户与文章
class User(db.Model): id = db.Column(db.Integer, primary_key=True) name = db.Column(db.String(80)) posts = db.relationship('Post', backref='author', lazy=True) class Post(db.Model): id = db.Column(db.Integer, primary_key=True) title = db.Column(db.String(200)) user_id = db.Column(db.Integer, db.ForeignKey('users.id'))
查询:
user = db.session.get(User, 1) user.posts # 该用户的所有文章(懒加载) post = Post(title='Hello', user_id=1) db.session.add(post) db.session.commit() post.author # 通过 backref 反向拿作者
3.2 多对多:用户与标签
user_tags = db.Table('user_tags', db.Column('user_id', db.Integer, db.ForeignKey('users.id')), db.Column('tag_id', db.Integer, db.ForeignKey('tags.id')) ) class Tag(db.Model): id = db.Column(db.Integer, primary_key=True) name = db.Column(db.String(50)) users = db.relationship('User', secondary=user_tags, backref='tags')
tag = Tag(name='python') user = db.session.get(User, 1) user.tags.append(tag) db.session.commit()
3.3 聚合查询
from sqlalchemy import func # 按年龄分组统计人数 rows = db.session.query(User.age, func.count(User.id)).group_by(User.age).all() # 平均年龄 avg = db.session.query(func.avg(User.age)).scalar()
3.4 性能:警惕 N+1 查询
# 反面:循环里逐个访问 author,触发 N 次查询 for post in Post.query.all(): print(post.author.name) # 每次访问 author 都查一次库 # 正面:用 joinedload 一次性连表取回 from sqlalchemy.orm import joinedload for post in Post.query.options(joinedload(Post.author)).all(): print(post.author.name) # 只有 1 次主查询 + 1 次联表
N+1:查 N 条记录时又触发 N 次关联查询,接口秒变慢。用 joinedload 或 selectinload 解决。
3.5 分页
page = Post.query.order_by(Post.id.desc()).paginate( page=1, per_page=10, error_out=False) print(page.items, page.total, page.pages)
常见误区与排查
| 误区 | 现象 | 正解 |
|---|---|---|
| 忘记 commit | 数据"丢失" | 增删改后 commit |
| 循环里查关联 | 接口巨慢 | joinedload/selectinload |
| 用裸字符串拼 SQL | SQL 注入风险 | 用 ORM 参数化查询 |
| filter 与 filter_by 混淆 | 报错或查错 | filter 写表达式,filter_by 写关键字 |
| 在 app 外操作 session | RuntimeError | with app.app_context() 内操作 |
| 生产直接 create_all | 改表结构丢数据 | 用 Flask-Migrate(3.7) |
动手演练:一个博客的数据层
# models.py from datetime import datetime from .extensions import db class User(db.Model): id = db.Column(db.Integer, primary_key=True) username = db.Column(db.String(80), unique=True, nullable=False) posts = db.relationship('Post', backref='author', lazy=True) class Post(db.Model): id = db.Column(db.Integer, primary_key=True) title = db.Column(db.String(200), nullable=False) body = db.Column(db.Text) created_at = db.Column(db.DateTime, default=datetime.utcnow) user_id = db.Column(db.Integer, db.ForeignKey('users.id'), nullable=False)
# 视图示例 from flask import request from .models import User, Post from .extensions import db @app.route('/users/<int:uid>/posts') def user_posts(uid): user = db.session.get(User, uid) if not user: return '用户不存在', 404 return f'{user.username} 发布了 {len(user.posts)} 篇文章'
把"用户-文章"用关系串起来,一次建模、处处查询——这就是 ORM 的生产力。
温故知新
- ORM 价值:Python 对象操作数据库,免 SQL 拼接、免注入、跨数据库。
- 三要素:模型类=表、实例=行、session=事务会话。
- CRUD 五步:add → commit;query → filter → order_by;delete → commit。
- 关系:relationship + ForeignKey 实现一对多;secondary 实现多对多。
- 性能:警惕 N+1,用 joinedload;列表接口记得分页。
- 工程化:表结构变更交给 Flask-Migrate,别用 create_all 对付生产。
深入理解:ORM 的边界与进阶方向
用 ORM 不等于懂 ORM,理解它的边界才能用对。
第一,ORM 生成什么 SQL? 每个查询操作最终都会翻译成 SQL。可以用 echo 配置打印 SQL:SQLALCHEMY_ECHO=True(开发期),在终端看到 ORM 实际执行的语句——这是理解"ORM 做了什么"最好的方式,也是排查性能问题的起点。看到一条 .all() 触发了一串 SELECT,你就知道 N+1 在哪了。
第二,懒加载与即时加载的权衡。 默认 lazy=True(懒加载):访问 user.posts 时才查数据库。懒加载省资源但容易触发 N+1;joinedload 一次性联表查回但可能带冗余数据。决策原则:列表页面用 joinedload 预取关联;详情页面按需访问。没有银弹,按访问模式选。
第三,事务的边界。 db.session 是"工作单元"(Unit of Work)模式:一系列操作在 commit 时统一提交,失败时 rollback 全部撤销。一个请求就是一个事务的天然边界——Flask-SQLAlchemy 在请求结束时自动 commit(或回滚)。所以视图里 add 后忘 commit,请求结束时也可能被自动提交——但依赖这个隐式行为是不好的习惯,显式 commit 才是可预期的方式。
第四,并发下的会话隔离。 每个请求有独立的 session(上下文绑定),互不干扰——这是上下文机制(2.5)在 ORM 层的体现。但要注意:session 里的对象是"同一个"——同一请求内多次查询同一行返回同一个对象实例,改一个地方会影响所有引用。理解这一点,才能避免"改了 A 变量,B 变量也变了"的困惑。
第五,从 SQLAlchemy 走向更大的数据世界。 学会 SQLAlchemy 后,你可以平滑过渡到:复杂查询(聚合、子查询、窗口函数)、异步 SQLAlchemy(asyncio 场景)、其他 ORM(如 Peewee、Django ORM)——概念都是相通的。ORM 是工具,SQL 是语言:用 ORM 写业务、懂 SQL 查问题,两者兼备才是数据层专家。
第六,模型设计的心法。 不要一上来就设计"精确的表结构"——业务会变,结构会演进(第三章 3.7 迁移就是为此存在)。先满足当前需求的最小设计,加上合理的索引与约束(unique、nullable、default),随着业务演进用迁移迭代。过度设计是数据库建模最常见的错误,克制比炫技重要。
本节常见问题速答
问:什么时候调用 db.create_all()?
开发期手动调用一次建表即可。注意 create_all 不会修改已有表(加列、改类型都不生效)——需要改结构时用 Flask-Migrate(3.7)。
问:db.session 需要手动关闭吗?
不需要。Flask-SQLAlchemy 在请求结束时自动清理 session(teardown_appcontext 钩子),你只需保证 commit 时机正确。
问:查询结果会缓存吗?
同一请求内,session 会缓存已查询的对象(同一行返回同一实例)——这是"工作单元"模式的行为。跨请求不缓存,需要缓存请用 Flask-Caching(3.6)。