4.1 应用结构最佳实践
4.1 应用结构最佳实践
问题与直觉:单文件的终点
app.py 从 50 行长到 2000 行时:路由、模型、表单、配置全在一个文件——改一行要滚动半天、import 关系乱成一团、没法写测试(每个测试都要 import 全文件)、多人协作必然冲突。
直觉类比:单文件像"一个人住的单身公寓",包结构像"规划好的办公楼"——每个楼层(模块)有明确职能,楼梯(import)有固定路线,物业管理(工厂)统一协调。
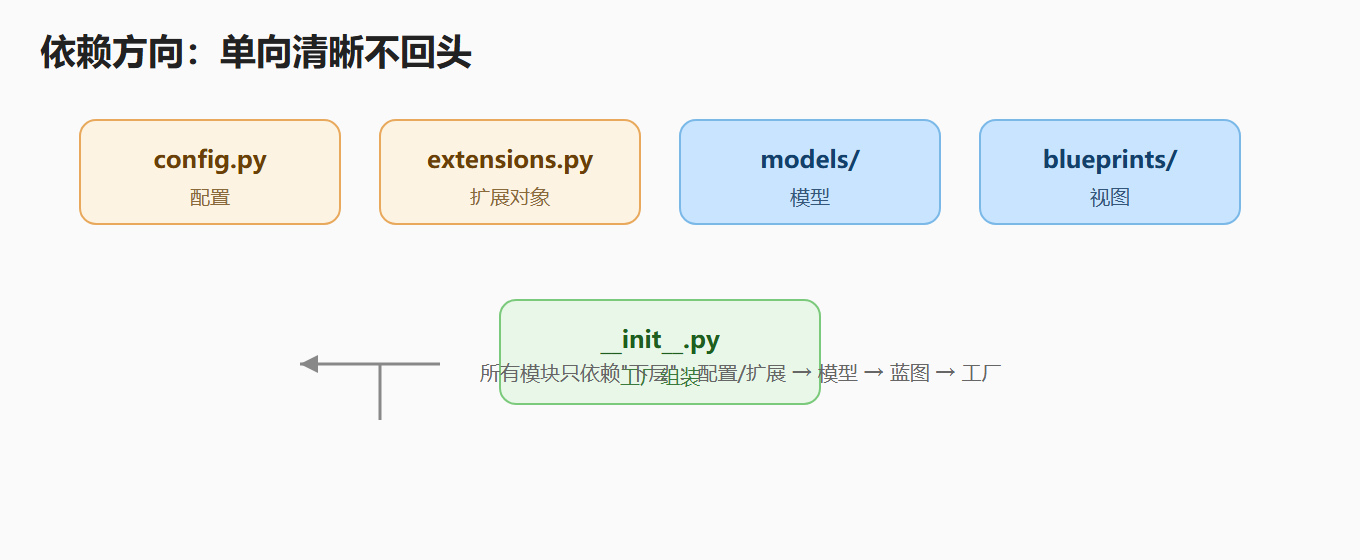
💡 关键直觉:结构的目标是"可维护"——新功能加在明确的位置、依赖方向清晰(配置 → 扩展 → 模型 → 蓝图 → 应用)、循环导入自然消失。
核心原理:工厂模式 + 包结构
2.1 推荐的项目结构
project/ ├── app/ # 应用包 │ ├── __init__.py # create_app 工厂 │ ├── extensions.py # 扩展对象集中创建 │ ├── config.py # 配置类 │ ├── models/ # 数据模型(按域拆分) │ │ ├── __init__.py │ │ ├── user.py │ │ └── post.py │ ├── views/ 或 blueprints/ # 蓝图(按功能模块) │ │ ├── __init__.py │ │ ├── auth.py │ │ └── main.py │ ├── forms.py # 表单类 │ ├── templates/ # Jinja2 模板 │ ├── static/ # 静态资源 │ └── utils.py # 工具函数 ├── migrations/ # Flask-Migrate 迁移 ├── tests/ # 测试 ├── wsgi.py # 部署入口 ├── requirements.txt └── .env.example # 环境变量样例
2.2 工厂函数 create_app
# app/__init__.py from flask import Flask from .config import config_map from .extensions import db, login_manager, migrate, csrf def create_app(config_name='default'): app = Flask(__name__) app.config.from_object(config_map[config_name]) # 初始化扩展(顺序:配置 → 扩展 → 蓝图) db.init_app(app) login_manager.init_app(app) migrate.init_app(app, db) csrf.init_app(app) # 注册蓝图 from .blueprints.main import main_bp from .blueprints.auth import auth_bp app.register_blueprint(main_bp) app.register_blueprint(auth_bp, url_prefix='/auth') return app
工厂的好处:
- 测试可创建
create_app('testing')——不同环境不同配置; - 命令行脚本可
with create_app().app_context():; - 初始化顺序集中、清晰。
2.3 扩展集中管理
# app/extensions.py from flask_sqlalchemy import SQLAlchemy from flask_login import LoginManager from flask_migrate import Migrate from flask_wtf import CSRFProtect db = SQLAlchemy() login_manager = LoginManager() migrate = Migrate() csrf = CSRFProtect() login_manager.login_view = 'auth.login' login_manager.login_message = '请先登录'
模型导入扩展对象、工厂调用 init_app——扩展定义与初始化分离,避免循环导入。
工程实践要点
3.1 配置分离
# app/config.py import os class Config: SECRET_KEY = os.environ.get('SECRET_KEY', 'dev-secret') SQLALCHEMY_DATABASE_URI = os.environ.get('DATABASE_URL', 'sqlite:///dev.db') SQLALCHEMY_TRACK_MODIFICATIONS = False class DevelopmentConfig(Config): DEBUG = True class TestingConfig(Config): TESTING = True SQLALCHEMY_DATABASE_URI = 'sqlite:///:memory:' WTF_CSRF_ENABLED = False class ProductionConfig(Config): DEBUG = False SECRET_KEY = os.environ.get('SECRET_KEY') # 必须从环境变量来 SESSION_COOKIE_SECURE = True config_map = { 'development': DevelopmentConfig, 'testing': TestingConfig, 'production': ProductionConfig, 'default': DevelopmentConfig, }
3.2 蓝图按"功能域"拆分
# app/blueprints/auth.py from flask import Blueprint auth_bp = Blueprint('auth', __name__) @auth_bp.route('/login', methods=['GET', 'POST']) def login(): ... @auth_bp.route('/register', methods=['GET', 'POST']) def register(): ...
拆分原则:按业务域(auth、blog、admin、api)而不是按技术层(views、models、utils 各放一堆)。同一功能的路由、表单、模板放一起。
3.3 模型按域拆分
# app/models/__init__.py from .user import User from .post import Post __all__ = ['User', 'Post'] # app/models/user.py from ..extensions import db class User(db.Model): __tablename__ = 'users' id = db.Column(db.Integer, primary_key=True) username = db.Column(db.String(80), unique=True)
其他模块用 from ..models import User——统一出口,避免深层相对导入。
3.4 循环导入的规避
循环导入(A import B 同时 B import A)是 Flask 项目最常见的报错来源。规避法则:
- 扩展对象放 extensions.py,模型/蓝图都只从那里导入;
- 蓝图在工厂内部延迟导入(
from .blueprints.auth import auth_bp放在 create_app 里); - 模型间引用用字符串(
db.relationship('Post', ...))。
依赖方向:单向清晰不回头
常见误区与排查
| 误区 | 现象 | 正解 |
|---|---|---|
| 全部塞一个文件 | 改不动、测不了 | 200 行左右就考虑拆包 |
| 扩展在蓝图里创建 | 循环导入 | 扩展集中 extensions.py |
| 蓝图在模块顶部导入 | ImportError | 工厂内延迟导入 |
| 配置散落各处 | 改环境要翻代码 | config.py 配置类 + 环境变量 |
| 模型互相深度导入 | 循环依赖 | relationship 用字符串引用 |
| 测试直接 import app 实例 | 配置被锁死 | 测试用 create_app('testing') |
动手演练:把单文件升级成包
# 旧:app.py 全部内容 app = Flask(__name__) @app.route('/') ... class User(db.Model): ... # 2000 行…… # 新:迁移步骤 # 1. 建 app/ 目录,移动 config 到 app/config.py # 2. 建 app/extensions.py,放 db/login_manager/migrate # 3. 写 app/__init__.py 的 create_app # 4. 按功能拆蓝图,注册进工厂 # 5. 模型按域拆分,统一 from ..models import ... # 6. wsgi.py 暴露 app = create_app('production')
升级后,加一个新功能的路径固定为:加蓝图 → 加模型 → 注册——每个改动落位清晰,测试与协作自然顺畅。
结构演进的三个阶段可以用一张状态图概括:
本章回顾
- 升级时机:单文件超过 200-300 行、需要测试/协作时,就该包化。
- 工厂模式:create_app(config_name) 统一初始化,支持多环境。
- 扩展集中:extensions.py 建对象,工厂内 init_app。
- 蓝图按域拆分:auth/blog/admin 按业务组织,而非按技术层。
- 配置分离:配置类 + 环境变量,敏感项不进代码。
- 单向依赖:配置/扩展 → 模型 → 蓝图 → 工厂,规避循环导入。
深入理解:架构演进与决策框架
应用结构没有"唯一正确答案",但有一套思考框架。
第一,结构的本质是"变化隔离"。 好的结构让"经常一起变的代码"靠近,"独立变化的代码"分离。路由与视图一起变(加页面)→ 放一起;配置与业务独立变 → 分离;模型与视图耦合度中等 → 分层引用。每次决定"放哪",都在做一次变化隔离的判断——这个判断力比记住任何模板都重要。
第二,单文件到包结构的真实信号。 除了行数,更可靠的信号是:需要为同一个功能写测试时(单文件 import 会触发整个应用初始化)、两个人在同一个文件频繁冲突时、一个文件的 import 列表超过屏幕时。当"找代码"的时间开始超过"写代码"的时间,就是重构的时候。
第三,工厂模式不是必须的。 如果你的应用只有一个环境、永远单实例,模块级 app = Flask(name) 也完全可用。工厂模式的价值在"多环境、多实例":测试需要 testing 配置的实例、CLI 需要无请求的实例、部署需要 production 实例。判断标准:需要测试就用工厂(几乎总是需要),不需要就别硬套。
第四,包内包的层次。 应用大了之后,app/ 下还会出现子包:app/services/(业务服务层)、app/api/(接口层)、app/commands/(CLI 命令)。分层原则保持"依赖单向向下":api → services → models → extensions。依赖方向是架构的骨架——方向乱了,循环导入和隐性耦合就来了。
第五,配置文件 vs 环境变量 vs 数据库配置。 三者的边界:代码结构类(蓝图列表、扩展开关)放配置类;密钥与环境差异放环境变量;频繁变化的功能开关放数据库/Redis(运营可改)。"配置放哪"的决策标准是"谁需要改它、多频繁改"——部署时改的用环境变量,运营时改的进数据库。
第六,重构的节奏与纪律。 结构优化是持续工程,不是一次性大手术。推荐节奏:每完成一个功能就顺手整理相关代码;发现"放错位置"的代码立即移动(小步提交);大重构(单文件→包)用"先搭骨架、再逐个迁移、每步可运行"的方式推进。重构的黄金法则:每次改动后应用都能跑——小步快跑,永远可回退。
第七,用"新成员上手时间"检验结构。 一个判断结构好坏的最朴素标准:新同事(或三个月后的你)打开项目,能不能在十分钟内找到"加一个新页面"该改哪些文件?能,说明结构清晰;不能,说明该整理了。结构是为"人"设计的,不是为"好看"设计的——这个检验法比任何架构图都实用。