4.3 性能优化
4.3 性能优化
问题与直觉:先测再优
新手常犯的错误:凭感觉优化——今天觉得模板慢加缓存,明天觉得框架慢换框架,最后发现瓶颈在数据库一条没索引的查询。性能优化的第一条铁律:没有数据就没有优化。
直觉类比:优化像看病——先做检查(profiling)找病灶,再开药(优化手段)。乱吃药(盲优化)不仅无效,还可能引入新问题。
💡 关键直觉:80% 的性能问题出在 20% 的代码上——数据库查询、I/O 操作、重复计算是三大常见瓶颈。先用工具找到那 20%,再动手。
核心原理:测量先行
2.1 用 Werkzeug Profiler
app.config['PROFILE'] = True from werkzeug.middleware.profiler import ProfilerMiddleware app.wsgi_app = ProfilerMiddleware(app.wsgi_app)
访问几次页面,控制台输出每个函数的耗时排名——最快定位"哪个函数最慢"。
2.2 数据库查询统计
from flask_sqlalchemy import get_debug_queries @app.after_request def log_queries(response): for q in get_debug_queries(): if q.duration > 0.05: # 超过 50ms 的慢查询 app.logger.warning(f'慢查询 {q.duration:.2f}s: {q.statement[:100]}') return response
启用 SQLALCHEMY_RECORD_QUERIES = True 后,每次请求的 SQL 与耗时都可见——N+1 一目了然。
工程实践要点
3.1 数据库优化
N+1 查询(3.2 提过)是最常见杀手:
# 慢:N+1 次查询 posts = Post.query.all() for p in posts: print(p.author.name) # 快:2 次查询 posts = Post.query.options(joinedload(Post.author)).all()
加索引:
class Post(db.Model): id = db.Column(db.Integer, primary_key=True) user_id = db.Column(db.Integer, db.ForeignKey('users.id'), index=True) status = db.Column(db.String(20), index=True) # 高频过滤字段加索引
只取需要的列:
# 慢:取整行 users = User.query.all() # 快:只取需要的列 users = db.session.query(User.id, User.username).all()
分页:列表接口/页面一律分页,禁止全量返回。
3.2 缓存策略
按"计算成本 × 变化频率"决定缓存什么:
| 数据 | 缓存方式 | 时长 |
|---|---|---|
| 热点页面 | @cache.cached(timeout=60) |
60s |
| 统计结果 | @cache.memoize(timeout=600) |
10min |
| 用户资料 | Redis 缓存 + 失效 | 可配置 |
| 配置/字典 | 进程内缓存 | 长期 |
from flask_caching import Cache cache = Cache() # 生产用 Redis app.config['CACHE_TYPE'] = 'RedisCache' app.config['CACHE_REDIS_URL'] = 'redis://localhost:6379/0' cache.init_app(app) @app.route('/hot') @cache.cached(timeout=60) def hot(): return render_template('hot.html') # 60 秒内直接返回缓存
注意:缓存要处理用户相关内容(key 带用户维度)与数据更新后的失效(写操作时 cache.delete(key))。
3.3 静态资源优化
- Nginx 直接服务:静态文件不经过 Python(2.7 讲过);
- 压缩合并:CSS/JS 压缩(如 Flask-Assets);
- CDN:静态资源上 CDN,边缘节点加速;
- 浏览器缓存:
expires 30d+ 内容哈希文件名。
3.4 并发配置
# Gunicorn worker 数:2~4 × CPU 核数 gunicorn -w 8 -b 127.0.0.1:8000 wsgi:app # 同步 vs 异步 worker # 同步 worker(默认):适合 IO 密集的 Flask 应用 # gevent worker:需要高并发的场景 gunicorn -k gevent -w 8 wsgi:app
数据库连接池:SQLAlchemy 默认有池,注意 pool_size 与 max_overflow 配置,防止 worker 数 × 连接数超数据库上限。
3.5 异步化慢操作
发邮件、生成报表、调用第三方 API——这些 IO 操作会阻塞 worker。用 Celery(3.6 讲过)异步化:
send_email.delay(email, content) # 立即返回,后台执行
决策树:遇到慢请求怎么办
性能优化决策树
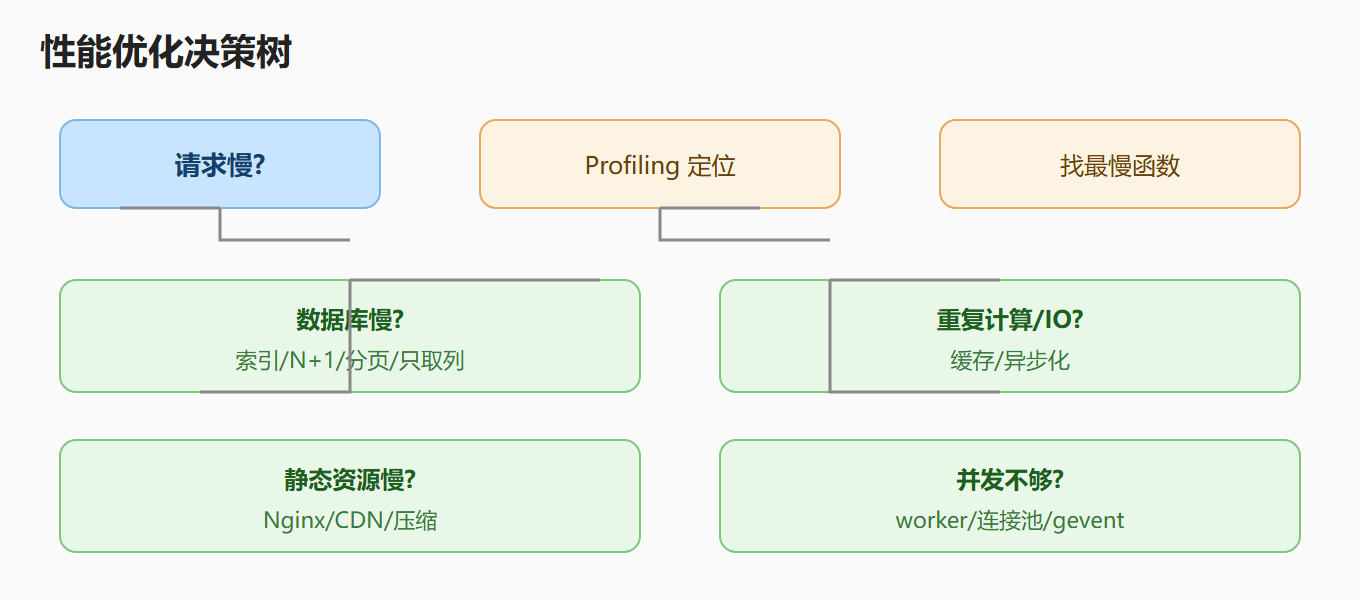
别优化的场景:请求频率极低、优化收益 < 开发成本、已有缓存但瓶颈在别处——先测量,让数据说话。
常见误区与排查
| 误区 | 现象 | 正解 |
|---|---|---|
| 凭感觉优化 | 白忙一场 | Profiling 先定位 |
| 忽视 N+1 | 页面随数据量变慢 | joinedload + 慢查询日志 |
| 缓存不加失效 | 数据过期/串台 | 写操作删缓存,key 区分用户 |
| 全量加载 | 内存暴涨 | 分页 + 只取需要的列 |
| worker 数拍脑袋 | 内存爆/CPU 空转 | 2~4 × CPU 核数 |
| 同步发邮件 | 请求卡顿 | 异步化 |
动手演练:优化一个慢接口
# 优化前:列表接口 @app.route('/api/posts') def list_posts(): posts = Post.query.all() # ① 全量查询 return jsonify([{ 'id': p.id, 'title': p.title, 'author': p.author.username, # ② 每次访问 author 触发查询 } for p in posts]) # 优化后 @app.route('/api/posts') @cache.cached(timeout=30, query_string=True) # ③ 缓存 30 秒 def list_posts(): pagination = Post.query.options( joinedload(Post.author) # ② 一次联表 ).order_by(Post.id.desc()).paginate( # ① 分页 page=request.args.get('page', 1, type=int), per_page=20) return jsonify({ 'items': [{'id': p.id, 'title': p.title, 'author': p.author.username} for p in pagination.items], 'total': pagination.total, })
三步走:全量→分页、N+1→联表、重复计算→缓存。再次压测,数据会告诉你提升多少。
温故知新
- 先测后优:没有 profiling 就没有优化依据。
- 数据库:N+1(joinedload)、索引、分页、只取需要的列。
- 缓存:页面缓存/函数缓存/Redis,注意失效与用户维度。
- 静态资源:Nginx 直出、CDN、压缩、浏览器缓存。
- 并发:worker 2~4×CPU、连接池、gevent 高并发。
- 异步化:IO 慢操作交给 Celery。
- 别盲目优化:让数据说话,收益低于成本就停。
深入理解:性能优化的思维与进阶
性能优化容易陷入"技巧堆砌",但真正的高手有系统方法。
第一,优化的对象是"感知",不只是"数据"。 用户感受到的慢 = 加载时间 + 交互响应 + 页面渲染。有时候"让页面看起来快"比"让数据真正快"更有效:骨架屏、渐进加载、预加载、加载动画——这些"感知优化"成本低、收益直观。先问"用户在哪个环节感到慢"再动手,比对着耗时数字瞎猜强。
第二,瓶颈的三种类型。 计算型(CPU 密集,如复杂算法):优化算法或分片并行;IO 型(数据库、网络、磁盘):缓存、连接池、异步;等待型(外部服务响应慢):超时、降级、异步化。同一段慢代码,不同原因不同解法——profiling 不仅告诉你"哪里慢",还要分析"为什么慢"。
第三,缓存的层级。 缓存不是一锤子买卖,而是分层组合:浏览器缓存(静态资源,减少请求)→ CDN(全球节点,加速分发)→ 反向代理缓存(Nginx,减轻应用压力)→ 应用缓存(Flask-Caching,避免重复计算)→ 数据库缓存(查询结果、连接池)。每一层解决一个层面的问题,组合起来才叫缓存体系。新手只做应用缓存,高手把每一层都用对。
第四,数据库是大多数 Web 应用的瓶颈核心。 当缓存无法解决根本问题时,回到数据库:索引设计(explain 看执行计划)、查询改写(避免 SELECT *、合理 JOIN)、读写分离(主库写、从库读)、分库分表(超大规模)。学习顺序建议:先学 explain 看懂执行计划——90% 的慢查询都能通过"加索引或改写法"解决,这是性价比最高的数据库优化。
第五,容量规划与压测。 上线前做压力测试(如 Locust、wrk),知道应用的极限:多少并发开始变慢、多少并发开始报错、资源(CPU/内存)在什么水位。压测数据是"什么时候该扩容"的依据——没有压测的扩容决策都是拍脑袋。注意压测要在类生产环境做,压测本身也消耗资源。
第六,性能的"度":够用就好。 99.99% 的接口不需要微秒级优化。把优化预算花在"用户真的觉得慢"的路径上:首屏、核心操作、大列表。冷门的后台功能、内部分析接口,能用就行。性能优化是投资,不是信仰——每一分优化成本都要有对应的收益理由。