2.3 数据格式与处理
2.3 数据格式与处理
本节摘要:Ajax 的"A"管怎么传,数据格式管"传什么"。同样的业务数据,用 XML、JSON、表单编码还是纯文本,体积可能差好几倍,解析代码量差十倍。本节用一份数据在四种格式下的真实形态做对比,讲清 JSON 成为事实标准的原因、序列化与解析的细节坑(特殊值、日期、循环引用、数字精度),并给出按场景选型的判断表。
一段数据,四种包装
先把实验材料摆出来:一条用户数据,含编号、姓名、邮箱、角色数组和注册时间。分别用四种格式包装。
JSON 形态:
{ "id": 1001, "name": "李雷", "email": "lilei@example.com", "roles": ["admin", "editor"], "registeredAt": "2024-03-15T08:30:00Z" }
XML 形态:
<user id="1001"> <name>李雷</name> <email>lilei@example.com</email> <roles> <role>admin</role> <role>editor</role> </roles> <registeredAt>2024-03-15T08:30:00Z</registeredAt> </user>
表单编码形态:
id=1001&name=%E6%9D%8E%E9%9B%B7&email=lilei%40example.com&roles=admin&roles=editor®isteredAt=2024-03-15T08%3A30%3A00Z
纯文本形态(自定义分隔符):
1001|李雷|lilei@example.com|admin,editor|2024-03-15T08:30:00Z
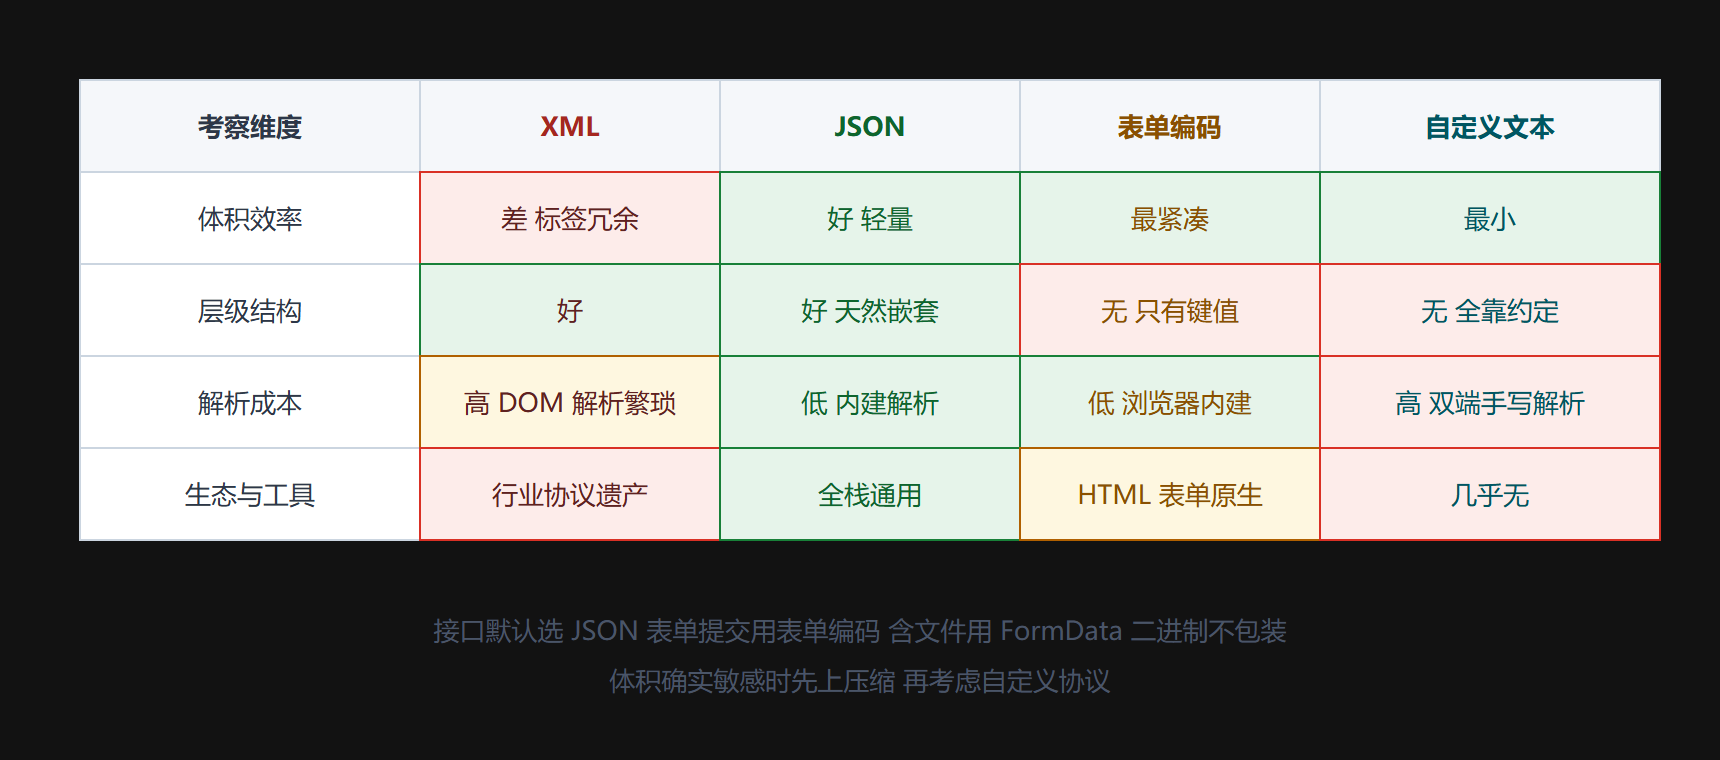
四种包装承载的信息完全相同,但工程属性截然不同。JSON 约 140 字符;XML 约 230 字符,多出来的全是标签重复;表单编码最紧凑但表达不了层级(roles 只能靠重复键名硬撑);纯文本最省字节,却要前后端各自手写解析器,转义规则全凭口头约定。
四种格式工程属性对比
数据格式能力对比矩阵
一、JSON 为什么赢了
JSON(JavaScript Object Notation)的胜利不是宣传战的胜利,是三项工程属性的合力。
第一,结构直译。JSON 的对象、数组、字符串、数字、布尔、null,与 JavaScript 的数据类型一一对应。JSON.parse 的结果就是可以直接操作的值——data.users[0].roles.includes('admin'),取值路径和肉眼看 JSON 文件的路径完全一致。对比 XML:先拿 Document 对象,再按标签名查节点集合,逐个取 textContent,代码量是 JSON 的五到十倍:
// XML 解析同样的用户数据 const doc = xhr.responseXML; const users = doc.getElementsByTagName('user'); for (const u of users) { const id = u.getAttribute('id'); const name = u.getElementsByTagName('name')[0].textContent; const roles = Array.from(u.getElementsByTagName('role')) .map(r => r.textContent); renderRow(id, name, roles); } // JSON 解析 路径直译 肉眼所见即代码所写 const data = xhr.response; // responseType 已设 json data.users.forEach(u => renderRow(u.id, u.name, u.roles));
**第二,全栈同构。**JSON 起于 JavaScript 但不困于它:Java、Python、Go、PHP 的标准库或事实标准库都提供 JSON 序列化。前后端之间不需要"翻译层",数据结构在两端以同样的形状存在——这让 JSON 成为天然的数据契约载体。
**第三,体积与解析速度的平衡。**去掉开闭标签的冗余后,同等信息 JSON 比 XML 小四到六成;配合 HTTP 传输层的 gzip 压缩(真实接口几乎总是开启),到达浏览器的体积再砍一半以上。解析侧,JSON.parse 是浏览器内建的本地实现,速度远快于 XML 的 DOM 构建。
历史地看,"Ajax"这个名字里那个 X,从 2005 年前后就开始名存实亡——Garrett 造词时 XML 还是主流,短短几年后 JSON 已是一线大厂接口的默认格式。这提醒我们:名字会撒谎,工程属性不会。
二、序列化与解析的细节坑
JSON.stringify 与 JSON.parse 看似一行搞定,边界情况全藏在细节里。
**坑一:undefined 与函数会消失。**序列化时,值为 undefined 的属性直接被丢弃,函数与 Symbol 同样被跳过;数组里的 undefined 则变成 null。发给接口的对象里"少了个字段",往往不是你没赋值,而是赋的是 undefined 被序列化器静默开除了:
JSON.stringify({ a: 1, b: undefined, c: null }); // 结果 {"a":1,"c":null} b 不见了 JSON.stringify({ run() {} }); // 结果 {}
坑二:日期没有原生类型。JSON 只有字符串,Date 对象序列化后变成 ISO 字符串(这是个坑也是个约定)——反过来,JSON.parse 不会把日期字符串还原成 Date,拿到的是字符串。日期必须手动双向转换,且接口约定统一用 ISO 8601 格式(含时区),否则"2024-03-15"到底是哪的十五号,两端各执一词。
坑三:大整数精度。JSON 数字按双精度浮点处理,安全整数上限约 9 千万亿(2 的 53 次方减一)。数据库自增 ID 或雪花 ID 一旦超过这个数(后端用长整型很容易超过),序列化后末几位变成 0——用户 ID 从 9007199254740993 静默变成 9007199254740992,查谁都不是。解法是后端把长整型按字符串输出,这是支付与账务系统的铁律。
**坑四:循环引用直接抛错。**对象互相引用时 stringify 抛异常,且不会自动跳过。在把 DOM 节点或复杂数据结构直接往接口塞之前,先想清楚里面有没有环。
坑五:解析失败必须接住。JSON.parse 遇到非法文本抛异常。响应体被网关改写、CDN 注入了错误页 HTML、编码错乱,都会让"看起来是 JSON 的响应"解析崩掉。裸解析不捕获 = 白屏:
let data; try { data = JSON.parse(text); } catch (e) { showFallback(); // 至少给出兜底 UI reportError(e, text); // 上报原始文本 便于定位 return; }
坑六:顶层裸值。JSON.parse('2024') 合法(数字是合法 JSON),JSON.parse('undefined') 抛错。判断"响应是不是 JSON"别靠 try 一个莽字,先看响应头的 Content-Type 再动手,两道防线比一道稳。
三、表单编码与 FormData:键值世界的两代方案
表单编码(application/x-www-form-urlencoded)是 HTML 表单的默认格式:键值对用 & 连接、值做百分号编码。它只能表达扁平键值(数组靠重复键名),但浏览器与所有服务端框架都原生支持,今天仍是简单提交的合理选择。手工构造时记得对键值都编码:
const body = new URLSearchParams({ page: 2, keyword: 'a&b' }); // toString 自动编码 page=2&keyword=a%26b 且原生类型可直接作为请求体 fetch('/api/list', { method: 'POST', body });
URLSearchParams 作为请求体时,浏览器自动设置正确的表单 Content-Type——比手工拼字符串再手动编码安全得多。
FormData 是它的现代升级版:可携带文件、可 append 多值、可嵌套 Blob。3.2 与 4.3 节的表单提交与文件上传都靠它。与 JSON 的关键差异是:FormData 的值只能是字符串、Blob 或文件,复杂对象结构要先序列化。一个常见的混搭做法是"文件走 FormData 字段、复杂配置作为一个 JSON 字符串字段":
const fd = new FormData(); fd.append('file', fileInput.files[0]); fd.append('meta', JSON.stringify({ title, tags })); // 对象压成字符串再放
四、二进制:Blob 与 ArrayBuffer
XHR 与 Fetch 都能接收二进制响应(2.1 节的 responseType),而 Ajax 也能发送二进制。典型场景:图片直传对象存储、音频录制上传、导出文件下载。
Blob 是"不可变二进制大对象"的高级封装,带 MIME 类型信息,适合整体处理(生成对象 URL、直接上传);ArrayBuffer 是原始字节缓冲,配合类型化数组做逐字节加工(解析二进制协议、加密、音频采样)。
// 把 canvas 内容转成 Blob 再上传 canvas.toBlob(blob => { const xhr = new XMLHttpRequest(); xhr.open('POST', '/api/avatars'); xhr.upload.onprogress = e => updateBar(e.loaded / e.total); xhr.send(blob); // 二进制直接作为请求体 }, 'image/png');
五、选型判断表
| 场景 | 推荐格式 | 理由 |
|---|---|---|
| 常规数据接口 | JSON | 全栈同构、解析内建、生态完备 |
| 传统表单提交改造 | 表单编码或 FormData | 与 HTML 表单和服务端框架默认行为兼容 |
| 带文件的提交 | FormData | 唯一原生支持多部分文件上传的格式 |
| 图片、音视频、文件传输 | 二进制(Blob 或 ArrayBuffer) | 数据本来就是字节,包装成文本反而膨胀三成 |
| 与遗留 SOAP 类系统对接 | XML | 对方说了算,按协议来 |
| 极致体积敏感的内部高频接口 | 压缩 JSON 起步 | 先确认 gzip 开了没有,再谈自定义二进制协议 |
💡 选型直觉一句话:默认 JSON,表单走表单,文件走 FormData,字节走二进制。除非有明确的量化证据,否则不要为省几个字节引入自定义格式——解析器、转义规则、版本兼容的维护成本,很快会吃掉省下的流量。
常见疑问解答
JSON 里的中文需要转义吗
传输层不需要。UTF-8 编码下中文原样传输是合法的;JSON.stringify 默认不转义非 ASCII 字符(部分服务端库会转成 \uXXXX 形式,两者等价,解析后相同)。需要手动转义的场景极少。
响应体很大,JSON.parse 会卡页面吗
会。解析是同步操作,几 MB 的 JSON 在低端机上可能耗时上百毫秒。优化顺序:先质疑接口为什么要返回这么大(分页、裁剪字段),再考虑流式处理或分块解析方案。别一上来就上"高性能解析库"。
为什么不直接传 JavaScript 代码回来执行
早年真有这种做法(返回可 eval 的脚本),它正是 XSS 攻击的温床——执行服务端返回的代码等于把页面控制权交了出去。数据与代码必须分离,这是现代前端安全的地基之一,4.2 节展开。
本节要点回顾
- JSON 赢在结构直译、全栈同构、体积解析平衡三项工程属性,名字里的 XML 早已名存实亡。
- 序列化六个坑:undefined 与函数被静默丢弃、日期无原生类型、大整数精度丢失、循环引用抛错、解析必须捕获、别裸信响应体。
- 长整型 ID 按字符串传输是账务类系统的铁律,双精度浮点装不下 64 位整数。
- FormData 承接表单与文件,复杂对象作为 JSON 字符串字段混搭;URLSearchParams 免去手工编码。
- 二进制不包装:Blob 整体处理,ArrayBuffer 逐字节加工。
- 选型口诀:默认 JSON,表单走表单,文件走 FormData,字节走二进制;体积敏感先开压缩再谈自定义协议。
一个校验层的完整实现
把本节的坑收进一个可复用的数据校验函数里——它解决的是第四层"数据错误"里最隐蔽的部分:结构不符合预期。拿到接口数据先过一道形状检查,坏数据在入口被拦截,而不是在渲染深处以莫名异常爆出:
function assertShape(data, spec, path = 'data') { for (const [field, rule] of Object.entries(spec)) { const value = data?.[field]; if (value === undefined || value === null) { if (rule.required) throw new Error(path + '.' + field + ' 缺失'); continue; // 可选字段缺省 放行 } if (rule.type === 'array' && !Array.isArray(value)) { throw new Error(path + '.' + field + ' 应为数组'); } if (rule.type === 'number' && typeof value !== 'number') { throw new Error(path + '.' + field + ' 应为数字'); } } } // 使用:接口契约写成声明式规格 assertShape(body, { code: { type: 'number', required: true }, data: { type: 'object', required: true }, message: { type: 'string', required: false } });
这段二十行的实现刻意保持朴素:真实项目里通常用现成的结构校验方案(JSON Schema 系),但思路是一样的——把接口契约写成可执行的规格,让"后端悄悄改了字段名"从三天后的用户反馈,变成发布当晚的明确报错。配套的纪律是规格与文档同步演化:契约变更时先改规格、再改两端代码,规格本身就是活文档(2.4 节的接口纪律在这里落地成代码)。
顺带把日期问题在这里收口:带日期字段的接口,规格检查之外加一道格式断言(ISO 8601 的正则校验),不合规直接拒绝——比让一个"2024-13-45"悄悄漏进渲染层、显示成诡异日期体面得多。
序列化速查与最后忠告
把 stringify 侧的行为压成一张随身速查:字符串数字布尔与 null 原样输出;undefined 与函数作为对象属性时被静默丢弃、作为数组元素时变成 null;Date 变 ISO 字符串、不自动还原;超过安全范围的整数末位失真;循环引用直接抛错;对象里的 toJSON 方法会在序列化时被优先调用(这也是很多库实现自定义序列化的钩子)。parse 侧记住两条:非法文本抛异常必须捕获;解析的结果与原对象只在数据层等价,原型、方法、日期类型全部丢失——反序列化后得到的是"纯数据",需要行为就要重建对象。
最后给一个跨语言协作的忠告:JSON 看似两端同构,字符集与数字精度是两处最容易翻车的地方。字符集层面,请求与响应都应显式使用 UTF-8,老系统默认本地编码时中文会变成问号或乱码,这类问题在混合团队的新旧接口对接里至今常见。精度层面,除了前文讲过的长整型转字符串,浮点数的表示差异(某些语言序列化浮点的方式与 JavaScript 不完全一致)也值得在金额类字段上警惕——金额用字符串或整数分值传输,是账务系统的通行做法。数据格式的坑大多不在"格式本身",而在两端对格式的理解有细微出入;契约写清楚、校验做在入口,出入就无处遁形。实际团队里值得推行的做法是把这份契约规格放进代码仓库与接口文档同步维护,评审时格式变更与逻辑变更一视同仁地过目——格式是数据的宪法,改宪法不该比改函数更随意。