3.3 动态内容加载与局部更新
3.3 动态内容加载与局部更新
本节摘要:局部更新是 Ajax 的灵魂,但"把数据变成页面"这一步藏着最多的问题:更新范围怎么界定、服务端返回的 HTML 片段能不能直接插、innerHTML 与 textContent 的安全边界在哪、加载态与空态怎么设计才不突兀。本节从一次"插入服务端 HTML 后页面失控"的事故出发,把这些工程问题逐个解决。
事故现场:一段"能跑"的代码埋着雷
内容管理后台,文章列表支持按关键词过滤。开发者为了省事,让服务端直接返回拼好的 HTML 片段,前端一行插入:
const res = await fetch('/api/articles?q=' + kw); const html = await res.text(); container.innerHTML = html; // 一步到位 看起来很省
上线两周后出事:有用户在文章标题里输入了一段脚本标签,所有浏览这个列表的人都会执行它——存储型 XSS。同时还有一个慢性问题:每次过滤都把整个容器 innerHTML 整个替换,表格重新渲染时闪烁、用户的选中态丢失,滚动位置在内容变短时乱跳。
两个问题指向同一处:"怎么把数据安全、精准地放进页面"从来不是一个简单的赋值语句。这一节就把这个动作拆开讲清楚。
局部更新的决策视图
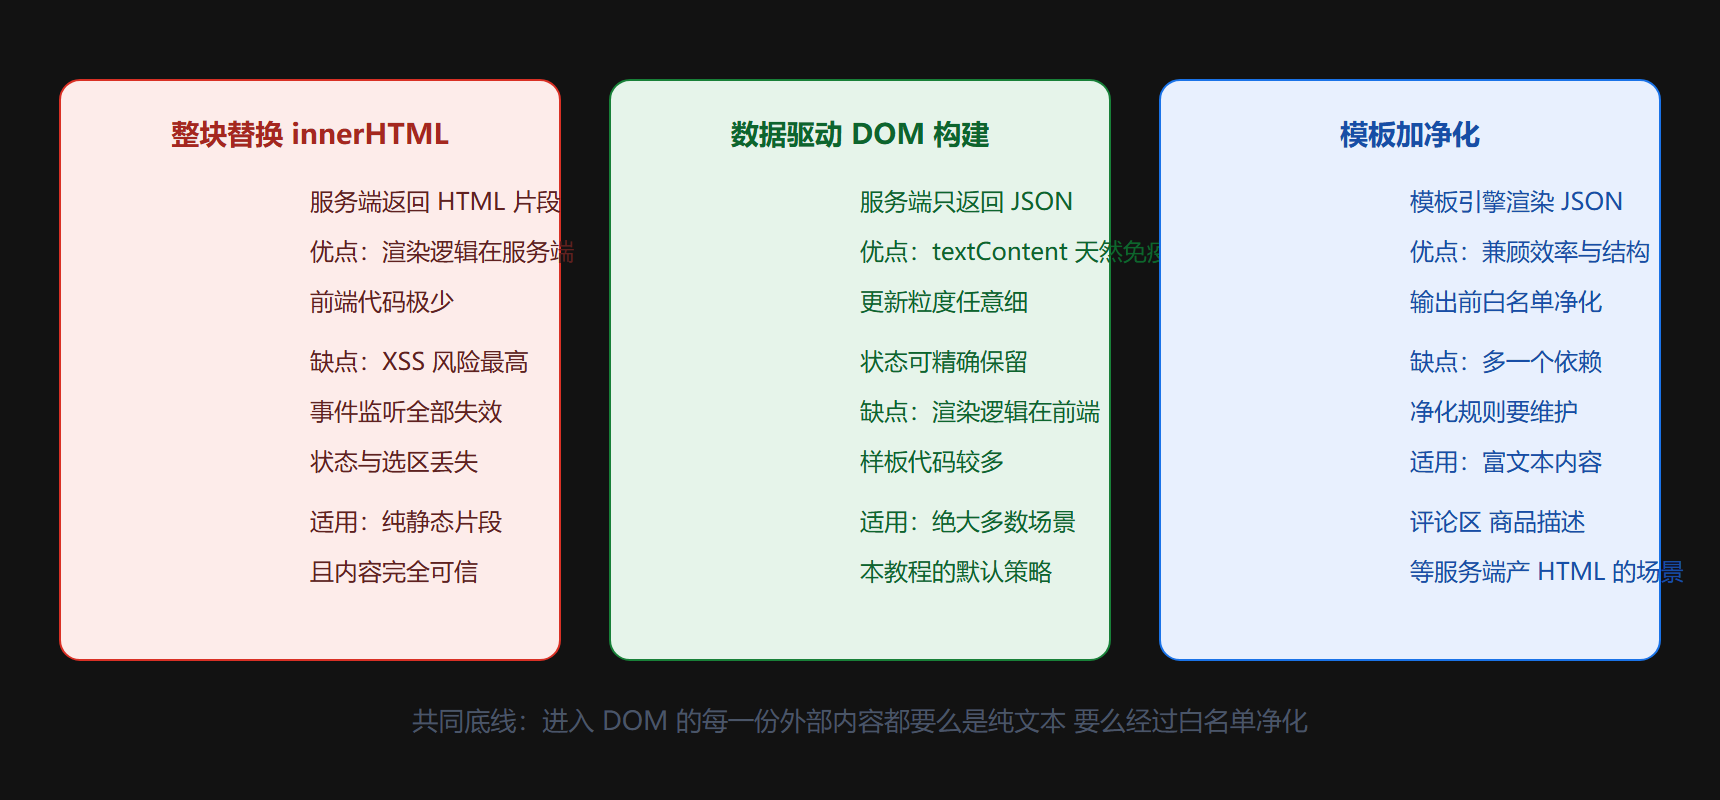
局部更新的三种策略对比
一、先界定"该更新的最小区域"
动手更新之前先回答:这次变化真正涉及哪些元素?把范围想小,收益是三重的:渲染开销小、用户状态保留多、出错波及面窄。
一个典型误区是"拿数据回来就整块重画"——明明只是数字变了,却把整个卡片重建成新节点。节点一重建,附着在旧节点上的一切(事件监听、表单输入值、CSS 过渡状态、文本选区)全部归零。这就是很多列表页"一刷新输入框就清空"的根因。
正确的粒度分层:
整页数据变化 → 重建列表容器(分页切换的场景) 列表局部变化 → 只动受影响的行(点赞数变化只改那行的数字节点) 单个值变化 → 只改那个文本节点(3.1 节的角标例子)
按这个分层,开头事故里的过滤场景应该这样做:数据仍是 JSON,过滤后逐行对比,新增的行插入、消失的行移除、保留的行不动——这正是虚拟 DOM 类框架替你自动做的事。手写时不必做到极致,但"能改文本就别换节点,能换节点就别重画容器"的方向感要有。
二、三种更新策略与安全边界
**策略一:innerHTML 整块替换。**省事但有两条硬代价。安全上,插入的 HTML 里任何脚本载体(script 标签、事件属性、伪造的标签结构)都会进入文档,等于把容器控制权交了出去——开头的事故就是这条;状态上,替换范围内所有节点被销毁重建,监听与输入丢失。它只适合"内容完全可信的静态片段"这个窄场景,且现代项目里这个前提越来越难成立。
**策略二:DOM API 数据驱动构建(默认推荐)。**服务端给 JSON,前端 createElement 加 textContent 构建。textContent 把一切内容当纯文本,注入尝试只会显示成字面文字,天然免疫 XSS:
function renderList(container, articles) { container.replaceChildren(); // 清空 一步到位 for (const a of articles) { const row = document.createElement('div'); row.className = 'article-row'; const title = document.createElement('h3'); title.textContent = a.title; // 用户输入原样显示 不执行 const meta = document.createElement('span'); meta.textContent = a.author + ' · ' + a.views + ' 次浏览'; row.append(title, meta); row.addEventListener('click', () => openArticle(a.id)); // 事件挂在新节点上 container.appendChild(row); } }
注意事件的处理方式:新构建的节点上直接挂监听;如果列表频繁重建,改用容器上的事件委托(在父元素监听,通过事件的 target 判断点了哪行),节点换血监听不丢,也是列表场景的标准做法。
**策略三:模板加净化,给富文本留的门。**评论区、商品详情这类场景,内容确实需要格式(加粗、换行、链接)。两条路:前端模板引擎把 JSON 渲染成 HTML(模板引擎默认对插值转义,危险主要来自显式标记"不转义"的输出),或服务端直接产出 HTML 片段。无论哪条路,进入 innerHTML 之前过一道白名单净化是铁律——保留允许的标签与属性,剥掉一切脚本载体:
// 概念示意:白名单净化库的典型用法 const clean = sanitizeHtml(richContent, { allowedTags: ['p', 'b', 'i', 'em', 'strong', 'a'], allowedAttributes: { a: ['href'] } }); container.innerHTML = clean;
⚠️ 净化的原则是白名单而不是黑名单。列举"危险的标签"永远列不全——载体可以是标签、属性、伪协议、编码变体;只有"只允许明确安全的"才是可证明的安全边界。自写正则过滤 HTML 是事故高发区,请用经过公开检验的净化库。
三、加载态:数据到达之前的体面
局部更新把"白屏"消灭了,但取而代之的问题是:**数据在路上时,那块区域显示什么?**三种常见做法,按场景选:
文本提示("加载中…"):实现成本最低,适合低频小区域。缺点是布局抖动——文本一行高,数据来了变成十几行,页面明显跳动。
骨架屏:用灰色占位块模拟即将出现的内容布局,高度与真实内容接近,数据到达后替换。视觉平稳很多,是列表与卡片流的主流选择:
function showSkeleton(container, rows = 5) { container.replaceChildren(); for (let i = 0; i < rows; i++) { const s = document.createElement('div'); s.className = 'skeleton-row'; // CSS 画灰色块与微光动画 container.appendChild(s); } } showSkeleton(container); const data = await request('/api/articles'); renderList(container, data);
保留旧内容加轻提示:筛选已有数据的场景,旧列表先留着,顶部或角标提示"更新中"。用户能继续读旧内容,无感知完成换血。
一个容易被忽略的细节:加载态要区分"首次"与"再次"。首次进入没有旧内容,必须骨架屏;再次刷新有旧内容,保留旧内容加提示往往比再闪一次骨架更体面。用容器里有没有内容做分支即可。
四、空态与错误态:两个最常被遗忘的分支
列表渲染代码通常只写两个分支——加载中、有数据。剩下两个分支缺失时,用户看到的是一片莫名的空白:
function renderListWithStates(container, articles) { if (articles.length === 0) { // 空态 container.replaceChildren(); const empty = document.createElement('div'); empty.className = 'empty-state'; empty.textContent = '还没有文章,点击右上角创建第一篇'; container.appendChild(empty); return; } renderList(container, articles); // 正常态 }
空态的原则:告诉用户"为什么是空的"和"接下来能做什么"。"暂无数据"是偷懒写法,"还没有文章,去创建第一篇"才把死路变成动线。错误态同理(3.1 节的错误分支已示范),再加上"重试"按钮——把恢复的主动权交给用户,比让他刷新整个页面温柔得多。
四种状态合起来,才是局部更新的完整状态机:
加载中(骨架屏) ──► 有数据(列表) ──┐ ──► 空态(引导动作) ──┼──► 重新加载时回到加载中 ──► 错误态(重试按钮) ──┘
五、插入位置与批量更新:DOM 操作的最后两个细节
数据不一定总是"替换整个容器"。精确插入用 insertAdjacentHTML 的位置语义(beforebegin、afterbegin、beforeend、afterend),或 insertBefore、append 的节点系 API。无限滚动"往底部追加"就是 beforeend 的典型用法(3.4 节完整实现)。
批量插入大量节点时注意重排次数:循环里逐个 appendChild,每次都可能触发一次布局计算。用文档片段先把节点攒齐再一次挂载,浏览器只重排一次:
const frag = document.createDocumentFragment(); for (const a of articles) frag.appendChild(buildRow(a)); container.appendChild(frag); // 一次挂载 一次重排
列表上百行、每秒多次更新的场景(实时行情、日志流),这个细节与"只更新变化行"的粒度控制叠加,就是手写渲染的性能天花板——再往上就是虚拟 DOM 与增量渲染框架的领域了。
常见疑问解答
服务端返回 HTML 片段就一定不安全吗
内容完全可控(不含任何用户输入)时风险确实很低。但"完全可控"会随业务演化悄悄失效——今天纯静态的栏目,明天产品经理就要加"显示用户昵称"。安全边界要按最坏未来设计,而不只按当下现状。
骨架屏和转圈 spinner 选哪个
区域大、布局可预期(列表、卡片)用骨架屏;区域小或形状不定(一个小按钮的确认请求)用 spinner 或按钮内状态。原则是占位形状越接近真实内容,布局跳动越小。
事件委托会不会影响性能
不会,反而省内存——一千行列表从一千个监听变成容器上一个。注意委托里判断 target 时要处理嵌套(点到行内子元素时向上找到绑数据的祖先节点)。
本节要点回顾
- 更新前先界定最小区域:能改文本就别换节点,能换节点就别重画容器;节点重建会带走监听与状态。
- 三种策略:innerHTML 只用于可信静态片段;数据驱动加 textContent 是默认;富文本走模板加白名单净化。
- 净化用白名单不用黑名单,自写正则过滤 HTML 是事故高发区。
- 四态状态机:骨架屏加载、正常、带引导的空态、带重试的错误态,一个都不能少;首次与再次加载要区分处理。
- 批量插入用文档片段,一次挂载一次重排;列表事件优先委托到容器。
一张渲染决策速查卡
把本节的渲染策略压缩成随身速查卡,写渲染代码前扫一眼:
数据是纯文本字段 → createElement 加 textContent,没有第二种答案。数据需要简单格式(加粗、换行)→ 后端返回结构化标记或段落字段,前端按结构构建元素,比整段 HTML 净化更干净。数据是富文本(用户产生的 HTML)→ 白名单净化后 innerHTML,净化库与规则进代码评审。数据是列表 → 文档片段批量构建、容器级事件委托、四态状态机一个不少。数据是单个值 → 直接改文本节点,别碰容器。
卡片背后还有一条元原则值得点明:渲染策略的选择本质是信任边界的划定。textContent 说"我谁都不信",模板说"我信结构不信插值",白名单净化说"我信标签子集不信其他",innerHTML 裸插说"我全信"——最后一种在接外部数据的页面上等于不设防。每写一行渲染代码,其实都在回答"这份数据我信到哪一层";想清楚再写,安全与维护性问题会同时少一大截。
最后补一个与更新粒度相关的实战经验:什么时候值得从"整块重建"升级到"按行对比更新"?判断依据是用户是否感知到重建的副作用。列表没有内部状态(纯展示)、重建频率低(翻页一次),整块重建毫无问题,别为优雅过度设计;列表行内有输入框、展开态、选中框,或更新频率高(实时刷新),就必须做增量更新——按业务主键对旧行与新数据配对,配得上的更新内容、配不上的删除、新的插入。虚拟 DOM 框架把这套对比自动化了,但理解"为什么要对比"的人,才能在框架的渲染性能出问题时读懂它给出的警告。最后给一个可以直接执行的巩固动作:打开自己项目里最复杂的那块动态区域,说出它的数据来源、更新粒度、信任边界与四态覆盖情况——四问都答得干脆,本节就真正落地了;任何一问答得犹豫,对应段落就是你的下一站。这个四问自查往后会在每个新页面的开工前用上,成本半分钟,挡掉的却是整类渲染事故。更妙的是它可传承:把四问写进团队的页面开发检查单,新人照着问一遍,等于把老员工踩过的坑一次性复述给他听——组织的经验,就藏在这些看似啰嗦的固定问题里。