5.1 Ajax 常用库与框架
5.1 Ajax 常用库与框架
本节摘要:原生 Fetch 已经够用,为什么还有一半项目在用 Axios?本节横向对比 jQuery ajax、Axios 与原生 Fetch 的能力差异(拦截器、取消、错误语义、自动 JSON),说明各自的历史使命与当代定位;再往上一层看 React Query、SWR 这代"请求状态管理库"把缓存、去重、竞态做成了默认能力之后,自建请求层还剩什么价值——以及怎么选。
一个问题引出整个生态
团队新开一个项目,请求方案选什么?候选名单上至少四个:原生 Fetch、Axios、框架配套的请求库、请求状态管理库(React Query 类)。每个都有人举手支持,理由听起来都对。
这个问题没有标准答案,但有标准判断框架:看每个方案到底替你解决了什么原生 Fetch 不管的事。而要看懂这一点,得先回到"裸写时代"的痛点清单——前几章我们已经把这份清单写得很全了:错误分类与统一收口(3.5 节)、超时取消重试(4.4 节)、在途去重与短缓存(4.1 节)、竞态防护(3.6 节)、鉴权注入与刷新重放(2.4 节)。生态的每一层,都是把这份清单里的一段做成了产品。
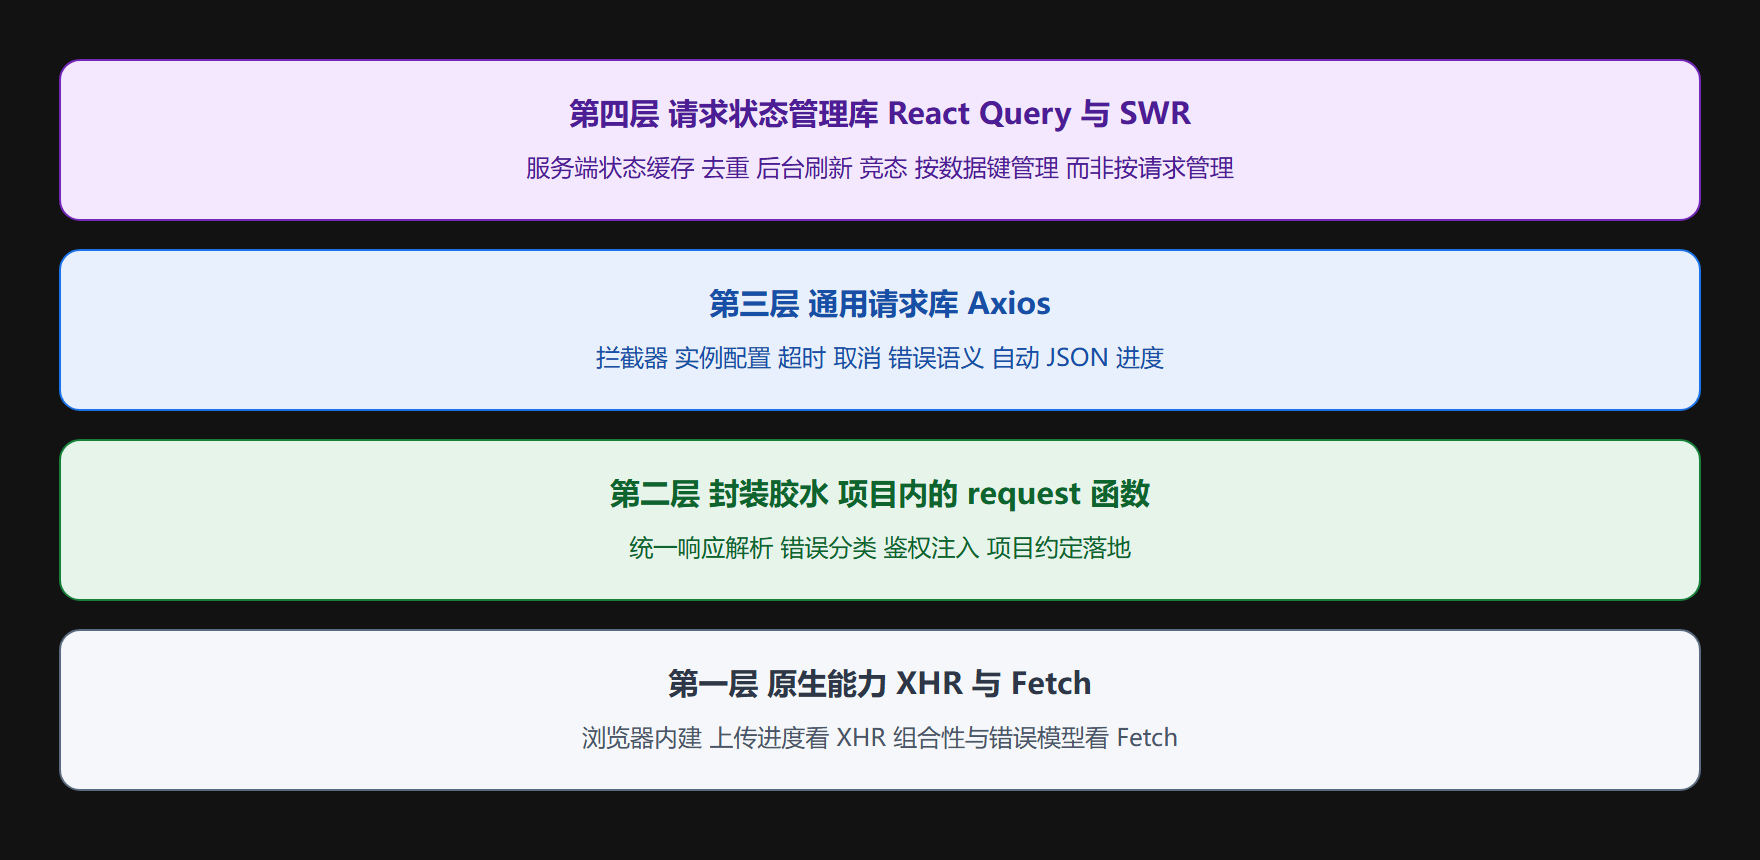
请求方案生态地图
前端请求方案的能力分层
一、jQuery ajax:历史使命已完成
2006 年 jQuery 的 ajax 方法把两件事做到了极致:跨浏览器兼容(IE 的 ActiveX 与标准 XHR 的差异被彻底抹平,1.2 节讲过这段)与链式回调的可用性(success、error、complete 的语义划分,比裸 onreadystatechange 友好太多)。在它流行的年代,"会用 jQuery 发请求"几乎等于"会 Ajax"。
今天它的历史使命基本完成:兼容性问题随老浏览器退场而消失,Promise 与 Fetch 成为标准能力。仍在用 jQuery ajax 的合理场景只剩下:维护存量 jQuery 项目、依赖 jQuery 插件生态的老页面。新项目专门为此引入 jQuery 不划算——它的核心卖点(兼容与简化 DOM)已经不是当代痛点。
但它的遗产值得记一笔:$.ajax 的配置项设计(url、method、data、success、error、beforeSend)深远影响了后来所有请求库的 API 风格——你在 Axios 配置里看到的字段,多半能在这里找到原型。
二、Fetch:标准能力的天花板与地板
Fetch 的定位是浏览器原生标准:Promise 化的组合模型、Request 与 Response 抽象、流式响应体。3.x 章的所有实战代码都以它为基础。
它的取舍非常"标准件":能力给到位,但一事一价,不打包赠送。想要超时?自己包 AbortController(4.4 节)。HTTP 404 不当错误?自己查 response.ok(3.1 节)。JSON 解析?自己 await res.json()。拦截器、统一前缀、自动重试?不存在的,全部自己写。
这不是缺陷是定位:标准层就该薄。项目小、请求少、约定简单时,薄就是优点——一个四十行的 request 函数(4.4 节)就能覆盖全部需求,零依赖。项目大、约定多(多环境前缀、统一鉴权、全链路埋点)时,薄就变成累赘——你在每个项目里重写同一套胶水。这就给 Axios 留出了空间。
三、Axios:把胶水做成了产品
Axios 解决的正是"每个项目都在重写的胶水",核心能力五件,对照前几章的手写版本看最清楚:
拦截器——请求与响应双向的统一处理点,相当于 2.4 节的鉴权注入与 3.5 节的错误翻译的官方位置:
const http = axios.create({ baseURL: '/api', timeout: 8000 }); http.interceptors.request.use(config => { const token = getStoredToken(); if (token) config.headers.Authorization = 'Bearer ' + token; // 统一鉴权 return config; }); http.interceptors.response.use( res => { if (res.data.code !== 0) return Promise.reject(res.data); // 业务错误翻译 return res.data.data; // 直接给业务数据 }, err => { if (err.response?.status === 401) redirectLogin(); // 统一分流 return Promise.reject(normalizeError(err)); // 3.5 节的 ApiError } );
错误语义——HTTP 错误直接 reject(纠正了 Fetch 最遭诟病的设计),err.response 里带齐状态码、头、响应体,err.code 区分网络与超时(ECONNABORTED)。3.5 节手写的错误分类,这里是内建的。
实例配置——baseURL、超时、默认头按实例隔离:内部接口一个实例、第三方开放平台一个实例,各自的环境变量与限流策略互不干扰。
取消——早期用自己的取消令牌,后来统一到 AbortController(4.4 节的机制原样可用)。
进度与适配器——上传下载进度事件直接可用(底层就是 2.1 节的 XHR);同构设计让它在 Node 端也能跑(服务端渲染场景同一套代码)。
什么时候不用它:对包体积极敏感(Axios 十几 KB,Fetch 零 KB)、只需要一两个简单请求、或团队已决定把胶水放在请求状态库那层。另外注意 Axios 的自动 JSON 是双向的(发对象自动序列化加头、收 JSON 自动解析),方便但对非 JSON 响应(4.3 节的下载)要记得改 responseType,这个"自动"偶尔会咬人。
四、React Query 与 SWR:把缓存做成世界观
再往上一层的变化是世界观的转变:前几层的库都在回答"怎么发好一个请求",这一层回答的是"怎么管理服务端数据"。
核心洞察:服务端数据在组件树里的本质是带缓存的共享状态。传统方案里,取数、加载态、错误态、缓存、竞态全靠组件自己操心(或靠全局状态库硬扛——把服务端数据塞进全局 store 是长久的错配)。React Query 这代库把它们变成声明式的:
// 声明这个组件需要 articles 这份数据 其余交给库 const { data, isLoading, error, refetch } = useQuery({ queryKey: ['articles', page], queryFn: () => fetch('/api/articles?page=' + page).then(r => r.json()), staleTime: 30_000 // 30 秒内视为新鲜 });
一小段代码背后,前几章的清单被整批收编:相同 queryKey 的在途去重(4.1 节的 inflight Map)、新鲜度控制与后台刷新(缓存不再靠手写 TTL)、窗口聚焦重新验证(切回标签页自动更新数据)、分页与加载更多的游标管理(3.4 节的无限滚动有内建 hook)、竞态防护(键变自动废弃旧请求)、重试(内建退避)。注意 queryFn 里用的还是原生 Fetch——这一层不替代 Fetch,而是在其上管理数据,分层图的上下两块是叠加关系。
代价与边界:它是框架绑定的(React 生态一套、Vue 一套)、概念不轻(查询、变更、失效、缓存键的设计要学)、对"一次性的命令式请求"(提交表单后跳转)反而绕。适合数据密集的 SPA(列表、仪表盘、社交 feed),不适合简单页面与框架无关的场合。
五、怎么选:一张决策表
| 场景特征 | 推荐 | 理由 |
|---|---|---|
| 小项目、少量请求、约定简单 | 原生 Fetch 加 40 行封装 | 零依赖,4.4 节的骨架够用 |
| 中大型项目、多环境、统一鉴权埋点 | Axios(或同类)加拦截器 | 胶水产品化,团队约定有官方落点 |
| 数据密集 SPA、缓存与刷新需求重 | 请求状态库(内部仍用 Fetch 或 Axios) | 服务端状态管理的世界观红利 |
| 存量 jQuery 项目 | 维持 jQuery ajax | 迁移成本大于收益时别折腾 |
| 服务端渲染同构需求 | Fetch 或 Axios | 前者零依赖,后者适配器成熟 |
选择之外还有一条不变的判断:无论选哪层,前几章的底层知识都在其下生效——Axios 的超时参数就是 4.4 节的 AbortController,React Query 的后台刷新就是 4.1 节的缓存策略。库是知识的产品化,不是知识的替代品。反过来,读懂这些库的源码思路(拦截器的洋葱模型、缓存键的失效传播)也依赖这份知识做地图。
常见疑问解答
学了这么多库,面试考什么
考的恰恰是底层:Fetch 与 XHR 的差异、HTTP 错误为什么 Fetch 不 reject、跨域预检流程、手写一个带超时与重试的请求。库的配置项三分钟就能查到,底层理解才是区分度所在。
项目里 Axios 和 React Query 能一起用吗
能且常见:Axios 做传输层(鉴权、错误翻译),React Query 做数据层(缓存、去重、刷新)。分层图的第三层与第四层本来就不冲突。
自建封装还有价值吗
在请求状态库覆盖的场景外仍有:非框架项目、超轻量需求、或有特殊定制(自研网关协议、特殊重试语义)时,4.4 节那四十行就是你的起点。自建的价值不在重复造轮子,在于轮子不合适时的改造能力——而这能力来自对原生层的理解。
本节要点回顾
- 生态是痛点清单的产品化:每一层都对应前几章手写过的一段(拦截器对应鉴权注入与错误翻译、缓存库对应去重与 TTL、竞态防护对应取消与对账)。
- jQuery ajax 历史使命已完成,遗产是影响深远的 API 设计;Fetch 是"标准件",能力到位但一事一价不打包。
- Axios 五件套:拦截器、错误语义、实例配置、取消、进度与同构——把每个项目重写的胶水做成了产品。
- 请求状态库是世界观转变:从管理请求到管理服务端数据,收编缓存、去重、刷新、竞态整批清单;但框架绑定、概念不轻,适合数据密集 SPA。
- 选型看场景,不变的判断是:库是知识的产品化不是替代品,底层理解永远在选择之下生效。
一次选型评审的模拟记录
把选型判断框架演练成一次模拟评审。背景:十人团队的新中后台项目,多个数据密集页面(列表、仪表盘、详情),已有后端接口规范,团队 React 技术栈,无存量包袱。评审桌上三个提案:裸 Fetch 加自封装、Axios 加拦截器、请求状态库加 Axios。
评审的推进方式值得参考:先列需求事实而非偏好——页面数据缓存需求重(多页面共享同一份数据)、错误与鉴权约定统一、有并发与竞态场景、团队对三个方案都有基本经验。再对照分层图匹配:鉴权与错误翻译落在 Axios 拦截器最顺(团队约定的官方落点);缓存与竞态落在请求状态库(自封装要重造一遍去重与失效,成本与风险都不划算);裸 Fetch 方案在缓存需求面前明显吃力。结论:Axios 做传输层加请求状态库做数据层,两案并用。附带的否决记录同样重要:裸 Fetch 方案被否的原因写进文档(缓存自研成本约两周且长期维护负担),半年后有人再提"为什么不简单点直接用 Fetch"时,答案有据可查。
这个模拟展示选型评审的三个要点:从需求事实出发而不是从熟悉度出发(熟悉度是隐形成本不是论据);分层匹配而非一站决胜(两个轻方案组合常优于一个重方案包打);结论与否决理由都要落档(选型最大的浪费是半年后无据可查地重选一遍)。第三个要点最常被忽略——团队的选型记忆若只存在个别老成员脑子里,人员流动就会让同样的争论每两年重演一次。
给个人学习者的补笔:面试与实战里,关于请求库的高频问题几乎都不是"怎么配置",而是"它底下做了什么"——拦截器的执行顺序、取消的实现原理、为什么 HTTP 错误会 reject 而原生 Fetch 不会、上传进度为什么离不开 XHR。这些问题的答案全部在前四章:拦截器就是 2.4 节的鉴权注入与 3.5 节的错误翻译的产品化,取消就是 4.4 节的 AbortController,进度就是 2.1 节的 upload 事件。用底层知识回答生态问题,是"学过"与"学懂"的分水岭——前者背配置项,后者讲机制。这也是把生态章放在全书最后的原因:它是前四章知识的一面镜子,照得出地基打得牢不牢。若读本章时感到吃力,别怀疑本章,回去补对应的前章——生态从来不难,难的是它底下压着的那几层。反过来这也提示了一条学习捷径:每学一个新库,先花半小时把它的核心特性清单与前四章的知识点对表——对得上的,一小时上手;对不上的(真正的新能力),才是值得慢下来精读的部分。生态更迭很快,但用对表法学习的人,永远比别人快半拍。