6.4 前沿:WebGPU与云渲染
6.4 前沿:WebGPU 与云渲染
本节摘要:WebGPU 给这条流水线换了更强的发动机——更现代的接口、计算着色器与更低的状态切换开销;云渲染则把整条流水线搬进机房,浏览器只做屏幕。本节讲两者的机理、对现有知识的影响与进入时机,并给出按项目特征选型的论据。全册最后一节,把流水线地图再往外推一程。
渲染后端的下一站
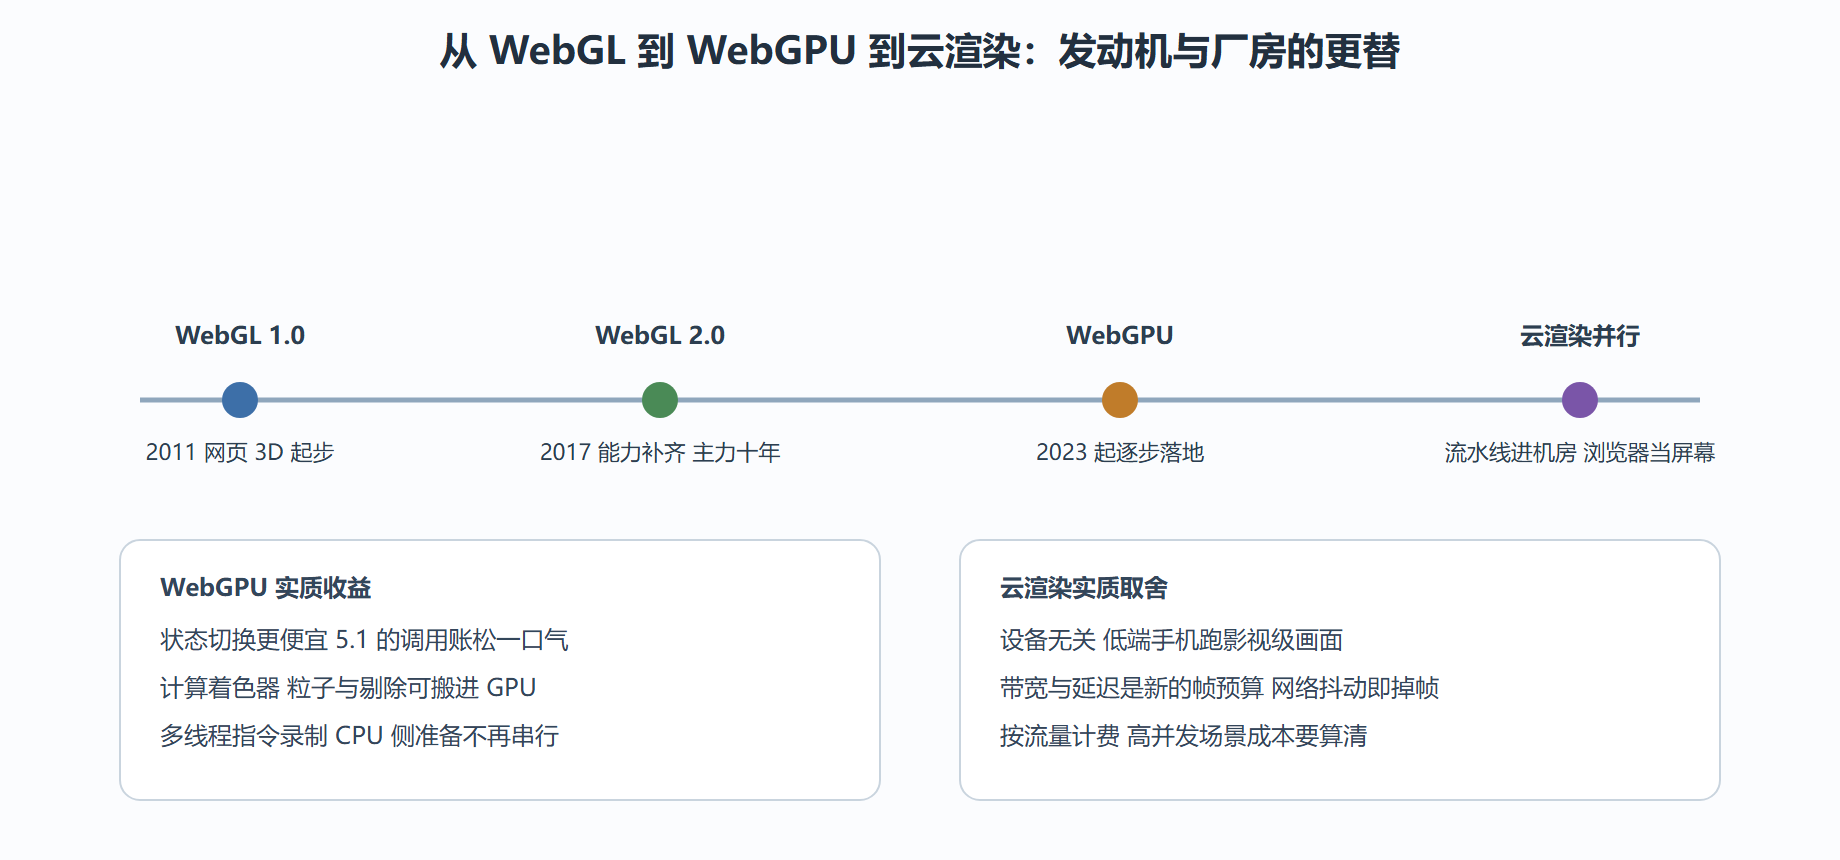
先看一段时间线。2011 年 WebGL 1.0 发布,把 OpenGL 带进浏览器,3D 于是在网上有了立足点;2017 年 WebGL 2.0 补齐大量能力;2023 年起 WebGPU 在主流浏览器陆续落地——它对应的不是某代 OpenGL,而是现代显卡的原生接口谱系。十年间发动机换了三代,但流水线地图没变:场景图遍历、矩阵与剔除、绘制提交、逐像素着色、呈现,一帧还是这些站。
图 6-3 渲染后端演进:发动机换了三代,流水线未变
WebGPU:换发动机不换地图
对写应用的人来说,WebGPU 的好消息是"换发动机不换驾驶位"。引擎把后端差异封装在 Engine 这一层——你学的场景图、材质、动画、拾取全部照旧,多数项目只是创建引擎的那一行变了:
// 后端协商:优先 WebGPU,不可用则回退 WebGL async function createBestEngine(canvas) { if (navigator.gpu) { try { const engine = await BABYLON.WebGPUEngine.CreateAsync(canvas, { antialias: true }); await engine.initAsync(); // WebGPU 后端要一次显式初始化 console.log("WebGPU 后端就绪"); return engine; } catch (e) { /* 掉到 WebGL 分支 */ } } return new BABYLON.Engine(canvas, true); // 1.1 节的老朋友 } // 之后的全部代码不变:这就是抽象层的价值
真正值得为新后端调整项目的地方有两处。其一,计算着色器:粒子系统、GPU 剔除这类"每帧大量重复小计算"的活,从 CPU 挪进 GPU 并行执行,5.1 的 CPU 账能再砍一刀。其二,指令录制的并行化:调用数特别大的场景(城市规划、数字孪生)收益明显。进入时机的判断很朴素:项目里引擎版本支持、目标用户浏览器覆盖率达标、且当前真的被 CPU 账卡住——三者齐备再切,否则它只是简历上的词。
计算着色器长什么样?一瞥即可,重点看思路而不是语法:
// 计算着色器示意:十万粒子的位置更新从 CPU 挪进 GPU(以引擎的封装为例) const cs = new BABYLON.ComputeShader("particleUpdate", engine, { computeSource: wgslSource }, // GPU 侧代码:一段并行更新规则 { bindingsMapping: { positions: { group: 0, binding: 0 } } }); cs.setStorageBuffer("positions", positionBuffer); // 位置缓冲:十万粒子也在一份里 cs.dispatchWhenReady(); // 就绪即派发,GPU 并行算完 // CPU 侧不再逐粒子写循环:5.1 的 CPU 账直接少一大项
云渲染:流水线进机房
云渲染把整条流水线搬上服务器:机房里的 GPU 跑完一帧,编码成视频流推到浏览器,本地只负责解码显示与上传输入。浏览器的角色从"工厂"退化成"屏幕"。
它的适用面清晰而窄:设备无关——千元机也能看影视级画面的汽车配置器,这是本地渲染永远做不到的;数据保密——模型不落客户端,高价值资产展示的硬需求;但代价同样硬:网络抖动直接变掉帧(延迟就是新的帧预算),按流量计费在高并发下烧钱,弱网环境体验崩塌。工程接入通常是"云端跑同一套引擎、输出走视频流"的托管服务,交互层(4.2 的拾取逻辑)部分上移云端、部分留在本地预测——这是个仍在快速演化的领域,立项时按"延迟预算表"(操作到画面的往返时间)做可行性测算,比听概念靠谱:
| 项目特征 | 倾向本地 WebGPU 或 WebGL | 倾向云渲染 |
|---|---|---|
| 画质需求 | 中高即可 | 影视级光照与反射 |
| 用户设备 | 主流手机可跑 | 覆盖老旧设备是硬需求 |
| 网络环境 | 弱网也要可用 | 宽带稳定可保证 |
| 资产价值 | 可下发给客户端 | 严禁离开机房 |
| 成本模型 | 一次性开发 | 持续流量费用可预算 |
⚠️ 常见坑:把"用了 WebGPU"当性能方案。后端升级只放大既有优化的收益——5.1 的三板斧没做、调用数一千五,换什么后端都是卡,先按预算表把账管好再谈换发动机。
常见问答
现在启动的项目要不要直接上 WebGPU? 先做协商回退(本节的 createBestEngine 模式),默认体验仍是 WebGL,等目标用户浏览器覆盖率与引擎成熟度都达标再翻转优先级。代码一行不变,风险为零,这是最稳的占位方式。
学过的 WebGL 知识会作废吗? 不会。着色语言从 GLSL 换成 WGSL 是表层差异;你真正学过的东西——状态切换为什么贵、纹理为什么要在加载期上传、合批为什么省 CPU——全部是显卡的工作方式,与接口代际无关。发动机换了三次,三本账一次没变。
云渲染能省客户端开发量吗? 恰恰相反。云端跑的还是同一套引擎代码,你还要额外处理编码、推流、弱网回退与输入往返延迟,工程面变宽了。它的正当理由只有两个:设备无关的画面上限,以及资产不落客户端的保密硬约束,除此之外都该优先本地渲染。
这两个方向会合流吗? 已经在合。云端机房用同样的现代后端渲染、视频流里跑的帧与本册讲的帧同构,而本地 WebGPU 承接交互预测的部分——未来的常态是"本地轻帧 + 云端重帧"的混合流水线,八段地图在两端各自成立。判断一个新概念该不该进你的项目,仍然用全册的老办法:找到它落在帧地图的哪一站、动的是哪本账,答案自然浮现。
收束全册
- 三代发动机一张地图:WebGL 到 WebGPU 改的是站点效率,八段流水线与三本账原样适用
- WebGPU 三收益:调用更便宜、计算进 GPU、指令并行录制;切入时机看覆盖率与真实瓶颈
- 云渲染三取舍:设备无关与数据保密换延迟与流量成本,用往返延迟预算表立项
- 优化先于后端:预算表管好账,换发动机才有复利
至此全册结束。带走那张流水线地图与"每站问三件事"的习惯——引擎会继续换发动机,而这张地图会陪你很久。