5.2 IGServer服务发布与缓存加速
5.2 IGServer 服务发布与缓存加速
本节摘要:发布是把第 4 章定稿的地图文档送出厂的关键动作。本节以一次完整发布为主线:装地图文档、起服务、读日志、配缓存、压一压性能,全程按运维视角记录。学完你能独立发布一组服务,并能回答那个最常见的投诉——"你们的图怎么这么慢"。
学习目标
阅读完本节,你应当能够:
- 完成从地图文档到在线服务的完整发布流程,解释每步在做什么
- 读懂发布与服务日志,从日志定位发布失败的原因
- 解释瓦片金字塔的层级、行列与分辨率关系,算出给定范围的瓦片量
- 制定缓存策略:切哪些层、切多大范围、何时更新
- 用并发测试判断服务是否达标,说出三个常用调优手段
一、发布全过程实录
场景沿用前文的耕地保护项目:一张符号化定稿的"耕地保护专题图"地图文档,要发布给县局十几个科室在线浏览。发布在 IGServer 的管理器里完成,全程十几分钟,但每一步都有值得盯的细节。
# 发布操作实录(IGServer 管理器) 1 登录管理器 浏览器开服务管理页 输管理员账号 2 选数据源 指向地图文档 检查图层完整性 盯:图层缺失报错说明文档引用的要素类被移走 3 起服务 选服务类型 地图文档型 填服务名 盯:服务名会成为地址一部分 全英文避免编码问题 4 配参数 出图尺寸默认256 DPI设96 支持的坐标系勾全 盯:客户端用哪种坐标系就勾哪种 多勾不亏 5 访问控制 内网浏览设为匿名 需编辑的服务单独开账号 6 发布 进度条走完 出现服务地址 7 验证 浏览器打开服务地址 出现服务信息页即成功 再用一段最小页面代码加载验证显示效果 # 输出:服务地址形如 igs服务根目录下 docs 加服务名 # 经验:发布前先在本机把地图文档打开一遍 确认无报错再上服务
第 2 步的图层缺失检查最值得强调。地图文档记录的是对要素类的"引用",文件挪了位置、数据库换了密码,文档本身不会自动知道。桌面端能打开不代表服务端能打开——两者可能连的不是同一个数据源。发布失败排查的第一件事,就是在服务器那台机器上把地图文档开一遍。
发布动作也可以脚本化。当服务多到两位数,手工在管理器里点就不可靠了,把发布参数写成代码进版本库,环境迁移时一键重建:
// 概念演示:用 C# 调发布接口创建地图服务(示意写法) // 目标:把"耕地保护专题图"文档发布为地图服务 var server = new ServerConnection("http://服务器地址:6163/igs", "admin", "口令"); var param = new PublishParameters { DocPath = @"数据目录\耕地保护专题图.mapx", // 地图文档位置(服务器本地路径) Name = "farmland_protect", // 服务名 全小写 稳定不改 Type = ServiceType.MapDoc, // 地图文档型服务 SupportSRS = new[] { "CGCS2000", "WebMercator" } // 支持的坐标系 }; ServiceResult r = server.Publish(param); Console.WriteLine(r.Success ? "发布成功 地址 " + r.ServiceUrl : "发布失败 原因 " + r.Message); // 输出:发布成功 地址 http://服务器地址:6163/igs/rest/mrms/docs/farmland_protect // 复盘:失败原因九成是文档路径错或数据源连不上 按日志逐条对
二、读懂日志:发布只是开始
服务起来不等于服务健康。日志是服务端的"行车记录仪",三个时段最值得看:启动时(加载了哪些图层、有没有跳过)、运行中(慢请求集中在哪些瓦片、报错堆栈)、更新后(新配置是否生效)。把一次典型启动日志翻译成人话:
# 启动日志解读(节选翻译) 行1 服务开始加载文档 farmland_protect 行2 图层1 行政区 加载成功 要素数 12 耗时 40 毫秒 行3 图层2 耕地图斑 加载成功 要素数 38421 耗时 2.7 秒 解读:图斑量大属正常 若超10秒需检查空间索引 行4 图层3 影像底图 延迟加载 范围 113.2至114.8 解读:影像按需加载 首屏不拖慢属正常策略 行5 服务就绪 监听端口 6163 # 运行期关注两类行: # 慢请求 耗时超过阈值会告警 看层级与范围是否集中在缓存未覆盖区 # 报错行 连接池耗尽 数据源超时 都是数据层在报警
三、瓦片与缓存:把慢问题算清楚
5.1 留下的问题在这里展开:服务慢,慢在缓存未命中的现场渲染。解法是瓦片缓存——提前把图切成小块图片存好,请求来了直接发文件。要理解缓存策略,先理解瓦片金字塔:层级越高,瓦片越多,每一块覆盖的地面越小、分辨率越高。
图:瓦片金字塔与缓存策略的取舍
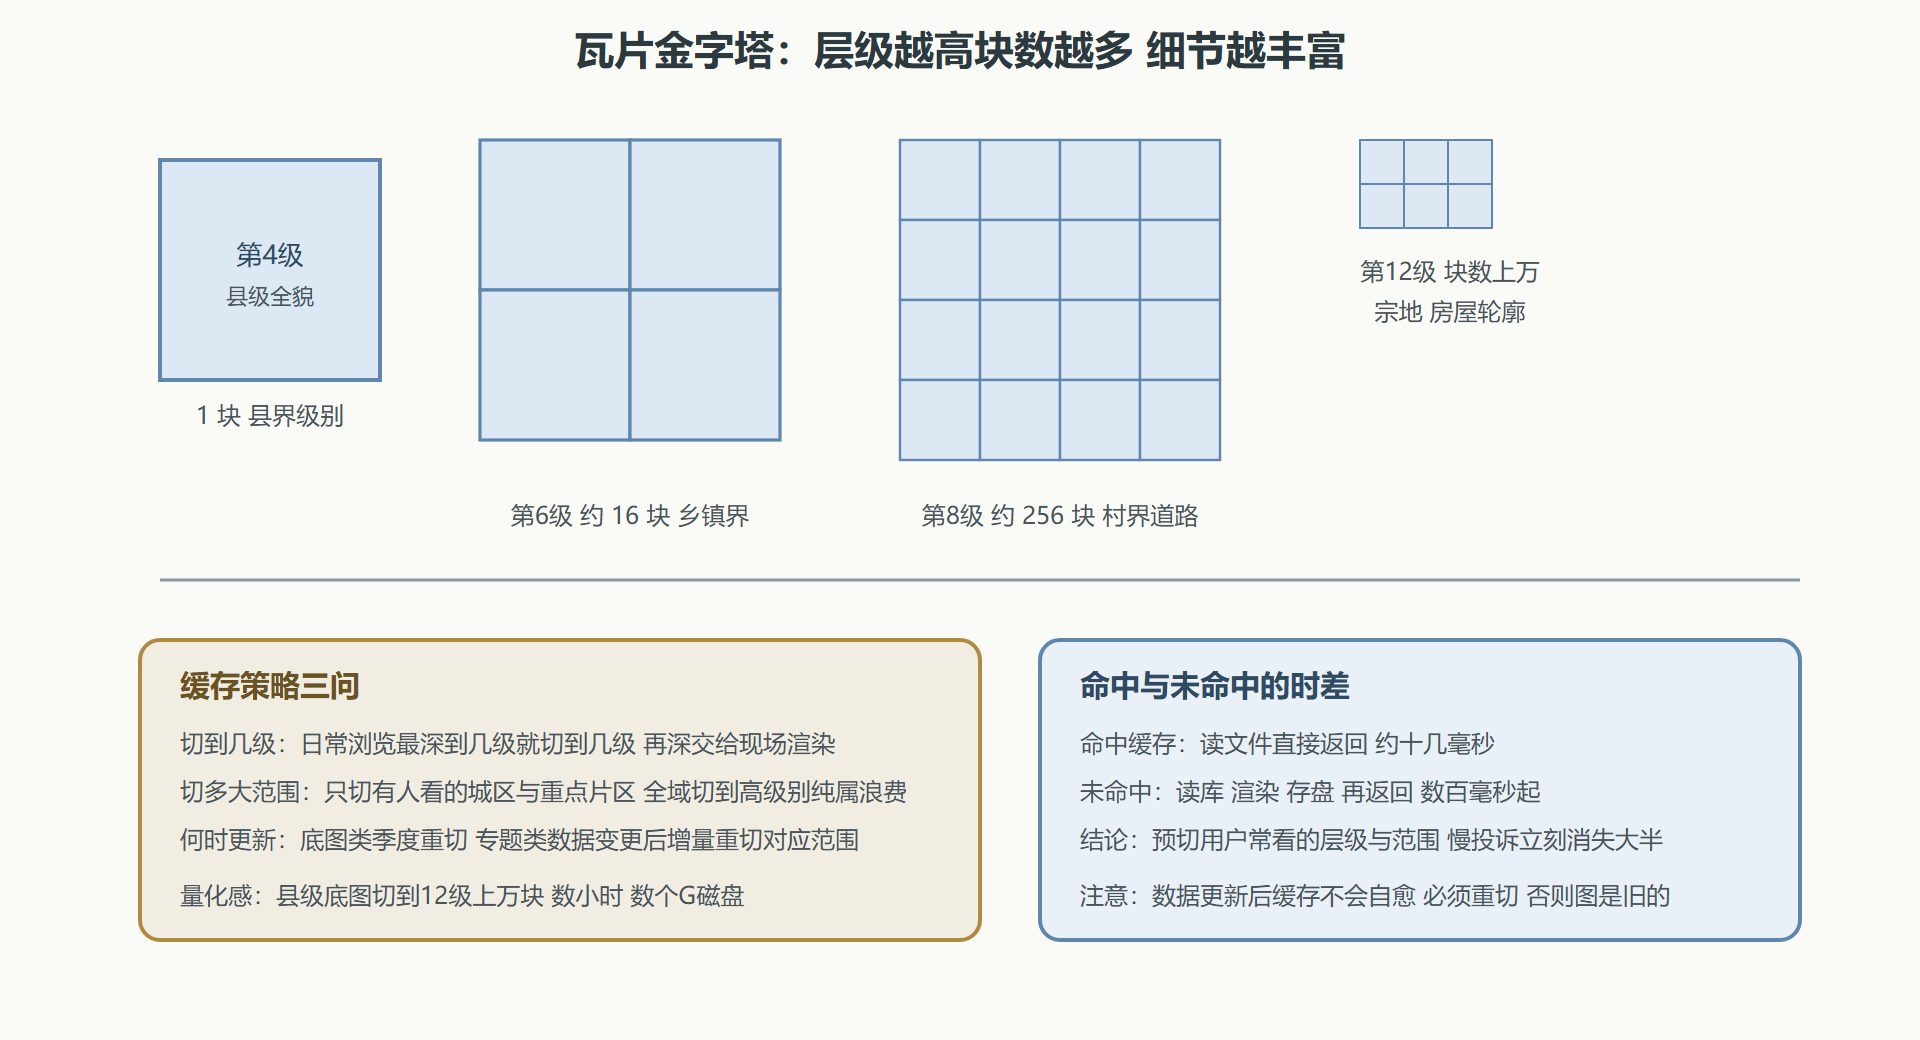
图里右下角那句"缓存不会自愈"是缓存策略的命门。数据更新了、缓存还是旧的,用户看到的图就是旧图——这类"数据明明改了网页上还是老样子"的投诉,几乎都指向忘记重切缓存。规范做法是把重切挂进数据更新的收尾工序,更新完必重切,重切完必抽查两眼。
缓存执行也不复杂,管理器里选服务、设层级范围、点执行,剩下的交给时间:
# 缓存预生成任务参数(示例值) 服务 farmland_protect 层级 4 至 12 级 范围 县域矩形范围 外扩 2百分之边 格式 PNG 混合模式 透明底 执行 夜间跑 白天峰值期不切 # 执行后验证: # 1 管理器看缓存覆盖率报表 # 2 客户端清缓存重刷 观察请求耗时 从几百毫秒降到几十毫秒 # 3 抽最冷门角落的瓦片确认也命中
⚠️ 常见坑:为了"图快"把全域切到最高层级。一个县全域第 18 级切下来是数十万级瓦片量、上百 G 磁盘、连续数天机器满载,而深山无人区的第 18 级一年没几个人看。缓存是花钱买速度的交易,只买用户真正会看的部分。
💡 关键直觉:缓存策略的本质是预测用户行为。用户在哪片区域活动、最常放大到几级,就切到哪。观察一段线上日志再定策略,比拍脑袋准确得多。
服务健康巡检:发布之后的长跑
服务上线只是起点,长期健康靠巡检。一个轻量巡检方案:定时脚本每隔几分钟访问一次服务的健康接口,把响应时间与状态码写入日志表;连续三次异常触发告警消息推给管理员。再配一份周报,统计一周的慢请求分布与峰值时段——这两条曲线是下次扩容与缓存调整的直接依据。巡检不用做重,但必须有:服务的故障往往发生在没人在场的深夜,等上班发现时已经停了六个小时。
# 巡检脚本要点(可并入 6.4 的定时任务) 频次 每5分钟一次健康接口探活 记录 时间点 状态码 响应毫秒数 告警 连续3次失败即推送 恢复也推送 周报 慢请求分布 峰值时段 错误分类计数 # 经验:把巡检做成只读操作 不写入任何业务数据 避免巡检自身伤到服务
本节要点回顾
- 发布七步:登录、选源、起服务、配参、控权、发布、验证,第 2 步的图层完整性最易翻车
- 日志三时段:启动看加载、运行看慢请求、更新看生效,排障先翻日志
- 金字塔规律:层级加一瓦片数翻两番,切到几级看用户日常浏览深度
- 缓存三问:切到几级、切多大、何时更,答案都在用户行为日志里
- 缓存不自愈:数据更新必重切,否则"改了数据图不换"的投诉必来
- 性能验证:并发测试加慢请求统计,三个调优手段是缓存、连接池与分级加载