1.1 一份病历:MySQL能治什么病
1.1 一份病历:MySQL 能治什么病
本节摘要:关系型数据库用表、行、约束组织数据,MySQL 是其中最流行的开源实现。本节从一份数据"病历"出发,弄清关系模型的基本概念、MySQL 的特点与适用边界,避免把不治之症当成慢查询来调。
病历首页:数据长什么样
一家电商的订单数据放进 MySQL 前,先要拆成几张二维表:用户表、订单表、订单明细表。这就是关系模型的核心——用行和列的表格描述实体,用外键关联表达实体间关系,用约束保证数据合法。
CREATE TABLE patient_user ( user_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_name VARCHAR(50) NOT NULL, phone CHAR(11) NOT NULL, created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP, UNIQUE KEY uk_phone (phone) );
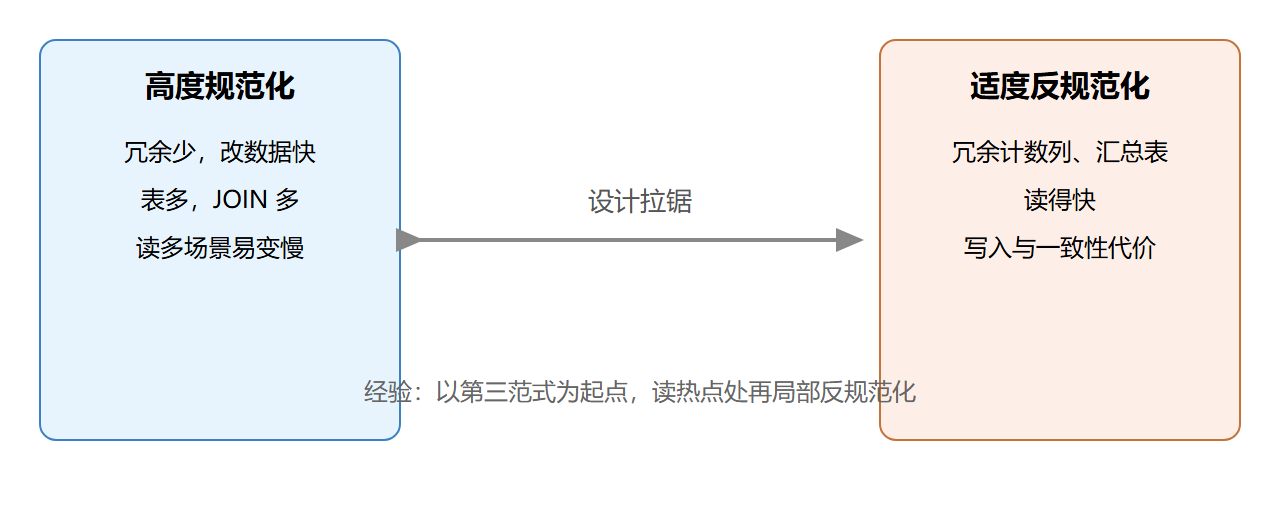
三范式在这里的作用类似病历的规范书写:每列只放一个值、非主键列要依赖整个主键。规范化过头会导致查询要连五六张表,反规范化过头会导致一改电话要更新一万行——这个取舍贯穿整个数据库设计。
图:规范化与查询成本的拉锯
MySQL 的体征特点
- 开源免费、生态成熟,几乎所有语言都有成熟驱动
- 插件式存储引擎,InnoDB 支持事务与行锁,是 OLTP 默认选择
- 单机为主,写入扩展靠分库分表或换架构,不是它的强项
- 复杂分析(大范围聚合、多维即席查询)不如列式分析引擎
我见过不少团队用 MySQL 做日志分析,每天几亿条 INSERT 加全表聚合,怎么调都快不起来——这不是病,是挂错了科室。判断口诀:高频小事务读写找 MySQL,海量扫描聚合找分析型引擎。
把病历写完整:订单表的关联设计
只看用户表还体会不到"关系"二字的分量,把订单和明细补上才能看到整个病历体系。订单头表存一次交易的公共信息,明细表存每一件商品,中间用 order_id 关联:
CREATE TABLE clinic_order ( order_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id BIGINT UNSIGNED NOT NULL, amount DECIMAL(10,2) NOT NULL, status TINYINT UNSIGNED NOT NULL DEFAULT 0, created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP, KEY idx_user_created (user_id, created_at) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4; CREATE TABLE clinic_order_item ( item_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, order_id BIGINT UNSIGNED NOT NULL, sku BIGINT UNSIGNED NOT NULL, price DECIMAL(10,2) NOT NULL, quantity SMALLINT UNSIGNED NOT NULL DEFAULT 1, KEY idx_order (order_id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
为什么拆两张表而不把商品塞成一个大字段?因为"查某个商品这个月卖了多少件"这种问题,在拆开的结构里是一条普通查询,在 JSON 大字段里是一场全表扫描加解析灾难。关系模型的核心收益就在这里:数据的长相服务于将来要问的问题。
约束是病历上的必填项。NOT NULL 挡住"未知"状态的滥用,UNIQUE 挡住重复建档,外键在中小表上可以直接声明:
ALTER TABLE clinic_order_item ADD CONSTRAINT fk_item_order FOREIGN KEY (order_id) REFERENCES clinic_order (order_id);
互联网大表实践中外键常被移到应用层维护——写入高频时外键检查的开销与死锁风险会放大,这是规范与吞吐的又一次拉锯。判断标准很简单:单表日增百万行以上的,约束靠应用与对账;业务系统规模的单表,外键尽管用。
不治之症清单
把不适合 MySQL 硬塞给 MySQL 的场景,值得单独立一份清单,接诊时先对照:
| 场景 | 为什么不治 | 更合适的去处 |
|---|---|---|
| 每天 TB 级日志的全文检索 | B+ 树不擅长倒排 | 专用搜索引擎 |
| 数十亿行多维即席聚合 | 行存的扫描代价太高 | 列式分析引擎 |
| 超高并发简单 KV 读写 | 事务与 SQL 是多余开销 | 内存型 KV 存储 |
| 图关系多跳查询 | 递归 join 层数深了爆炸 | 图数据库 |
注意这张表的边界:不是"MySQL 做不了",而是"做得了但每个环节都在跟结构对抗"。一个真实案例是商品评论的点赞计数,用 MySQL 行锁更新计数字段,热点商品一行的锁竞争就能拖垮整站——这不是慢查询,是访问模式选错了存储结构,最后计数挪到内存缓存、MySQL 只存结果才结案。
选型判断的三个问题
接一个新需求时,拿这三个问题过一遍,比背技术雷达管用。数据量级与增长曲线是什么——日增几千行和日增千万行是完全不同的病人体质。读写比例是什么——读多写少的场景 MySQL 的缓冲池能吃掉绝大部分成本,写密集场景要提前规划分库分表。一致性要求到什么程度——钱相关的强一致事务是 MySQL 的主场,能容忍最终一致的计数、状态流可以放出去。三个答案落定,治什么病、怎么治,方向就清楚了。
一份真实选型会诊记录
某医疗挂号团队的技术选型会上出现过一场典型争论。挂号号源要支持开抢瞬间的秒级十万并发写入,团队内部吵出两派:一派坚持"全上 MySQL,事务可靠",一派主张"号源计数放内存,MySQL 只落最终结果"。最后的会诊结论是分层处方:号源的原子扣减放在内存计数服务里扛瞬时洪峰,挂号成功的订单异步落 MySQL 保证资金与记录一致,对账任务每小时核对两边数量。上线后大促零事故。
这个病例说明"治什么病"的判断单位不是产品,是每类数据的访问模式。同一个系统里,强一致订单与高并发计数可以一个住手术室一个住 ICU,硬塞进同一种存储才是误诊。
建模练习:从需求到表结构
拿一个随处可见的需求练一次完整建模:用户收货地址。字段直觉是收件人、电话、省市区、详细地址、是否默认。写出来:
CREATE TABLE user_address ( addr_id BIGINT UNSIGNED AUTO_INCREMENT PRIMARY KEY, user_id BIGINT UNSIGNED NOT NULL, receiver VARCHAR(50) NOT NULL, phone CHAR(11) NOT NULL, province VARCHAR(30) NOT NULL, city VARCHAR(30) NOT NULL, district VARCHAR(30) NOT NULL, detail VARCHAR(200) NOT NULL, is_default TINYINT UNSIGNED NOT NULL DEFAULT 0, KEY idx_user (user_id) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
两个设计决策值得咀嚼。省市区拆三列而不是塞一个 JSON:地址级联选择器逐级取值,拆列后每级都是索引友好的一跳。is_default 用标记位而不是唯一约束"每用户仅一条默认":MySQL 没有部分唯一索引,标记位配合应用层"设新默认先清旧默认"的两条语句,是务实的折中——高级一点的写法是给非默认行填同一个占位值配合复合唯一键,这里从简。
与同类数据库的体格对比
选型时常见的三个对手放在一张表里看更清楚:
| 维度 | MySQL | PostgreSQL | 文档型数据库 |
|---|---|---|---|
| 默认引擎事务 | InnoDB,ACID | 原生 ACID | 多数单文档原子 |
| 复制生态 | 极成熟,工具链广 | 成熟,流复制为主 | 各家自带 |
| 海量写入扩展 | 偏弱,常需中间件 | 偏弱 | 分片友好 |
| SQL 方言与标准 | 够用,部分语法自成一派 | 更贴标准 | 查询能力有限 |
| 社区与人才 | 存量最大 | 上升期 | 场景化 |
这张表不是排名而是体检对照。MySQL 的真正优势在"存量":招人容易、运维经验遍地、云厂商支持最全。一个团队能把 MySQL 用到什么水平,往往比选哪个数据库更能决定系统的健康度。
本节要点回顾
- 关系模型:表格 + 约束 + 外键,范式是规范书写,反规范化是局部偷懒换读性能
- 适用边界:OLTP 强、单机写入与海量分析弱,选型错位是"不治之症"
- 设计起点:第三范式起步,热点路径再冗余