3.1 从问诊到取药:逻辑架构与查询执行
3.1 从问诊到取药:逻辑架构与查询执行
本节摘要:MySQL 分 Server 层与存储引擎层。一条查询要经过连接器、解析器、优化器、执行器,最后由引擎取数。理解这条流水线,才能定位问题是"开错了药方"还是"药房取药慢"。
一条 SQL 的完整旅程
SELECT user_name FROM clinic_user WHERE user_id = 1001;
这条语句的旅程:
- 连接器:核对账号密码、取出权限表快照。换权限后不断线不生效,就是因为快照在连接时已经定型
- 解析器:把文本拆成语法树,表名列名在这里被识别,写错列名报的错来自这一站
- 优化器:决定用哪个索引、多表按什么顺序 join——第 4 章的主角
- 执行器:先校验权限,然后按引擎接口逐行取数、过滤、返回
可以用 profiler 直观看到时间花在哪一站:
SET profiling = 1; SELECT user_name FROM clinic_user WHERE user_id = 1001; SHOW PROFILE FOR QUERY 1;
Server 层与引擎层的分界线
插件式存储引擎是 MySQL 的解剖学特征:解析、优化、聚合、排序在 Server 层,数据的真正存取交给引擎。InnoDB 是默认引擎,支持事务与行锁;历史上 MyISAM 不支持事务但读轻快,如今新项目几乎没理由再选它。
SHOW ENGINES;
图:一条查询的器官旅程
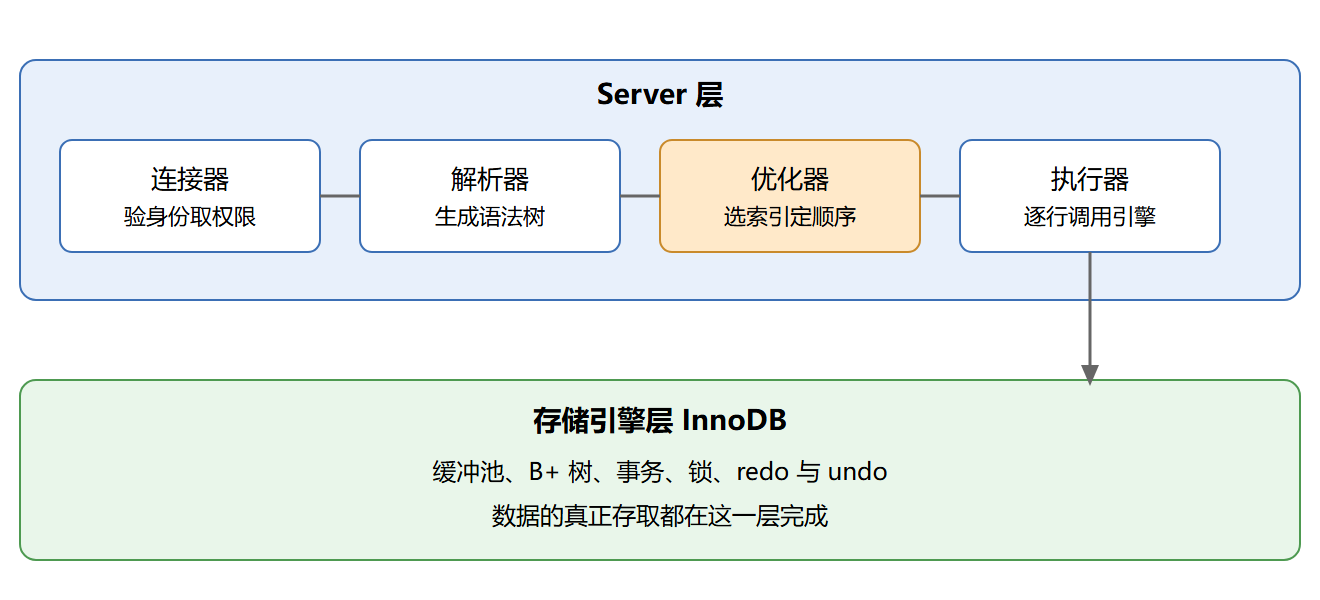
💡 关键直觉:看到慢查询先判断卡在哪一层。解析与优化通常是毫秒级,真正的耗时大头几乎总在引擎层扫了多少行。这也是第 4 章 EXPLAIN 里 rows 列如此重要的原因。
连接器:最长情的器官
连接器管的事情比"验密码"多。连接建立后它维护着这个连接的上下文:权限快照、会话变量、字符集设定、当前库。这解释了一批看似玄学的现象。改了权限不生效,要想想这个连接是不是在改权限之前就建立了,重连即刷新。会话变量 SET 了没效果,可能是连接池把连接复用给了下一段代码,上一段设置的变量还在——连接池里的会话状态污染是真实事故源,应用侧用完务必清理或用连接重置选项。
连接是有成本的,握手、鉴权、分配内存都要时间,短连接高频建立会把 CPU 烧在寒暄上;但连接也不能无限囤,每个连接几十 KB 到几 MB 的内存随参数走。连接池的大小在"复用省握手"与"内存和控制开销"之间取平衡,经验起点是几十,按压测调。
-- 观察连接的构成:谁连着、平均空闲多久 SELECT user, host, COUNT(*) AS conns, ROUND(AVG(time)) AS avg_idle_sec FROM information_schema.processlist GROUP BY user, host ORDER BY conns DESC; -- 连接相关的三个体征 SHOW STATUS LIKE 'Threads_connected'; SHOW STATUS LIKE 'Threads_running'; SHOW STATUS LIKE 'Aborted_connects';
Aborted_connects 持续增长说明有客户端在反复握手失败——密码错、连接数打满、或网络设备掐连接,三种病因治疗完全不同,这个计数器是把"连不上"的主诉分流的第一站。
解析器的报错地图
语法错误人人遇到,但报错信息值得当地图读。"Unknown column"来自解析后的语义分析阶段,报错位置常指向 SELECT 列表里写错的那个名字;"You have an error in your SQL syntax"是纯语法层,紧跟其后的引号里重放了出错点附近的一小段原文,直接看那一段的第一个词,九成能找到病灶——最常见的漏逗号、中文引号、保留字没加反引号。
保留字是新手暗坑。order、desc、range 这类词做列名时要用反引号包起来,或干脆换个名字。诊断室的建议是后者:给列名起不需要转义的名字,比到处记着加反引号可靠。
执行器与引擎的对话
执行器不直接碰数据,它向引擎下"取下一行"的指令并在 Server 层做过滤和计算。这个分层的直接推论是:WHERE 条件里引擎能下沉消化的部分(有索引可用)与不能消化的部分(扫描后过滤),成本天差地别。同一句 SQL,索引能把"取一百万行再扔掉九十九万"变成"只取一万行",这就是第 4 章整章要讲的事情的机理版预告。理解了这一层的读者,看 EXPLAIN 时脑子里出现的将不是表格,而是执行器一行行取数的画面。
查询缓存之死:一个器官的退休启示
老版本 MySQL 有个查询缓存器官:把 SELECT 语句原文与结果整对缓存,下次同文语句直接吐结果。听起来美好,8.0 却把它彻底移除了。死因值得每个学习者知道:任何一张表的任何一次写入都让所有涉及该表的缓存失效,并发稍高的系统里缓存命中率趋近于零,而维护缓存的锁反而成了新的竞争点。一个对读似乎有利的设计,在真实并发下成了全库的拖累。
-- 8.0 里这两条只是回忆: -- SHOW VARIABLES LIKE 'query_cache_type'; -- SET GLOBAL query_cache_size = 0;
它的退休留下的启示适用于所有缓存设计:失效粒度比命中率数字更重要,锁竞争会吃掉缓存收益,以及——缓存更适合放在应用层或独立层,让数据库专心做它最擅长的存取与一致性。面试里还常问查询缓存,能讲清它为什么死,比会开它值钱得多。
一条 UPDATE 的旅程补充
读旅程别只读 SELECT:UPDATE 的前半程与查询完全同路,连接、解析、优化一样不少,多出来的是执行阶段的写路径——先当前读定位行,写 undo,改缓冲池里的页,写 redo,提交时再写 binlog。这条补充路线在第 3.2 节会拆成器官级的细节,在这里先记住一句话就够:读和写在 Server 层同路,在引擎层分家。
本节要点回顾
- 四站流水线:连接器、解析器、优化器、执行器,各报各的错
- 两层分界:Server 管智力活,引擎管体力活
- ** profiling**:怀疑"药方慢"时先看各阶段耗时分布