5.1 住院规则:事务ACID与实现原理
5.1 住院规则:事务 ACID 与实现原理
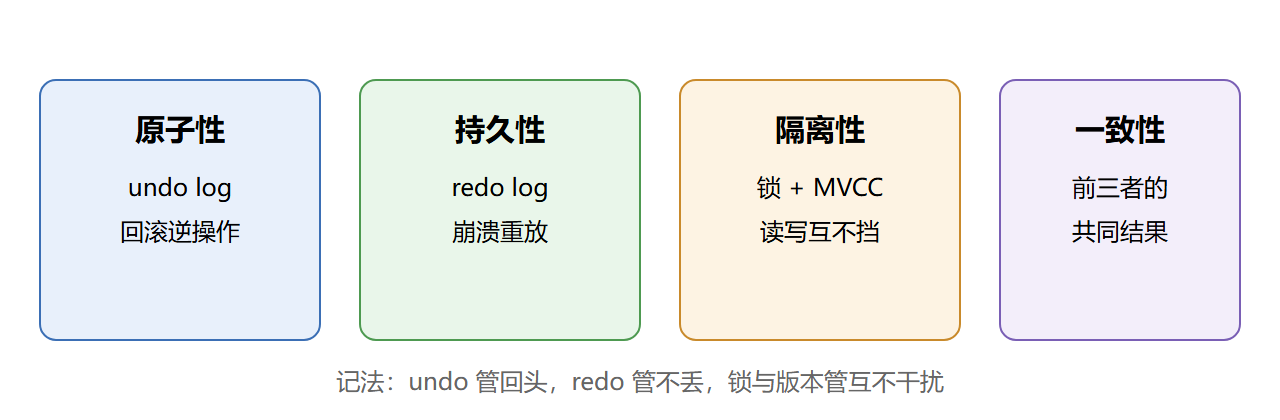
本节摘要:原子性靠 undo 回滚,持久性靠 redo 重放,隔离性靠锁与 MVCC,一致性是前三者共同的结果。本节把四个抽象词落到具体机制上,并演示一个可复现的回滚实验。
四个词对应四个器官
- 原子性 Atomicity:要么全做要么全不做——undo log 记录反向操作,崩溃或回滚时逆序执行
- 持久性 Durability:提交了就不丢——redo log 先写日志,崩溃后重放恢复
- 隔离性 Isolation:并发事务互不干扰——锁挡写写冲突,MVCC 让读写不阻塞
- 一致性 Consistency:数据从一个合法状态到另一个合法状态——它是目标,前三者是手段
动手实验:亲眼看一次回滚
START TRANSACTION; UPDATE account SET balance = balance - 100 WHERE user_id = 1001; SELECT balance FROM account WHERE user_id = 1001; -- 已变,本事务自己可见 ROLLBACK; SELECT balance FROM account WHERE user_id = 1001; -- 回到原值
改动能被自己看见是因为本事务读自己的修改永远是即时的;回滚瞬间恢复,是 undo 在幕后逆序执行反向语句。再做一个对照实验,另一个会话在 UPDATE 未提交时读同一行,读到的仍是旧值——这就是 MVCC 的旧版本读,5.2 节展开。
提交的内部动作
一次 COMMIT 并不等于把数据页刷盘,而是:写 redo 并落盘、写 binlog、标记事务提交。脏页由后台线程慢慢刷。这套"先记日志、后改数据页"的设计,把随机写变成了顺序写,是 InnoDB 高吞吐的根源。
-- 观察当前活跃事务,长事务在这里现形 SELECT * FROM information_schema.INNODB_TRX ORDER BY trx_started;
图:ACID 与机制的对应关系
autocommit 的真面目
autocommit 不是"没有事务",而是"每条语句独享一个事务"。理解这点能解开两个日常谜题。谜题一:明明没写 START TRANSACTION,为什么一条 UPDATE 崩溃后也能恢复到改前状态——它有事务,一条语句的事务。谜题二:为什么建议大批量导入时手动包事务——一万条 INSERT 在 autocommit 下是一万个事务,每个都要等 redo 落盘;包成一个事务只落盘关键几次,速度差出一个量级:
SET autocommit = 0; START TRANSACTION; -- 一万条 INSERT 在这里 COMMIT; SET autocommit = 1; -- 用完恢复,别给后面的会话留坑
隔离级别的提前预习
ACID 里的 I 本章只说了一句"靠锁与 MVCC",细节在 5.2,但一个可动手的实验值得现在做。两个终端各开一个会话,A 会话改一行不提交,B 会话读同一行——立刻返回旧值,不等待。再让 B 会话改同一行——卡住,转圈等待。同是一行,读不等待、写等待,这就是"读写不阻塞、写写排队"的手感。做这个实验两分钟,读 5.2 的版本链原理时会有"原来如此"的体验,跳过它则 5.2 全是抽象名词。
-- A 会话 START TRANSACTION; UPDATE account SET balance = balance - 1 WHERE user_id = 1001; -- B 会话(另一个终端) SELECT balance FROM account WHERE user_id = 1001; -- 秒回,旧值 UPDATE account SET balance = balance - 1 WHERE user_id = 1001; -- 等待 A
事务大小的临床标准
多长的事务算长事务,给几条可操作的红线:执行时间上,超过一秒的事务要能在慢日志里被关注到,超过十秒的必须在排查清单里;语句数量上,几千行以上的修改分批提交;内容上,事务里出现 SELECT 大范围扫描、外部 HTTP 调用、等待用户输入,任何一条都是结构性缺陷。盯梢工具用系统视图:
SELECT trx_id, trx_started, trx_rows_modified, TIMESTAMPDIFF(SECOND, trx_started, NOW()) AS age_sec FROM information_schema.INNODB_TRX HAVING age_sec > 10;
把它做成每分钟跑一次的巡检,长事务会自己跳出来挂号。
两阶段提交:两本账怎么对齐
一次提交要把 redo 与 binlog 都写盘,两本账必须对齐——redo 写成功 binlog 没写,崩溃恢复后主库有这笔数据而复制出去的从库没有,主从永久不一致。InnoDB 的解法是内部两阶段提交:redo 先写并打上 prepare 标记,binlog 写盘,再把 redo 标记为 commit。崩溃恢复时的裁决规则:redo 处于 prepare 就去看 binlog,binlog 里有完整记录则提交,没有则回滚。这套机制平时完全隐形,只在两个时刻值得被想起——排查主从数据不一致时,它是嫌疑链的一环;调 innodb_flush_log_at_trx_commit 参数时,动的是它每一环的落盘力度:
-- 提交持久化的三档(默认 1 最安全,2 与 0 在宕机时可能丢最近事务) SHOW VARIABLES LIKE 'innodb_flush_log_at_trx_commit'; SHOW VARIABLES LIKE 'sync_binlog';
两个参数一个管 redo 一个管 binlog,性能与安全的权衡成对出现,要动一起动、要留一起留,只动一个等于给两本账埋下不一致的种子。
补一个面试高频的辨析收尾:持久性与一致性的边界。持久性说的是"提交过的数据在崩溃后仍在",它由 redo 兑现;一致性说的是"数据满足所有约束与业务规则",它由应用、约束、触发器与前三个特性合力兑现——外键约束挡住孤儿订单,应用逻辑保证扣款与发货的配对,数据库只能保证状态迁移的原子与隔离,不能替业务定义什么是"对"。把一致性当成数据库单方面承诺的团队,迟早会遇到"每条 SQL 都成功、业务数据却错了"的悬案,那时要查的就不是数据库,是事务边界的划分本身。
本节要点回顾
- ACID 不再是口号:每个特性背后是具体日志与锁机制
- 先写日志原则:顺序写换性能,提交不等于刷脏页
- 盯长事务:INNODB_TRX 是病房点名册