5.3 急诊案例:锁等待与死锁
5.3 急诊案例:锁等待与死锁
本节摘要:行锁、间隙锁、next-key 锁构成 InnoDB 的锁体系。锁等待表现为整串更新排队,死锁表现为互相等待后一方被回滚。本节给出一套从发现、定位到处方的急诊流程。
病例一:一条 UPDATE 卡住整站
某次发版后,订单页全体超时。急救三步:
-- 第一步:看谁在等 SELECT * FROM performance_schema.data_lock_waits; -- 第二步:看谁拿着锁不放手 SELECT * FROM information_schema.INNODB_TRX ORDER BY trx_started; -- 第三步:确诊为一个跑了 40 分钟的报表事务持有锁,处理它 KILL <trx_mysql_thread_id>;
病灶往往是"事务里夹了外部调用"——更新后去调 HTTP 接口,接口超时,锁就一直握着。处方:外部调用全部挪出事务。
病例二:死锁,两个医生互相递器械
-- 会话A:先改订单1,再改库存 UPDATE clinic_order SET status = 2 WHERE order_id = 1; UPDATE stock SET num = num - 1 WHERE sku = 101; -- 会话B:先改库存,再改订单1 UPDATE stock SET num = num - 1 WHERE sku = 101; UPDATE clinic_order SET status = 2 WHERE order_id = 1; -- ERROR 1213: Deadlock found
A 等 B 的库存锁,B 等 A 的订单锁,循环等待形成。InnoDB 会检测到并回滚代价小的一方,所以死锁通常报错而不是永久卡死——但要减少发生:
- 统一加锁顺序:所有代码都按"先订单后库存"的固定顺序更新
- 缩小事务:行数少、时间短,撞车概率自然低
- 必要时降低隔离级别:读已提交没有间隙锁,死锁面明显缩小
锁家族速查
| 锁 | 锁住的范围 | 出现场景 |
|---|---|---|
| 记录锁 | 单行 | 等值命中唯一索引 |
| 间隙锁 | 索引间隙,不含行本身 | 可重复读下的范围条件 |
| next-key 锁 | 行加前隙 | 范围扫描防幻读 |
| 意向锁 | 表级声明 | 引擎与表锁协调 |
图:锁等待与死锁的形态差异
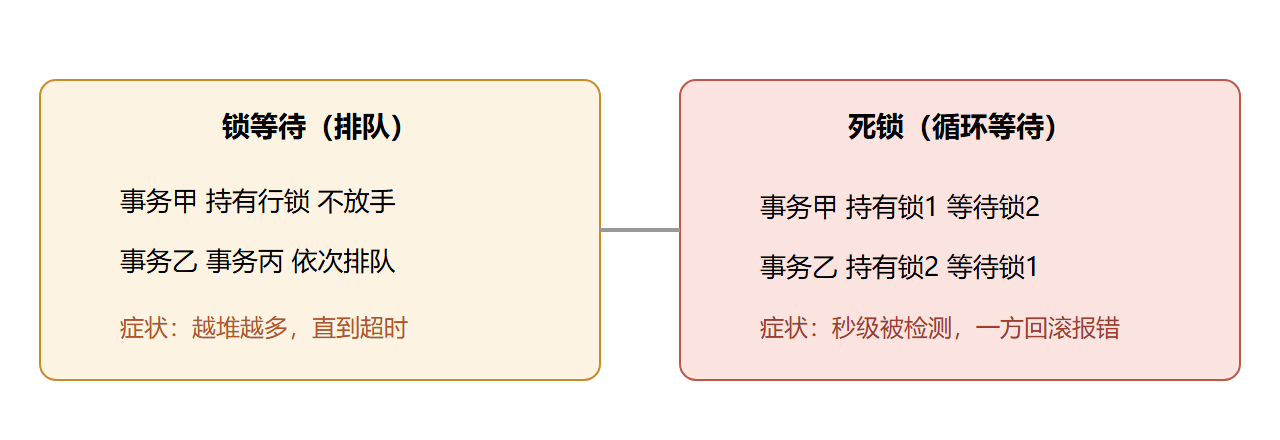
💡 关键直觉:死锁报错不可怕,它说明保险丝起作用了;真正危险的是无声的锁等待——不报错,只是整站越来越慢。
锁的现场取证:data_locks 全家福
8.0 把锁信息搬进了 performance_schema,急诊取证比老版本直观得多。开两个会话重演一次锁等待,第三个会话来取证:
-- 会话A:先动手 START TRANSACTION; UPDATE clinic_order SET status = 3 WHERE order_id = 88; -- 会话B:等待 UPDATE clinic_order SET status = 3 WHERE order_id = 88; -- 会话C:取证 SELECT ENGINE_TRANSACTION_ID, LOCK_TYPE, LOCK_MODE, LOCK_DATA, INDEX_NAME FROM performance_schema.data_locks WHERE OBJECT_NAME = 'clinic_order';
输出里能看到 A 拿着 order_id 88 的记录锁(X 型),B 的请求在 data_lock_waits 里挂着。LOCK_MODE 里出现 GAP 字样就是间隙锁,INVENTORY 里 REC_NOT_GAP 是纯记录锁。把这套取证做成肌肉记忆,线上卡住时第一分钟就能画出"谁拿着什么、谁在等谁"的关系图。
死锁日志判读实战
死锁发生后现场就消失了,唯一的证物是死锁日志。提前打开:
SHOW VARIABLES LIKE 'innodb_print_all_deadlocks'; -- 建议设 ON 落入错误日志
日志分两段,各是一个当事事务:持有的锁、等待的锁、正在执行的语句。判读三步:找双方互相等待的两把锁(A 持有 X 等 Y,B 持有 Y 等 X),圈出两个加锁对象(通常两张表或两个索引区间),回代码里检索两条当事 SQL,确认它们的加锁顺序。九成死锁在这一步现形——两处代码按不同顺序更新同一批行。剩下的一成多与间隙锁有关,判读时注意等待锁的 LOCK_MODE,GAP 相关的死锁在可重复读下天然高发,降到读已提交常直接根治。
预防处方汇总
把本节的预防手段按性价比排个序,贴在团队规范里。第一梯队零成本:统一加锁顺序,写进代码评审清单;事务里禁止外部调用与用户交互。第二梯队低成本:热点行更新采用队列化(应用侧排队再落库);批量任务按主键排序后再逐条更新,让所有事务按同一物理顺序拿锁。第三梯队有取舍:隔离级别降为读已提交消灭间隙锁;等待超时调短让撞车快速失败重试。急诊科的目标从来不是零死锁,而是死锁发生率低、发生时能自愈(应用侧重试)、事后能从日志追到代码——三条都达标,这间病房就算管住了。
等待的代价参数
两个超时参数决定等待的结局,值得认识清楚。innodb_lock_wait_timeout(默认五十秒)管行锁等待,超时报 1205 错误,语句失败但事务不回滚——应用可以捕获重试,这也是把热点冲突设计成"短等待加重试"的依据。innodb_deadlock_detect(默认开)管死锁检测,高并发热点行场景下检测本身有 CPU 开销,个别极端系统会关掉它改用超时兜底,那是专家动作,常规团队别碰:
SHOW VARIABLES LIKE 'innodb_lock_wait_timeout'; -- 应急时调短等待,让堆积快速失败暴露问题 SET GLOBAL innodb_lock_wait_timeout = 10;
调短超时的急诊价值常被低估:五十秒的等待意味着一波高峰能把连接池瞬间占满,雪崩就这样开始;十秒失败的请求配合重试,反而把系统从雪崩边缘拉回来。
本节要点回顾
- 急诊三步:查等待、查持锁事务、KILL 病灶连接
- 死锁三处方:固定加锁顺序、缩短事务、减少间隙锁
- 事务纯洁性:外部调用、慢查询一律滚出事务