6.1 分床位:分区表
6.1 分床位:分区表
本节摘要:分区表把一张逻辑表按规则切到多个物理段,最常见的价值是按时间分区加秒级删旧数据。分区不是性能银弹:查询必须命中分区键才能裁剪,否则反而扫更多段。
建一个按月分区的病历表
CREATE TABLE visit_log ( id BIGINT UNSIGNED AUTO_INCREMENT, user_id BIGINT UNSIGNED NOT NULL, visit_at DATETIME NOT NULL, PRIMARY KEY (id, visit_at) ) PARTITION BY RANGE (TO_DAYS(visit_at)) ( PARTITION p202606 VALUES LESS THAN (TO_DAYS('2026-07-01')), PARTITION p202607 VALUES LESS THAN (TO_DAYS('2026-08-01')), PARTITION p202608 VALUES LESS THAN (TO_DAYS('2026-09-01')), PARTITION pmax VALUES LESS THAN MAXVALUE );
两个细节:分区键必须包含在主键/唯一键里(否则全局唯一无法保证);pmax 兜底分区防止插入越界报错。
分区最爽的手术:淘汰旧数据
-- 不分区时:DELETE 几百万行,锁、binlog、延迟全来了 -- 分区后:一句话,瞬间完成 ALTER TABLE visit_log DROP PARTITION p202606;
查旧数据时分区裁剪同样生效:
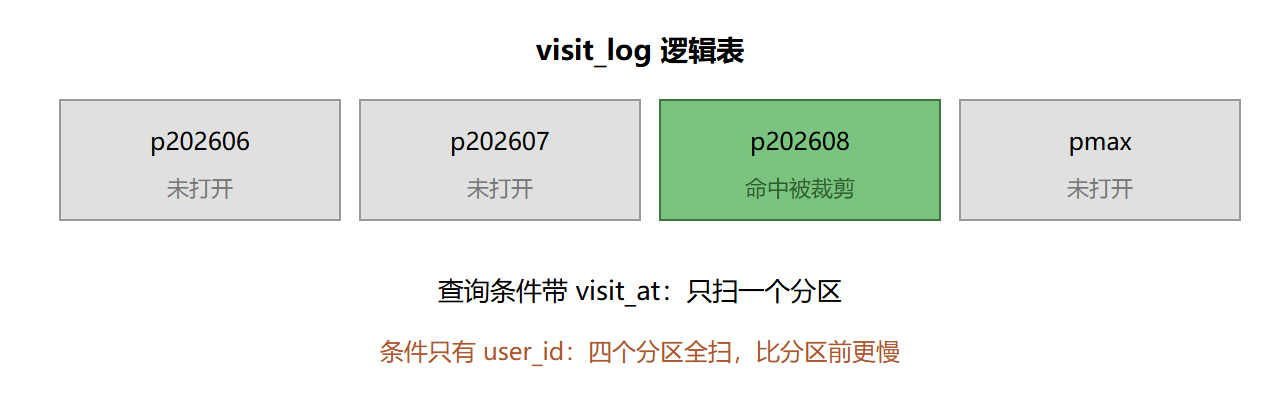
EXPLAIN SELECT COUNT(*) FROM visit_log WHERE visit_at >= '2026-08-01' AND visit_at < '2026-09-01'; -- partitions 列只显示 p202608,其余分区根本没被打开
分区的边界:别指望它加速
分区对单条查询的提升有限——提速靠的是索引,不是分区;如果查询条件里没有分区键,优化器要打开所有分区挨个查,比不分区还多一层开销。分区的真实收益是运维性的:滚动删除、冷热归档、备份按段进行。
⚠️ 常见坑:主键不含分区键建表直接报错;分区数几百个以上时打开文件与规划成本上升,按月分区三五年内的量级刚好。
图:分区裁剪的工作方式
分区表的管理日常
建好分区只是开始,运维节奏才是分区的生命线。每月例行两件事:提前建下月分区、淘汰过期分区。漏建新分区,插入落到 pmax 兜底区,之后想拆分 pmax 是一场重建手术:
-- 例行操作:拆出下月分区,淘汰过期分区 ALTER TABLE visit_log REORGANIZE PARTITION pmax INTO ( PARTITION p202609 VALUES LESS THAN (TO_DAYS('2026-10-01')), PARTITION pmax VALUES LESS THAN MAXVALUE ); ALTER TABLE visit_log DROP PARTITION p202605;
这两个动作本质上都是元数据级操作,秒级完成,可以放进定时任务。规范的做法是把分区维护脚本化并配告警——距离最早分区的时间边界不足两周时就提醒执行,别靠人的记性。
分区键选择的三种常见方案
时间范围分区覆盖大多数场景,但不是唯一解。按时间分区:日志、订单、访问记录,淘汰与裁剪双收益,首选。按主键哈希分区:没有明显时间维度、想均摊写入热点的大表,每个分区各自一棵 B+ 树,写入分散到多个段;代价是没有"删旧数据"的便利,管理的是写入不均衡。按列表分区:多租户系统按租户分,大租户单独一段、小租户合租一段,支持按租户整体归档下线。选型的判断依据回到业务问题:这张表的主要痛点是数据过期、写入热点还是租户隔离,痛点对应方案。
一个真实评估案例:分区没能救报表
某团队听说分区能加速查询,把两亿行的行为表按月分区后,报表反而更慢了。原因:报表的查询条件是"全时间段按用户聚合",不含分区键,每次都要打开全部八十多个分区逐段扫描,段间的打开与合并开销让总耗时增加了三成。结案处方是分区保留(淘汰旧数据的收益是真的),报表搬去列式分析引擎。这个案例的价值在于展示了分区的完整账本:运维收益记在删数据与备份上,查询收益只在带分区键的查询上体现,两项要分开算,混在一起算就会得出"分区提速"的错误预期。
分区表与分库分表:一次概念辨析
名字像,层级完全不同。分区表是单实例内的物理分段:一张逻辑表、一个表名、自动路由,对应用完全透明,天花板是单机资源。分库分表是跨实例的数据分布:多张表甚至多个实例、需要路由层(中间件或应用层分片逻辑)、跨片查询与分布式事务都是新成本,天花板高得多。辨析的实用结论:单机还扛得住、痛点主要是数据生命周期,用分区;写入与存储已超出单机,才考虑分片。中间还有一级"垂直拆库"——按业务域把订单库、用户库分开——它通常比分片更值得先做。见过太多团队跳过分区与垂直拆库直接上分片,然后花三年维护路由层的复杂度,那是最贵的越级手术。
补一个实施层面的收尾:存量大表转分区的迁移。已有一张五千万行的常规表想转按月分区,不能一条 ALTER 硬上——那是全表重建,锁与耗时都不可控。标准路径是影子表迁移:建好分区结构的影子表,按主键分批把数据搬过去,双写或追 binlog 追平增量,校验一致后一次改名切换。全流程与在线改表工具的原理同构,是第 2 章大表 DDL 与第 8 章工具箱两条线索的汇合处。转分区是半年期的大动作,触发它之前值得再问一遍:淘汰旧数据的诉求,用"定期归档加删除"的朴素方案真的解决不了吗——多数表的答案是能解决,分区留给真正需要秒级淘汰的场景。
本节要点回顾
- 核心价值:DROP PARTITION 秒级淘汰、冷热分离、分段备份
- 硬约束:分区键必须进主键;查询不带分区键无裁剪
- 定位:运维利器,不是查询加速器
最后把分区的体检指标也交代清楚,转分区或新建分区的表要持续看三样:各分区的行数分布是否均匀(数据热点会让裁剪效果打折)、分区维护任务是否按时执行(错误日志里找 REORGANIZE 与 DROP 的痕迹)、带分区键与不带的查询占比(后者长期占多数时,这张表的分区就要重新评估价值)。三样指标进监控,分区表才能长期健康地当它的"床位管理员"。