7.2 病历归档:备份策略与Binlog恢复
7.2 病历归档:备份策略与 Binlog 恢复
本节摘要:备份的目标不是"有备份文件",而是"能在约定时间内恢复到任意时刻"。全量用 mysqldump 或物理备份打底,binlog 提供增量回放。本节走一遍完整的误删恢复演练。
备份策略:全量加增量
# 每周日凌晨全量(逻辑备份,小中型库够用) mysqldump --single-transaction --master-data=2 --triggers --routines \ --all-databases > full_20260822.sql
--single-transaction 用一致性快照导出,不锁业务表;--master-data=2 把当时的 binlog 位点写进注释,恢复时知道从哪回放。
大库(几百 GB 起)换物理备份更现实:克隆数据目录或用 Percona 的开源热备工具,直接拷文件,速度不是一个量级。
恢复演练:误删一张表
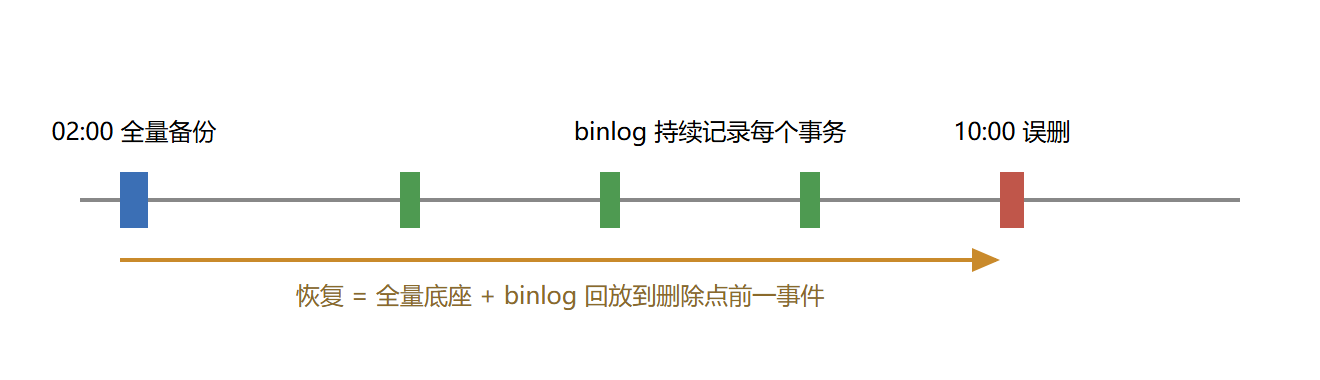
时间线:凌晨 2 点全量备份,上午 10 点值班手滑执行了 DROP TABLE clinic_order。恢复目标:回到删除前一秒。
# 第一步:起一台恢复实例,导入全量 mysql -urestore -p restore_db < full_20260822.sql
-- 第二步:从备份位点回放 binlog,到删除语句前一个事件停 -- 删除语句的事务号假设是 8801-8802
mysqlbinlog --start-position=154 --stop-position=8801 \ mysql-bin.000117 mysql-bin.000118 | mysql -urestore -p restore_db
第三步把恢复实例的表导回生产。整个流程演练过的话,一小时以内能完成;没演练过的团队第一次实操通常要一整天,而且伴随二次事故。
-- 日常自检:binlog 是否开启、保留多久 SHOW VARIABLES LIKE 'log_bin'; SHOW VARIABLES LIKE 'binlog_expire_logs_seconds';
图:全量加增量的恢复时间线
⚠️ 常见坑:备份文件和数据库放在同一块磁盘上,磁盘一坏全灭。备份至少一份异地或上对象存储;恢复演练每季度做一次,没恢复过的备份只是心理安慰。
备份策略的三个参数
定备份策略就是回答三个参数。RPO(最多丢多少数据):全量周备加 binlog 连续开启,理论上限是"零丢失",前提是 binlog 与数据不在同一块盘上一起阵亡。RTO(多久能恢复):几十 GB 的库逻辑恢复要小时级,物理恢复分钟级——业务给的时间预算决定选型。保留窗口:全量至少留两份跨周,binlog 至少覆盖一个全量周期再加缓冲,合规行业按法规加长。三个参数写进备份制度,比任何工具配置都重要。
大库与增量有两条实用路线。物理备份加 binlog:几百 GB 到 TB 级的主力路线,克隆数据目录或用开源热备工具,恢复速度决定性优势。表级逻辑备份:只需保护少数核心表时,用带单表参数的导出,备份窗口和体积都可控:
# 核心表单独每日备份,配合每周全量 mysqldump --single-transaction clinic clinic_order clinic_user \ | gzip > core_$(date +%F).sql.gz
恢复演练的完整剧本
演练不是"把备份导进去看看",要按真事故的剧本走。剧本设定:某周三 14:23 误执行了不带 WHERE 的 UPDATE,波及订单表全表,14:26 发现并停写。恢复路径不导全量——太慢,而是"前一天的每日备份加当天的 binlog 回放到 14:22:59"。演练计时从宣布开始到业务确认数据正确为止,每个环节记录耗时:找备份文件五分钟、起恢复实例十分钟、导入四十分、回放 binlog 二十分、校验十分钟,全流程一小时半。下次真事故的心理底气,就来自这张时间表。
# 回放到事故前一秒:binlog 事件里先定位误操作的事务边界 mysqlbinlog --start-position=154 --stop-datetime="2026-08-19 14:22:59" \ mysql-bin.000121 | mysql -urestore -p restore_db
按时间切比按位点切更容易出错(同一秒可能多个事务),生产恢复优先位点定位,演练时两种都练。
binlog 的日常体检
binlog 是恢复链条的供血血管,体检三查:查开启与格式,ROW 格式是复制与恢复安全的默认;查保留期,磁盘紧张被误调短是常见隐患;查空间占用,大事务会让单个 binlog 文件暴涨,监控它等于间接监控大事务:
SHOW VARIABLES LIKE 'log_bin%'; SHOW BINARY LOGS; -- 看每个文件的尺寸与总量
体检之外的一个纪律:任何"清 binlog 腾空间"的操作前,确认备份流水线已经消费完最新文件。删掉的 binlog 补不回来,恢复链条断一节,前面的全量就只剩半条命。
延迟从库:后悔药的另一副配方
备份加 binlog 是标准后悔药,还有一副配方值得知道:延迟从库。把一个从库的复制刻意延迟(比如一小时),误操作执行后的一小时内,延迟从库上数据还是好的——直接切上去导出被误删的表,比从备份加 binlog 回放快得多:
-- 从库上设置延迟(8.0 支持动态调整) STOP REPLICA SQL_THREAD; CHANGE REPLICATION SOURCE TO SOURCE_DELAY = 3600; START REPLICA SQL_THREAD;
它防的是"备份窗口内的新数据丢失"与"恢复时间"两个痛点,代价是多养一个实例。误删高发的团队(大量手工运维操作的)值得配一副;全自动化操作居多的团队,标准备份路线够用。两副配方不冲突,重要系统可以都备着。
本节要点回顾
- 策略:每周全量加 binlog 增量,RPO 由 binlog 粒度决定
- 恢复三步:导全量、按位点回放、回迁数据
- 演练制度化:不演练的备份等于没有备份