4.1 组表 Group Table 解剖
4.1 组表 Group Table 解剖
本节摘要:组表是流表之外的另一张动作抽象表:流条目里的 GROUP 动作不直接指定端口,而是指向一个"组",组里装着若干动作桶(Action Bucket)。四种组类型——all、select、indirect、fast failover——分别覆盖组播、负载均衡、间接引用与故障切换。本节拆解组条目字段与四种类型的执行语义。
为什么需要组表
流条目的一个 OUTPUT 只能指一个端口。要做组播(一份进、多份出)或双上行链路冗余,纯流表得靠控制器实时增删条目,慢且抖。组表把"多出口"抽象成数据面原生能力:交换机本地就能复制、选择、切换,控制器只维护组定义。
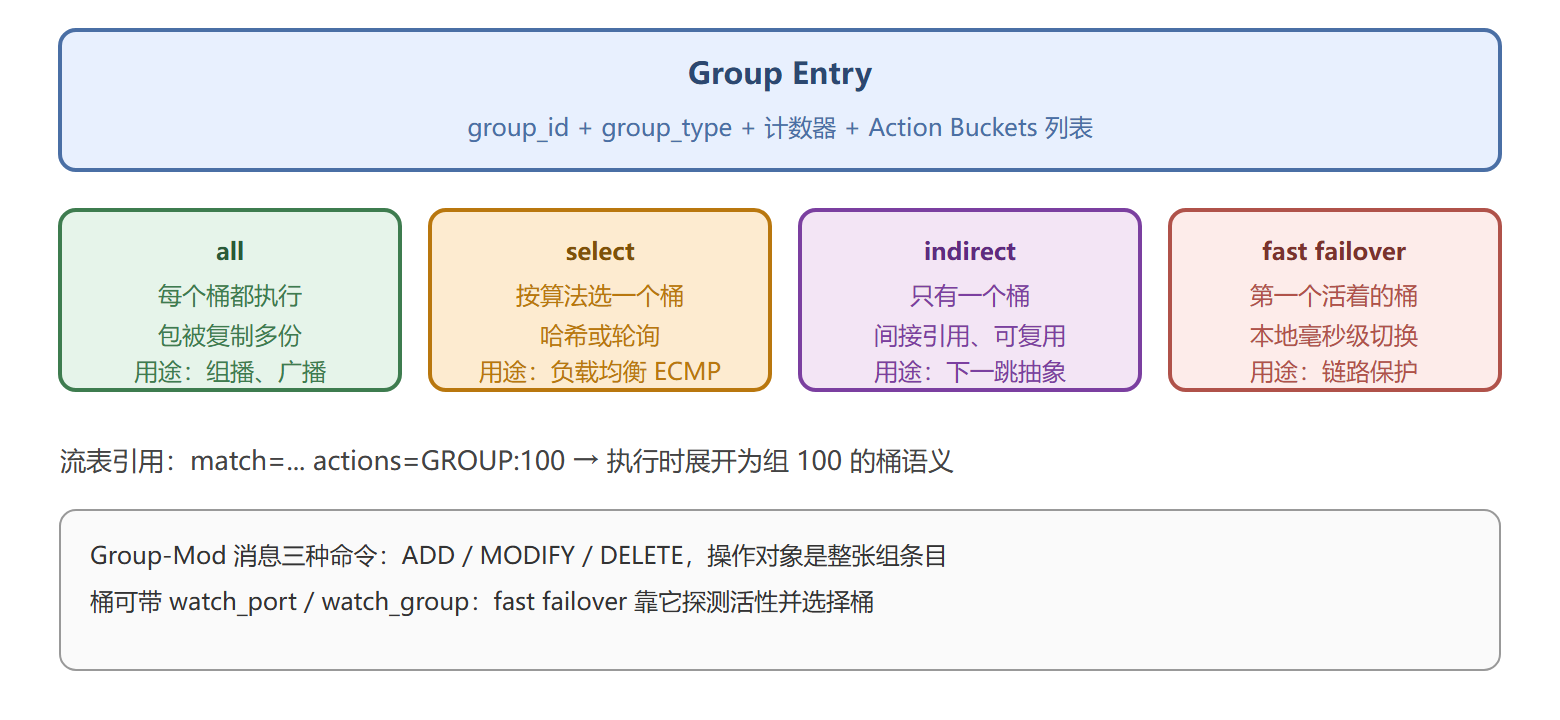
组条目结构与四种类型
四种类型的语义细节
- all:交换机对每个桶各复制一份包独立执行。组播复制时注意 TTL 与 MAC 改写要在桶内各自完成——复制的是流水线出口的同一份包,不会各自重跑流水线
- select:选桶算法由实现决定(简单轮询或五元组哈希),select 组支持权重字段做加权分发
- indirect:单桶组,看似多余,实为工程利器——把"下一跳策略"定义成一个组,几百条流条目引用同一个组 id,改路径时只需 MODIFY 一个组
- fast failover:交换机按桶序检查 watch_port 的 liveness,选中第一个活桶执行。切换发生在数据面本地,不惊动控制器,这是它比控制器重路由快几个数量级的原因
动手:配一个组播组
在实验台用 ovs-ofctl 直接构造 all 组(编号 100),把流量复制到端口 2、3、4:
sudo ovs-ofctl -O OpenFlow13 add-group s1 \ "group_id=100,type=all,bucket=output:2,bucket=output:3,bucket=output:4" sudo ovs-ofctl -O OpenFlow13 add-flow s1 \ "ip,nw_dst=239.1.1.1,actions=group:100" sudo ovs-ofctl -O OpenFlow13 dump-groups s1
在 h2、h3、h4 上同时抓到 239.1.1.1 的包,就是组表在数据面完成的三倍复制。对应的 Wireshark 里能看到 Group-Mod(type=15 家族)的桶列表逐字段展开——group_id、type、bucket 数量与每个桶的动作序列。
⚠️ 常见坑:删除组前不清理引用它的流条目,交换机行为未定义(有的直接 Error,有的流量黑洞)。先删流后删组,顺序别反。
💡 关键直觉:组表是"数据面的子程序"——流表调用它,控制器定义它。把可复用的转发策略封装成组,规则数量能降一个量级。
动手:fast failover 的切换实验
failover 的毫秒级切换可以在解剖台上量化。拓扑用三台交换机串成一条主路径加一条备份路径,在中间节点配一个 fast failover 组,第一桶 watch 主路径端口,第二桶 watch 备份端口:
# 建组:桶 1 走主路径 2 口,桶 2 走备份 3 口 sudo ovs-ofctl -O OpenFlow13 add-group s1 \ "type=ff,id=1,bucket=watch_port:2,output:2,bucket=watch_port:3,output:3" # 业务流指向组 sudo ovs-ofctl -O OpenFlow13 add-flow s1 \ "table=0,priority=100,ip,nw_dst=10.0.0.9,actions=group:1" # 切换证据在组统计里: sudo ovs-ofctl -O OpenFlow13 dump-group-stats s1 # bucket1: packet_count 从切换时刻起接管
对照组实验更能说明问题:把组换成普通 OUTPUT 指向主路径,同样拔链路,丢包会持续到控制器的 Port-Status 触发重路由为止(Ryu 环境下通常几百毫秒到秒级)。两者的差值就是"数据面本地切换"与"绕道控制面"的固有代价差。生产上做高可用路径设计时,这个实验应该作为验收项跑一遍——watch_port 探活依赖交换机端口的 liveness 信号,个别厂商实现只认管理性 down 而对物理信号劣化反应迟钝,这种差异只有实验能暴露。
删除语义与引用计数:Group-Mod 的坑
组被流表引用时直接 DELETE 会怎样?规范允许交换机拒绝,行为是回 Error,但 OVS 的实际行为版本间有过差异,跨设备代码绝不能赌这个。工程正确姿势是三步走:先改流表解除引用(把 GROUP 动作的条目删掉或改写),再删组,最后用 Barrier 确认两步都落地。批量下发的顺序同理:先 ADD 组、后 ADD 引用它的流;这个顺序反了,交换机在收到流条目的瞬间找不到组 id,同样是 Error。把"组先于流建、流先于组删"写成控制器代码里的固定注释,能省掉未来很多深夜排障。
最后补一条 select 组的工程注意:选桶算法实现自由意味着跨设备不可预测——同一拓扑换一批交换机,哈希种子不同,分担比例的微观分布会变。依赖 select 做精确流量切分(而不是粗粒度分担)的设计是脆弱的。此外 watch_port 与 liveness 信号只对 fast failover 组生效,把它写进 select 组的桶里没有任何保护语义,这种"配置看起来很安全、实际上不生效"的错误只有通过拔线演练才能暴露,所以 4.1 的动手实验应当作为组表相关变更的固定验收步骤。
本节要点回顾
- 结构:group_id + type + counters + 动作桶列表,Group-Mod 三命令维护
- 四类型:all 复制、select 分发、indirect 复用、fast failover 本地保护
- failover 优势:watch_port 探活 + 数据面切换,毫秒级
- 删除顺序:先解除流表引用,再删组
速度的边界在哪里?下一节解剖 Meter。