6.3 GroupBy窗口函数与倾斜治理
6.3 GroupBy、窗口函数与倾斜治理
本节摘要:聚合是 Hive 最重的负载,也是倾斜灾害的高发区。本节先补全两段式聚合与倾斜 Join 的参数体系,再讲窗口函数的翻译结构(分区键即 Shuffle 键、排序键即 Reduce 端排序序),最后给出倾斜治理的完整打法:识别、归因、按类型选择加盐或拆解,并核算每种手段的代价。
倾斜长什么样
第 3 章描述过画面:进度条 99% 任务完成、剩一个 Reduce 跑半小时。定量一点的识别方法有两层:
进度层:YARN 的应用页面或任务日志里,Reduce 任务耗时分布出现明显长尾——多数任务分钟级完成,个别任务十倍百倍于中位数。
数据层:EXPLAIN ANALYZE 的输出里,倾斜键的聚合组对应超大的 actual rows;或者直接统计键分布:
SELECT customer_id, COUNT(*) AS cnt FROM mall.orders WHERE dt = '2026-01-16' GROUP BY customer_id ORDER BY cnt DESC LIMIT 20;
头部键占比一目了然。识别永远从分布开始——不知道哪个键重,一切治理都是盲打。
归因分三类,治法不同:聚合倾斜(某个分组键行数巨大)、连接倾斜(某个连接键在一侧是超级键)、全局小基数(键就那么几个,天生分不匀,比如按全国省份聚合)。
聚合倾斜:两段式聚合与它的失效场景
标准两段式聚合(第 2 章的 Map 端聚合规则)本身就有抗倾斜能力:Map 任务本地预聚合把同键行压成部分值,Reduce 端合并。它的失效场景是"键基数接近行数":一亿行、九千万个不同键,本地预聚合几乎压不动(每个键就一两行),网络上传约等于全量行,还要先付本地聚合的排序成本。EXPLAIN 里此时可以考虑关掉 Map 端聚合直接传输:
SET hive.map.aggr = false;
反过来,键基数低(倾斜的头部键)时两段式依然有效——头部键在本地就能压掉大部分体量。真正的尾部问题是Reduce 任务数与键分布不匹配:默认 Reduce 数有限,头部键所在的那个任务拖尾。这时要上打散手段。
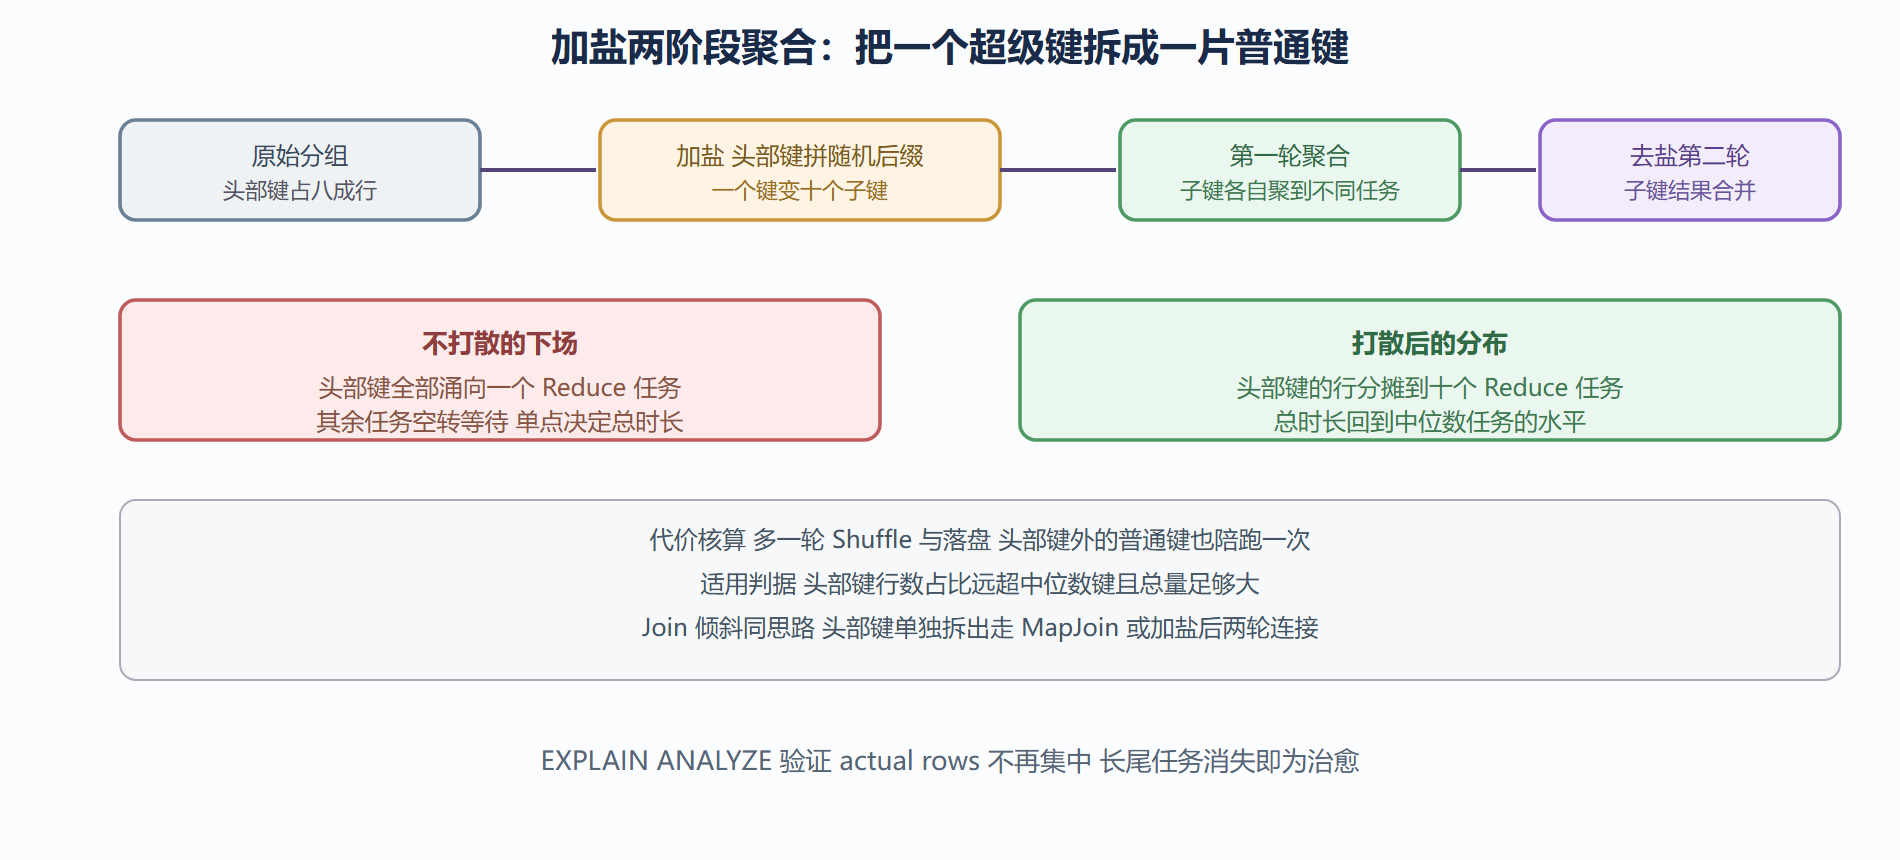
加盐打散(聚合版)。给倾斜键加随机后缀拆成若干子键,先聚合一轮,再去掉后缀聚合第二轮:
-- 第一轮 头部键加盐打散 SELECT region, CASE WHEN cnt_flag = 1 THEN concat(region, '_', cast(floor(rand() * 10) AS STRING)) ELSE region END AS salted_key, COUNT(*) AS part_cnt FROM mall.orders WHERE dt = '2026-01-16' GROUP BY region, cnt_flag ...; -- 第二轮 去盐聚合 SELECT region, SUM(part_cnt) FROM 第一轮结果 GROUP BY region;
(cnt_flag 由头部键清单标记,实践中头部键先单独识别再 CASE 标记,完整实现见下方思路图。)代价是两轮聚合、一轮落盘,只对"头部键占比极高"的场景划算。
倾斜治理两阶段聚合思路
Join 倾斜的参数与拆解。连接倾斜先试参数(对 Hive 版本行为有依赖,先小流量验证):
SET hive.optimize.skewjoin = true; SET hive.skewjoin.key = 100000; -- 超过该行数的连接键视为倾斜键
机制:倾斜键的行不参与常规 Shuffle,单独走一条路径(写入临时目录,用对侧小结果做 MapJoin 补连接),其余键正常走。参数不生效或版本行为不符时,手工拆解:识别头部键清单,把含头部键的行拆成独立分支(头部键对侧匹配行通常很小,走 MapJoin 稳赢),两个分支的结果 UNION ALL 回来。
全局小基数的另案处理。按省份、渠道这种天生十几个键的维度聚合,怎么打散都只有十几个组,Reduce 并行度上不去。此时方向不是打散而是减少扫描:分区裁剪做足、列裁剪做足,让"每个键的行"尽量少;或者接受现实——这类查询的瓶颈在扫描不在聚合,优化方向回到存储层(第 7 章)。
窗口函数的翻译结构
窗口函数(Hive 0.11 引入,2.x 后逐步补全族谱)在语义上"既分组又不折叠"——每组算出一个值,但每行都带着结果输出。翻译结构有定式:
SELECT customer_id, dt, amount, SUM(amount) OVER (PARTITION BY customer_id ORDER BY dt) AS running_sum, ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY amount DESC) AS rn FROM mall.orders WHERE dt >= '2026-01-01';
- PARTITION BY 键成为 Shuffle 分区键:同一 customer 的行进同一 Reduce 任务(与 GROUP BY 的分布规则同源);
- ORDER BY 键成为 Reduce 端排序键:任务内按 dt 排序后,窗口沿排序序列滑动;
- 函数计算发生在排序缓冲区上:SUM 这类可累积函数边扫边更新增量;ROW_NUMBER 递增计数;RANK 类需要比较前值;
- 行不折叠:与 GROUP BY 的本质区别——Reduce 输出的行数等于输入行数。
由此推出三个性能直觉:窗口函数必然引发一次完整 Shuffle(分区键至少一个,逃不掉);窗口分区基数越高 Shuffle 越贵(和 GROUP BY 同理);每客户取前 N 的经典需求(ROW_NUMBER 加子查询过滤 rn)比多次自连接便宜得多,但仍是"全量行过网络后再过滤",源表能预过滤的一定先过滤。
EXPLAIN 里窗口函数的指纹:Reduce 端出现 Windowing Operator(或 PTF 相关算子树),keys 含 PARTITION BY 键、排序说明含 ORDER BY 键。
倾斜治理决策表
| 场景 | 首选手段 | 验证动作 |
|---|---|---|
| 聚合高基数 Map 端聚合失效 | 关 map.aggr 少付本地排序 | EXPLAIN 看 mode 变化 |
| 聚合头部键超大 | 加盐两阶段聚合 | ANALYZE 看 actual rows 分摊 |
| 连接头部键 | skewjoin 参数 或手工拆键走 MapJoin | 进度页看长尾是否消失 |
| 天生小基数 | 扫描层减负 分区列裁加列裁 | 路径区与投影清单 |
| 不明原因长尾 | 先 ANALYZE 取证再动手 | 分布统计定位键 |
本节要点回顾
- 识别从分布开始:进度长尾加键分布统计,两层数据锁定病灶;
- 两段式聚合的双面性:低基数抗倾斜,高基数反而负资产,看 mode 参数切换;
- 加盐两阶段:超级键拆子键、两轮聚合、代价是加一轮 Shuffle,头部键占比高才划算;
- Join 倾斜:先参数后拆解,头部键单独走 MapJoin 是稳招;
- 小基数另案:瓶颈在扫描不在聚合,治理回到分区与列裁剪;
- 窗口函数定式:分区键即 Shuffle 键、排序键即 Reduce 排序、行不折叠、必付一次 Shuffle。