1.2 一切皆对象:对象、类型与值
1.2 一切皆对象:对象、类型与值
本节摘要:Python 中每个数据——数字、字符串、函数、类、模块——都是对象。每个对象有三要素:身份(id)、类型(type)、值(value)。本节用 REPL 实验逐条验证这一点,并揭示"类型也是对象"的自举结构与小整数缓存等解释器优化。
一个反直觉的实验开场
先看四行代码,来自真实的 REPL 会话:
>>> type(42) <class 'int'> >>> type(len) <class 'builtin_function_or_method'> >>> type(int) <class 'type'> >>> type(type(int)) <class 'type'>
最后一行是本节的题眼:int 这个类型本身,也是个对象,它的类型是 type;而 type 的类型还是 type。在 Java 里"类"和"对象"是两个世界的词,在 Python 里只有一个世界——堆上都是 PyObject,类不过是"能生产实例的特殊对象"。
这不是语言学家的小游戏。理解了它,你才能接受后面这些写法:把函数存进字典做分发、给类在运行时加属性、用 type 三参数形式动态造类(第 4 章元类预览)。
对象三要素
CPython 的 C 源码里,所有对象的开头都是两根指针:一根指向它的类型对象,一根是引用计数。由此展开对象三要素:
| 要素 | 获取方式 | 含义 | 会变吗 |
|---|---|---|---|
| 身份 | id(obj) |
对象的唯一编号,CPython 中即内存地址 | 创建后终身不变 |
| 类型 | type(obj) |
决定对象支持哪些操作、如何解释其内存 | 不可变 |
| 值 | 对象本身承载的数据 | 如字符串的内容、列表的元素 | 可变对象可改,不可变对象不可改 |
动手验证"身份终身不变、值可以变":
>>> nums = [1, 2, 3] >>> first_id = id(nums) >>> nums.append(4) # 修改的是值,不是身份 >>> id(nums) == first_id True >>> nums [1, 2, 3, 4]
对比字符串——不可变类型想"改"就只能造新对象:
>>> s = "hello" >>> old_id = id(s) >>> s = s + " world" # + 造了一个全新的 str 对象 >>> id(s) == old_id False
对象头的内存示意
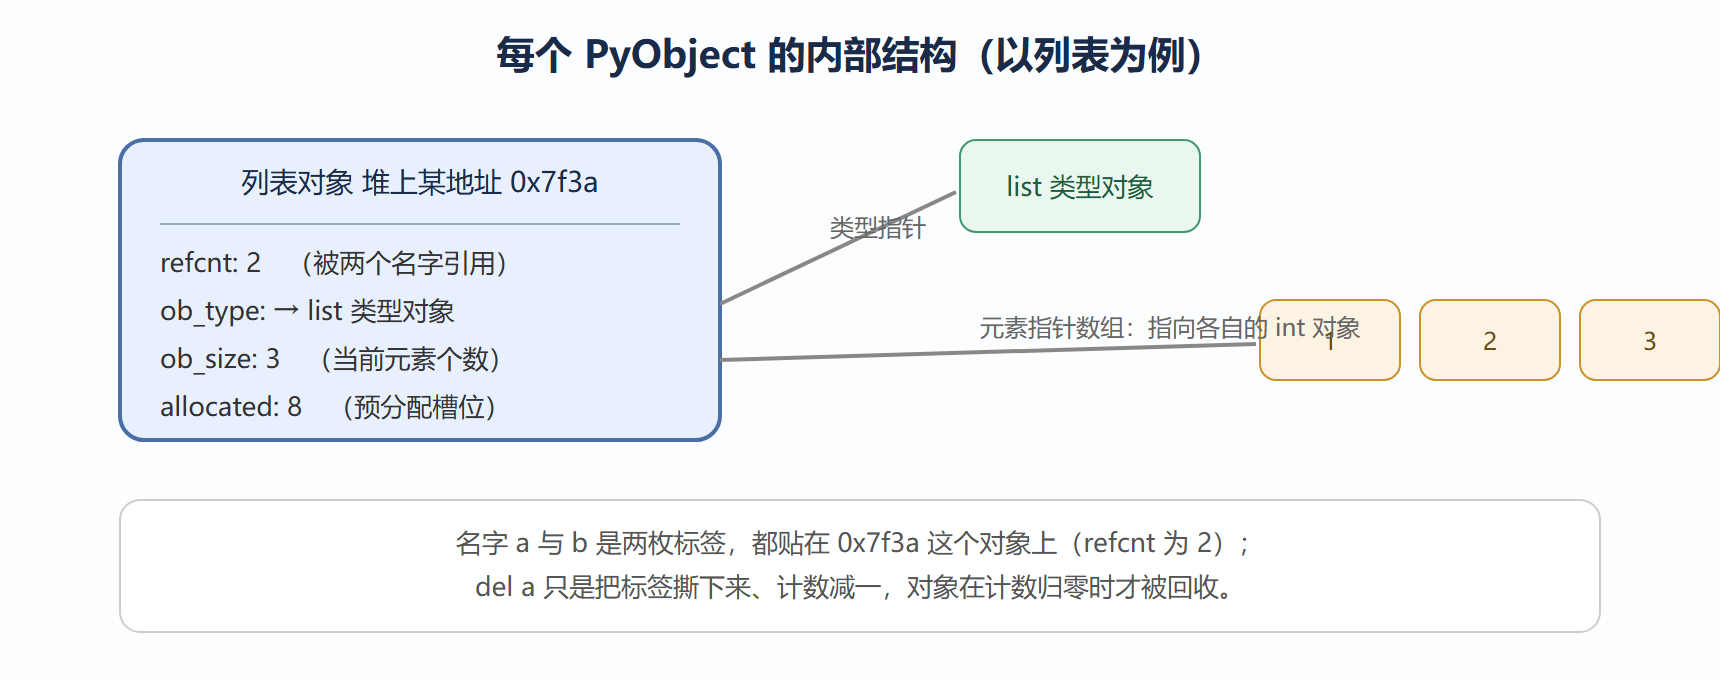
引用计数:对象的一生
对象的死亡由引用计数管理。sys.getrefcount 可以偷看(注意它自己传参也会临时加一,所以看到的值比真实多 1):
>>> import sys >>> a = [1, 2, 3] >>> b = a # 第二枚标签 >>> sys.getrefcount(a) # 3 = a + b + 传参临时引用 3 >>> del b >>> sys.getrefcount(a) 2
当最后一个引用消失,CPython 立刻释放该对象(这是与 Java 式分代回收最大的不同;当然,循环引用要靠额外的循环垃圾检测器处理——两个对象互相引用但已无人使用时,靠计数是发现不了的)。第 8 章讲 GIL 时会再回到内存管理,因为引用计数的线程安全正是 GIL 存在的历史原因之一。
小整数缓存与驻留:解释器在偷偷优化
看一个面试高频实验:
>>> a = 100 >>> b = 100 >>> a is b True >>> c = 1000 >>> d = 1000 >>> c is d False
同样是两个字面量赋值,100 共享对象,1000 各造各的。原因:CPython 启动时把 -5 到 256 的整数预先建好、全局共享,任何地方用到都取同一个——因为小整数出现频率极高,缓存稳赚。而 1000 在 REPL 的两行语句里分别创建了新对象。
⚠️ 这直接推出一条工程铁律:比较值永远用
==,is只用于身份判断(典型如if x is None)。is的结果依赖解释器缓存策略,拿它比数值或字符串等于在沙滩上盖楼。
字符串也有类似现象,叫驻留(intern):看起来像标识符的字符串常量会被共享。同样只当冷知识理解,别依赖。
is 与 ==:两个维度的问题
== 问的是"值相等吗",走的是对象的 __eq__ 方法;is 问的是"是同一个对象吗",比较 id:
>>> lst1 = [1, 2, 3] >>> lst2 = [1, 2, 3] >>> lst1 == lst2 # 值相同 True >>> lst1 is lst2 # 但它们是堆上两个独立对象 False >>> lst1.append(4) >>> lst2 # lst2 不受影响——它们从一开始就互不相干 [1, 2, 3]
把这四行跑一遍,"比较"这个动作在你脑中就分了层。第 1.3 节会把"同一个对象、多个名字"的反面情形讲透——那是更多 bug 的来源。
函数与类也是对象,能拿来做什么?
对象身份带来的直接能力是"函数可以像值一样传递":
def shout(text): return text.upper() + "!" def whisper(text): return text.lower() + "..." dispatch = {"loud": shout, "quiet": whisper} # 函数作为字典的值 dispatch["loud"]("hello") # 'HELLO!' shout.kind = "verb-ish" # 函数对象甚至能有属性 print(shout.kind) # verb-ish
如果你从 C 或 Java 来,会意识到这里没有函数指针的语法噪音,也没有反射 API 的繁琐——函数就是普通的堆对象。这一性质是第 3 章高阶函数、第 7 章装饰器的全部基础。
💡 关键直觉:遇到任何 Python 实体,先问三个问题——它的 id 是什么(身份)、type 是什么(能力从哪来)、值可不可变(操作后果)。三问答完,这个实体在你面前就没有秘密。
本节要点回顾
- 三要素:身份终身不变、类型决定行为、值是否可变由类型决定。
- 自举结构:
type(type(int))是 type——类型也是对象,这解释了 Python 高度动态的能力来源。 - 引用计数:
sys.getrefcount可实证;计数归零即回收,循环引用另靠垃圾检测器。 - 小整数缓存:-5 到 256 共享对象,所以
is比较值不可靠,比较身份才用它。 ==走__eq__,is比 id:两者维度不同,混用是真实项目里的高频 bug。- 函数是对象:能存进容器、能加属性,这是一等公民的确切含义。
下一节把三要素里的"身份"推到日常操作上:赋值、传参、别名——Python 里没有值传递还是引用传递的争论,只有名字绑定。