4.1 类对象与实例对象
4.1 类对象与实例对象
本节摘要:类定义执行时发生了什么、实例诞生走哪几步、属性查找按什么顺序——本节把这三个机制讲透。工具依然是老三样:
type、__dict__、dis。顺带讲__slots__、property 与 dataclass,把"写类"从语法层面抬到机制层面。
class 语句其实是在执行代码
一个被广泛误解的事实:class 不是声明,是可执行的语句。解释器执行到它时,会做三件事:
- 新建一个命名空间(可以理解为临时的 dict);
- 把类体当作代码在这个命名空间里执行——所以类体里可以写 if、循环、甚至 print;
- 调用
type(name, bases, namespace)造出类对象,绑定到类名。
第 3 步等价于下面这种"手工造类":
def init(self, name, age): self.name = name self.age = age def bark(self): return f"{self.name}: 汪汪" Dog = type("Dog", (object,), {"__init__": init, "bark": bark, "species": "犬"}) d = Dog("旺财", 3) d.bark() # '旺财: 汪汪'
与 class Dog: ... 写法完全等价。type 的三参数形式揭示了身份:类是 type 的实例(第 1.2 节的自举闭环在此落地)。控制"类如何被创建"的机制叫元类,框架里常见;日常业务把它当"知其存在"即可。
实例的诞生:两步走
class Dog: species = "犬" # 类属性:所有实例共享 def __init__(self, name, age): self.name = name # 实例属性:各存各的 self.age = age d = Dog("旺财", 3)
Dog("旺财", 3) 的完整旅程:先 type(d).__new__(分配空对象)→ 再 __init__(填装属性)。__init__ 不是构造器,是初始化器——它收到 self 时对象已经存在。证据链:
>>> d.__dict__ # 实例属性全在这 {'name': '旺财', 'age': 3} >>> Dog.__dict__['species'] # 类属性在类的字典里 '犬' >>> d.__dict__['name'] is Dog.__dict__.get('name') # 两个存储,互不相干 False
类、实例与 type 的关系
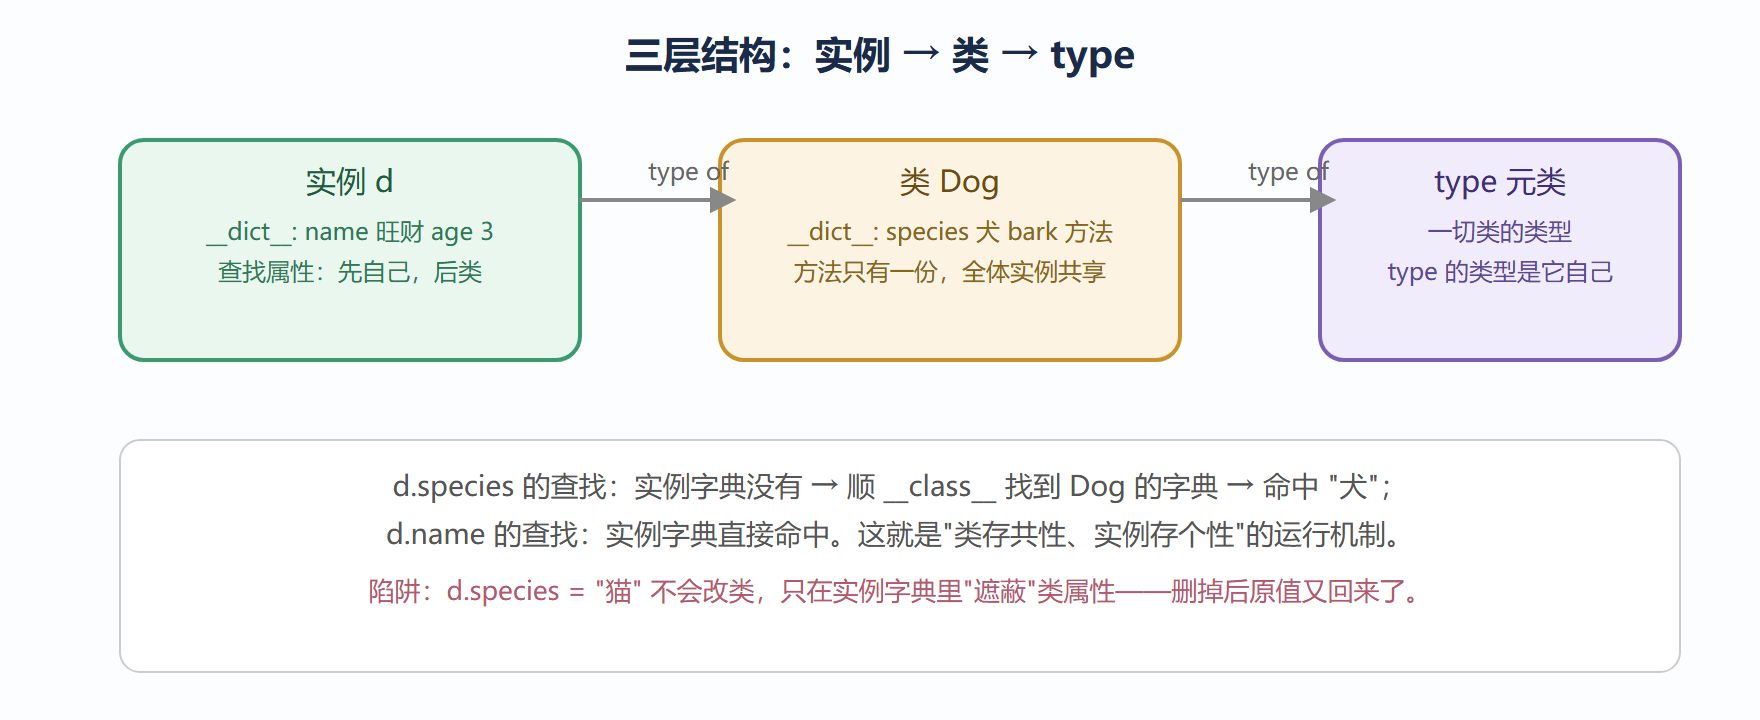
遮蔽实验值得亲手跑一遍:
>>> d.species = "猫" # 在实例字典里新建一个同名键 >>> Dog.species, d.species ('犬', '猫') >>> del d.species # 撤掉遮蔽 >>> d.species '犬'
d.bark() 的机制也在此框架内:属性查找在类字典里找到普通函数,然后经描述符协议绑定为方法(等价于 Dog.bark(d)——把实例填进第一个参数)。所以 Python 的"方法"没有魔法,是"函数 + 第一个参数自动填充"。
私有约定与 @property
双下划线前缀触发名称改写(self.__x 变成 self._Dog__x),它防的是无意的属性冲突,不是访问控制——改写后的名字照样能访问。工程实践里更常见的是:单下划线表示"内部使用"的君子协定。
对外暴露受控属性,用 @property 把方法伪装成属性:
class Temperature: def __init__(self, celsius): self._celsius = celsius @property def fahrenheit(self): return self._celsius * 9 / 5 + 32 @fahrenheit.setter def fahrenheit(self, value): self._celsius = (value - 32) * 5 / 9 t = Temperature(100) t.fahrenheit # 212.0,像属性一样读,背后是方法 t.fahrenheit = 32 t._celsius # 0.0,写入也走了换算
property 本质是描述符(一个接管属性读写协议的对象),它是"Java getter/setter"的 Python 回答:先公开普通属性,需要校验时再无痛升级为 property,调用方代码一行不改。
__slots__ 与 dataclass
实例字典是灵活性的来源,也是内存大头。百万级实例的场景可以关掉它:
class Point: __slots__ = ("x", "y") # 不再有 __dict__ def __init__(self, x, y): self.x, self.y = x, y >>> p = Point(1, 2) >>> p.z = 3 AttributeError: 'Point' object has no attribute 'z' >>> sys.getsizeof(Point(1,2)) + sys.getsizeof({}) # 对比普通实例省下整份字典
代价是不能再动态加属性、多继承受限。我的建议:数据类数量巨大(游戏实体、粒子、行情快照)才启用,一般业务别为省那点内存牺牲灵活。
日常写数据类,标准库的 dataclass 能免掉大样板代码:
from dataclasses import dataclass, field @dataclass class Order: id: int items: list = field(default_factory=list) # 避开可变默认参数坑 def total(self): return len(self.items) Order(1, ["a", "b"]).total() # 2
@dataclass 自动生成 __init__、__repr__、__eq__(3.10 起 @dataclass(frozen=True, slots=True) 一行加上不可变与瘦身)。类型注解在这里从"文档"变成"字段声明",第 7.3 节会接上这条线。
⚠️ 常见坑:类属性可变对象(如
tags: list = []写在类体里)被所有实例共享,与函数默认参数坑同源;__init__里忘了给某属性赋值,__repr__先访问就炸;继承时__slots__与__dict__的组合规则易踩雷,先测再加。
💡 关键直觉:写类时默念两问——这个数据是共性还是个性(类属性还是实例属性)?这个属性是存储还是计算(普通属性还是 property)?
深挖:属性查找的完整顺序
把 4.1 节的简化版(先实例后类)升级成完整版,这是理解 property、描述符与继承的钥匙。解释器取 obj.attr 时的完整顺序是:先看类型(注意是类型不是实例)的字典里有没有数据描述符(同时定义了 get 与 set 的对象,property 是典型)——有则完全接管;没有,再看实例自己的字典;实例没有,再沿 MRO 逐层找类的字典,普通方法、非数据描述符在这里命中;全部落空才触发 __getattr__ 兜底(如果定义了)。这个顺序解释了两个现象:为什么 property 能压住同名实例属性——它作为数据描述符排在实例字典前面;为什么类里的普通函数不会压住实例字典里的同名值——它不是数据描述符,实例字典优先。日常编码碰不到描述符这个词,但 property、classmethod、staticmethod、超级多的 ORM 字段定义,底层全是描述符协议。记住顺序,遇到"属性明明赋了值却不生效"的诡异问题时,先问一句:这条链上是不是有个描述符在半路接管。
本节要点回顾
- class 是执行语句:类体在临时命名空间执行,产物是 type 的实例。
- 实例诞生两步:
__new__分配、__init__填装;后者收到的是已存在的 self。 - 两个字典:实例存个性、类存共性;属性查找先实例后类;实例赋值只是遮蔽。
- 方法即绑定:类字典里的普通函数 + 首参自动填充,没有独立的方法对象。
- property 是受控属性的升级通道;
__slots__用灵活性换内存;dataclass 消灭样板。 - 双下划线名称改写防冲突不防访问,工程边界靠约定。
下一节把单个类放进类型网络:MRO 决定查找顺序,魔术方法决定"像不像"内置类型。