6.1 文件操作与上下文管理
6.1 文件操作与上下文管理
本节摘要:文件读写的基本功(模式、编码、缓冲、大文件策略),以及 with 语句的协议本质——
__enter__/__exit__这对魔术方法。你会看到"自动关闭"不是语法糖魔法,而是一份双向契约;并且亲手给计时器实现一个上下文管理器。
最小可用样板与它的每处细节
with open("log.txt", "w", encoding="utf-8", newline="\n") as f: f.write("服务启动\n")
逐项拆解这行代码里的四个决定:
- 模式 "w":写模式,存在即清空。追加是 "a",读是 "r"(默认)。带 + 号("r+"/"w+")读写皆可,带 b 变二进制;
- encoding 显式声明:2.3 节的教训落地——不写 encoding,默认码表随平台漂移,Windows 上读 UTF-8 文件就是一场 UnicodeDecodeError 之旅;
- newline="\n":统一换行符,避免 Windows 程序写出 "\r\n" 污染跨平台数据;
- with:本节主角,保证 f 关闭——包括写一半抛异常的情况。
读文件三种姿势按场景选:
with open("log.txt", encoding="utf-8") as f: text = f.read() # 一口吞:文件小(凭经验 < 几十 MB)时最直接 with open("log.txt", encoding="utf-8") as f: for line in f: # 逐行:大文件的正解,内存占用恒定 process(line) with open("log.txt", encoding="utf-8") as f: chunk = f.read(4096) # 定长块:二进制流、网络搬运的标准写法
逐行迭代文件对象能工作的原因值得点破:文件对象实现了迭代协议(3.1 节),__next__ 逐行读并以 StopIteration 收尾——学过的机制再次无缝衔接。
二进制读写(图片、压缩包、序列化数据)把 b 加进模式,此时禁止传 encoding,读写单位是 bytes:
with open("photo.jpg", "rb") as src, open("copy.jpg", "wb") as dst: while chunk := src.read(65536): # 海象运算符:读兼判空 dst.write(chunk)
一个 with 逗号并排两个资源,两个都会被正确关闭。
文件缓冲与块搬运
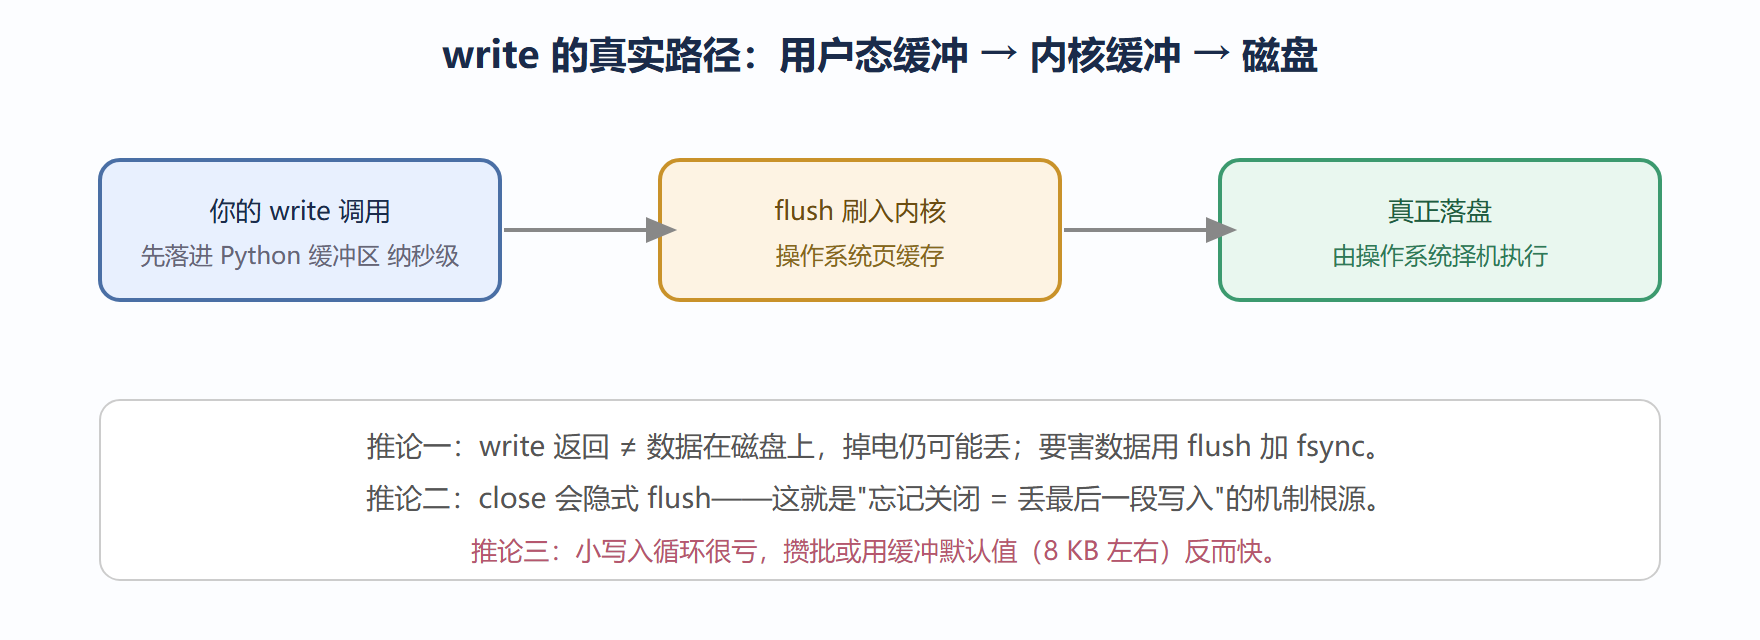
with 的协议本质
with open(...) as f: 翻开协议是一段固定对话:
mgr = open(...) # 1. 拿到上下文管理器 f = mgr.__enter__() # 2. 进入,拿到工作对象 try: ... # 3. with 体 except BaseException as e: if not mgr.__exit__(type(e), e, e.__traceback__): raise # 4a. 异常路径:__exit__ 说"不处理"就继续抛 else: mgr.__exit__(None, None, None) # 4b. 正常路径
三个关键推论:__exit__ 在两条路径上都会被调用(资源安全的保证);__exit__ 返回真值可以吞掉异常(威力大、慎用);文件对象的 __exit__ 返回假值,只负责关闭。所以"with 自动关文件"不是魔法,是文件类型履约。
给自己的类实现上下文管理
任何"有开始、必须收尾"的资源——数据库连接、计时器、临时目录、锁——都可以接入这个协议:
import time class Timer: def __enter__(self): self.t0 = time.perf_counter() return self # as 后面拿到的就是返回值 def __exit__(self, exc_type, exc, tb): self.elapsed = time.perf_counter() - self.t0 return False # 不吞异常 with Timer() as t: total = sum(range(10_000_000)) print(f"耗时 {t.elapsed:.3f}s") # 耗时 0.28s 左右
更轻的写法是标准库装饰器,把"进入/退出"拆成两个函数——状态存哪儿?闭包或函数属性,第 3 章的知识再次复用:
from contextlib import contextmanager @contextmanager def timing(label): t0 = time.perf_counter() try: yield label # yield 之前 = 进入;之后 = 退出 finally: print(f"{label}: {time.perf_counter() - t0:.3f}s") with timing("排序"): sorted([3, 1, 2] * 100000)
注意这个生成器版用 try/finally 保证退出段执行——它其实就是第 7.1 节生成器暂停恢复机制的应用预演。
pathlib:路径也该是对象
老代码里的 os.path.join 链式调用可以退休了。pathlib 用运算符与方法表达路径操作:
from pathlib import Path root = Path("data") target = root / "2026" / "08" / "log.txt" target.parent.mkdir(parents=True, exist_ok=True) # 建目录,已存在不报错 target.write_text("hello", encoding="utf-8") # 小文件一步读写 for p in root.rglob("*.txt"): # 递归通配搜索 print(p, p.stat().st_size)
Path 对象把"路径"从字符串操作变成带方法的实体,拼接错误和平台分隔符问题同时消失。新项目没有理由再用字符串拼路径。
⚠️ 常见坑:文本模式读二进制文件抛
UnicodeDecodeError;"w" 模式一开文件先清空(想"写错了重来"前先想清楚);在遍历目录的同时修改目录内容;Windows 上文件被占用导致PermissionError——通常是自己在另一个程序里开着它。
💡 关键直觉:把 with 当成"资源生命周期的语法"。凡是获得时说"用完必须还"的东西——文件、连接、锁、事务——都该住在 with 里。
深挖:with 嵌套与资源释放时机
再补几个 with 的进阶细节。多个资源可以在一条 with 语句里逗号并排,也可以层层嵌套——两者语义等价,但并排写法在异常路径上有个细节:第二个资源的获取若抛异常,第一个资源的释放依然会被正确处理,而手写嵌套时这一点很容易漏。资源释放的时机也值得较真:with 体一结束就关闭,哪怕同一段代码后面还会用到文件内容——所以"读进内存再关"与"边读边处理"是两种真实不同的策略,前者适合需要随机访问的小文件,后者适合流式处理的大文件,选错要么浪费内存要么反复开关。还有一个与异常交织的点:如果 with 体内与 __exit__ 中都抛了异常,后者会以"处理前一个异常时又发生异常"的形式同时呈现两个——看见这种双异常栈,先查退出路径里的清理代码,而不是业务逻辑。这些细节平时无感,出事时都是凌晨两点的问题。
本节要点回顾
- 编码显式化:文本 IO 永远写 encoding="utf-8";二进制用 b 模式、单位是 bytes。
- 大文件逐行迭代:文件对象实现了迭代协议,内存恒定;定长块是二进制流标准姿势。
- write ≠ 落盘:用户缓冲 → 内核页缓存 → 磁盘的三级旅程,close 隐式 flush。
- with 是双向契约:
__enter__发资源、__exit__双路径必达、返回真可吞异常。 - 两种自实现:类协议版直观,contextmanager 装饰器版轻巧。
- pathlib 全面替代 os.path:路径运算符 / 递归搜索 / 一步读写。
下一节讲 with 的另一半背景——异常对象如何沿调用栈上抛、try/except 的语义细节与设计准则。