7.2 装饰器与闭包增强
7.2 装饰器与闭包增强
本节摘要:装饰器 = 用一个 callable 换掉一个名字。本节把这个定义逐步还原:先手工模拟 @ 语法,再讲 functools.wraps 的必要性、带参数装饰器的三层结构、类装饰器,最后盘点内置装饰器全家桶。读完框架源码里的 @ 花墙不再头晕。
把 @ 拆开:它只是一次改名
def log_calls(func): def wrapper(*args, **kwargs): result = func(*args, **kwargs) print(f"{func.__name__} 被调用") return result return wrapper @log_calls def ping(): return "pong"
@log_calls 与下面两行完全等价——装饰器没有任何新机制,就是函数调用加名字重绑定:
def ping(): ... ping = log_calls(ping) # 旧函数对象被 wrapper 顶替,原名易主
调用 ping() 时实际执行的是 wrapper;它闭包捕获了原始 func(第 3.2 节的闭包知识在此全部兑现)。验证身份易主:
>>> ping() pong ping 被调用 >>> ping.__name__ 'wrapper' # 名字已被顶替——引出下一个问题
wraps:给装饰器上户口
ping.__name__ 变成 wrapper、文档丢失、调试器与序列化工具认不出它——每个正经装饰器都该修复这一点,functools.wraps 就是干这个的:
import functools def log_calls(func): @functools.wraps(func) # 把元信息抄给 wrapper def wrapper(*args, **kwargs): result = func(*args, **kwargs) print(f"{func.__name__} 被调用") return result return wrapper >>> ping.__name__ 'ping' # 户口恢复正常
wraps 做的事是复制 __name__、__doc__、__module__、__wrapped__ 等元数据。它本身还是个"带参数的装饰器",正好是下一节内容的活例子。
带参数的装饰器:三层闭包
需求升级:日志要能指定级别。@log(level="warn") 带了括号,意味着"先调用 log(...),再用它的返回值当装饰器"——于是多出一层:
def log(level="info"): def decorator(func): # 第 2 层:真正的装饰器 @functools.wraps(func) def wrapper(*args, **kwargs): # 第 3 层:真正的替身 result = func(*args, **kwargs) print(f"[{level}] {func.__name__}") return result return wrapper return decorator @log(level="warn") def ping(): return "pong"
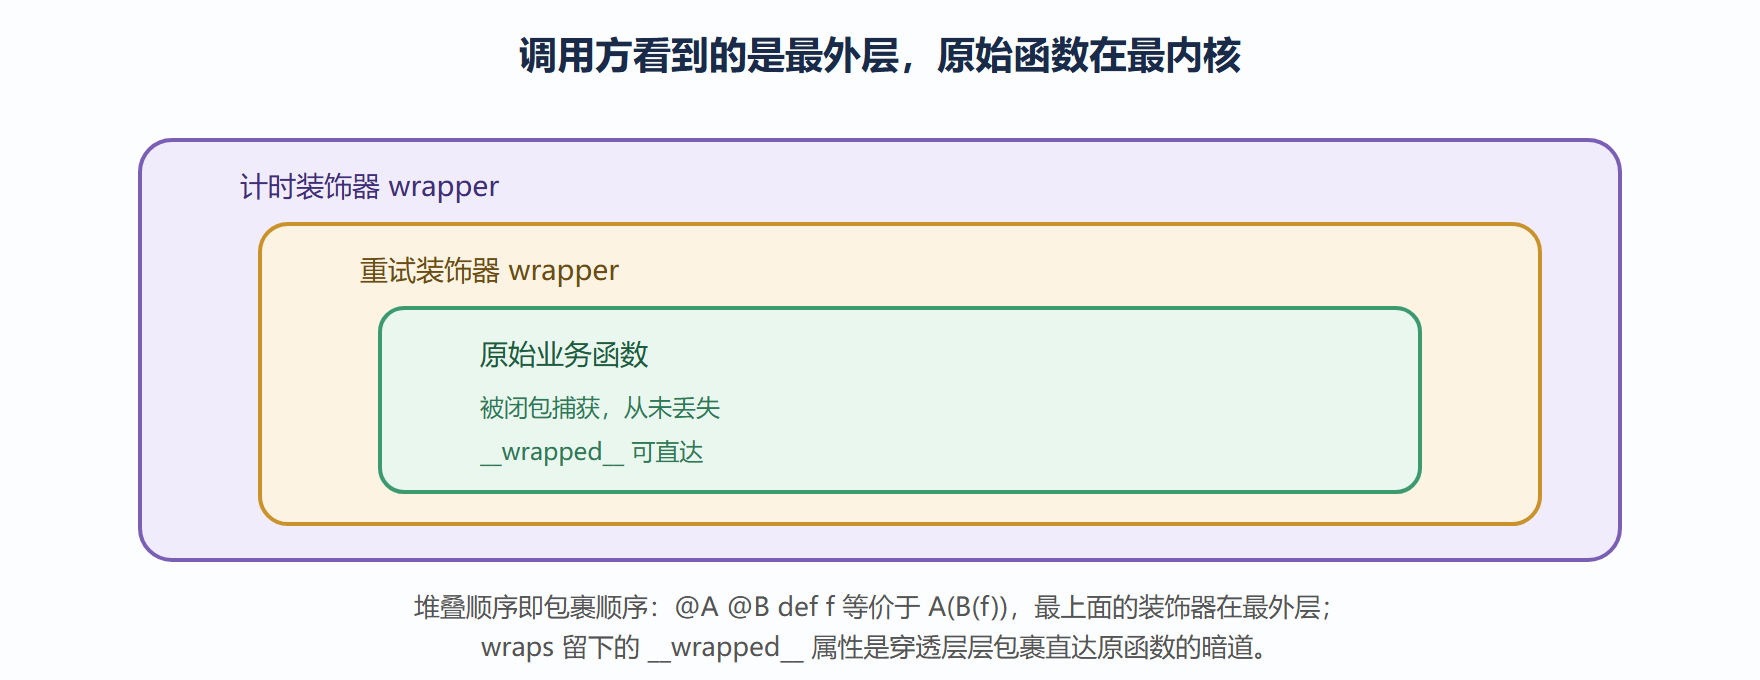
三层各有职责:最外层吃参数、中层吃函数、内层吃调用参数。分析陌生装饰器的技巧就是数括号:@x 两层,@x(a=1) 三层。实战一个重试装饰器,它还是第 6 章 EAFP 与异常分支的复合应用:
import functools, time def retry(times=3, delay=0.5, exceptions=(ConnectionError,)): def decorator(func): @functools.wraps(func) def wrapper(*args, **kwargs): for attempt in range(1, times + 1): try: return func(*args, **kwargs) except exceptions: if attempt == times: raise # 最后一次:原样上抛(6.2 节) time.sleep(delay * attempt) # 退避 return wrapper return decorator @retry(times=3) def fetch(): ...
装饰器的包裹结构
类装饰器与内置全家桶
类也能当装饰器(实现 __call__ 即可,4.2 节的插座),适合需要维护状态的场合:
class CountCalls: def __init__(self, func): functools.update_wrapper(self, func) # 类版 wraps self.func, self.count = func, 0 def __call__(self, *args, **kwargs): self.count += 1 return self.func(*args, **kwargs) @CountCalls def ping(): return "pong" ping(); ping() ping.count # 2
装饰器装饰类则常用于注册与打标签(框架路由的原理预告)。最后盘点必须认全的内置成员:
| 装饰器 | 用在 | 作用 |
|---|---|---|
functools.wraps |
wrapper | 抄送元信息 |
functools.lru_cache |
函数 | 结果缓存(正确性前提:纯函数、参数可哈希) |
functools.cache |
函数 | 无上限版缓存 |
staticmethod |
方法 | 去掉首参绑定 |
classmethod |
方法 | 首参绑定类,备选构造器的标配 |
property |
方法 | 属性化读写(4.1 节) |
dataclasses.dataclass |
类 | 样板代码生成器(4.1 节) |
lru_cache 值得现场验一次效果,它是最常用的"白嫖性能":
@functools.lru_cache(maxsize=None) def fib(n): return n if n < 2 else fib(n - 1) + fib(n - 2) fib(200) # 无缓存版本这个调用要到宇宙热寂
⚠️ 常见坑:忘写 wraps 导致文档与名字丢失;带参装饰器少写一层(
@log与@log()混用报'NoneType' is not callable);用 lru_cache 缓存返回可变对象的函数——缓存对象被调用方原地修改,下一次拿到的是脏值。
💡 关键直觉:读 @ 花墙时默念"最上最外、括号加层、内层真身"。框架的路由注册、依赖注入,拆到最底下都是本节这三层结构。
深挖:装饰器的执行时机与导入期副作用
一个容易被忽略的时间线问题:装饰器在导入期执行,也就是模块被第一次加载的时候,而不是每次调用的时候。这带来两个推论。其一,装饰器里在 wrapper 外面写的代码只跑一次——适合做注册(把函数登记进路由表)、校验签名、读取配置这类一次性动作;把每次调用都该做的判断误写在 wrapper 外面,是新手装饰器 bug 的常客(判断永远用导入期的旧数据)。其二,导入期副作用要克制——装饰器里发起网络请求、连数据库,会让模块的导入又慢又脆,别的模块只是想 import 你一个工具函数,却被迫等一次网络超时。原则:wrapper 外只做零成本的登记与包装,重活留给第一次调用(惰性初始化)或显式的启动函数。看懂这条时间线,回头看 Web 框架"路由表在服务启动前就建好了"的现象,会心一笑。
本节要点回顾
- @ 是改名语法:
f = deco(f),无新机制;wrapper 闭包持有原函数。 - wraps 必写:元信息与
__wrapped__暗道,调试器与序列化都靠它。 - 带参装饰器三层:参数层 → 函数层 → 调用层;数括号定层数。
- 类装饰器:
__call__插座 +update_wrapper,适合带状态的横切逻辑。 - 内置全家桶:lru_cache/cache/staticmethod/classmethod/property 各就各位。
- 堆叠即包裹:最上的装饰器在最外层。
下一节离开运行时机制,看类型注解如何在不改变任何行为的前提下,给动态类型的 Python 补上静态的安全网。