8.1 GIL:多线程与多进程
8.1 GIL:多线程与多进程
本节摘要:GIL(全局解释器锁)保证同一时刻只有一个线程执行 Python 字节码。它源于引用计数的线程安全需求,后果是:多线程救不了 CPU 密集任务,但对 IO 密集依然有效。本节用可复现实验证明这两件事,讲锁的用法与死锁,最后给出三种并发模型的对比矩阵。
GIL 为什么存在:从引用计数说起
第 1 章讲过,CPython 的对象生死由引用计数管理,sys.getrefcount 数过它。现在设想没有 GIL 的世界:两个线程同时执行 b = a——这行"无害"的赋值要对 a 指向的对象做"计数加一"。两个线程同时读到计数 5、各自加一、各自写回 6——本该是 7。计数少了,对象被提前回收,另一个线程拿到的指针指向已释放的内存,解释器崩溃。
给每个对象的计数单独加锁?数百万对象的锁开销不可接受,还极易死锁。CPython 的历史选择是一把全局大锁:任何线程要执行字节码,先拿 GIL。简单粗暴,但把并行变成了"交替串行"。
GIL 并非一锁到底。两类时机它会放手:
- 阻塞 IO 前后:线程进入网络/文件等待时释放 GIL,别的线程趁机干活——这就是多线程能加速 IO 的机制根源;
- 时间片轮转:默认约 5ms 强制切换一次(
sys.getswitchinterval()可查),保证没有线程饿死。
两个实验:亲眼看 GIL 的两副面孔
实验一:CPU 密集,多线程更慢。
import time, threading def burn(n): total = 0 for i in range(n): total += i * i N = 10_000_000 t0 = time.perf_counter(); burn(N); burn(N) serial = time.perf_counter() - t0 t0 = time.perf_counter() ts = [threading.Thread(target=burn, args=(N,)) for _ in range(2)] [t.start() for t in ts]; [t.join() for t in ts] parallel = time.perf_counter() - t0 print(f"串行 {serial:.2f}s / 双线程 {parallel:.2f}s") # 典型输出:串行 1.42s / 双线程 1.71s ← 更慢了!
双线程不但没快,还搭上了切换开销。机制解释:两份计算抢同一把 GIL,真正干活的时间加起来还是单核时间片的总和,切换与唤醒反而添乱。
实验二:IO 密集,多线程几乎线性加速。
import time, threading, urllib.request def fetch(url): with urllib.request.urlopen(url, timeout=5) as r: return len(r.read()) urls = ["https://example.com"] * 8 t0 = time.perf_counter() for u in urls: fetch(u) serial = time.perf_counter() - t0 t0 = time.perf_counter() ts = [threading.Thread(target=fetch, args=(u,)) for u in urls] [t.start() for t in ts]; [t.join() for t in ts] parallel = time.perf_counter() - t0 print(f"串行 {serial:.2f}s / 8线程 {parallel:.2f}s") # 典型输出:串行 3.1s / 8线程 0.5s ← 等网络时 GIL 释放,众人接力
两个实验合起来就是 GIL 的完整画像:它限制 CPU 并行,不限制 IO 并发。
multiprocessing:每个进程一把自己的锁
绕开 GIL 的直接办法是多个进程——各自有独立解释器、独立内存、独立的 GIL,操作系统真正并行调度到多个核心:
from concurrent.futures import ProcessPoolExecutor import time def burn(n): return sum(i * i for i in range(n)) if __name__ == "__main__": # Windows 上必须守住这个入口(5.1 节) N = 10_000_000 t0 = time.perf_counter() with ProcessPoolExecutor() as pool: results = list(pool.map(burn, [N, N, N, N])) print(f"4 进程耗时 {time.perf_counter() - t0:.2f}s")
同一计算从单线程 4 倍时长降到约 1 倍时长——真并行的回报。但天下没有免费的午餐:
- 启动与通信开销:进程创建毫秒级起步;参数与返回值要跨进程序列化(pickle 往返),传大对象比算还慢;
- 内存独立是双刃剑:不会互相踩,但也无法直接共享变量,得靠队列、共享内存或管道;
- 数据必须可 pickle:lambda 与本地函数不能当任务直接提交。
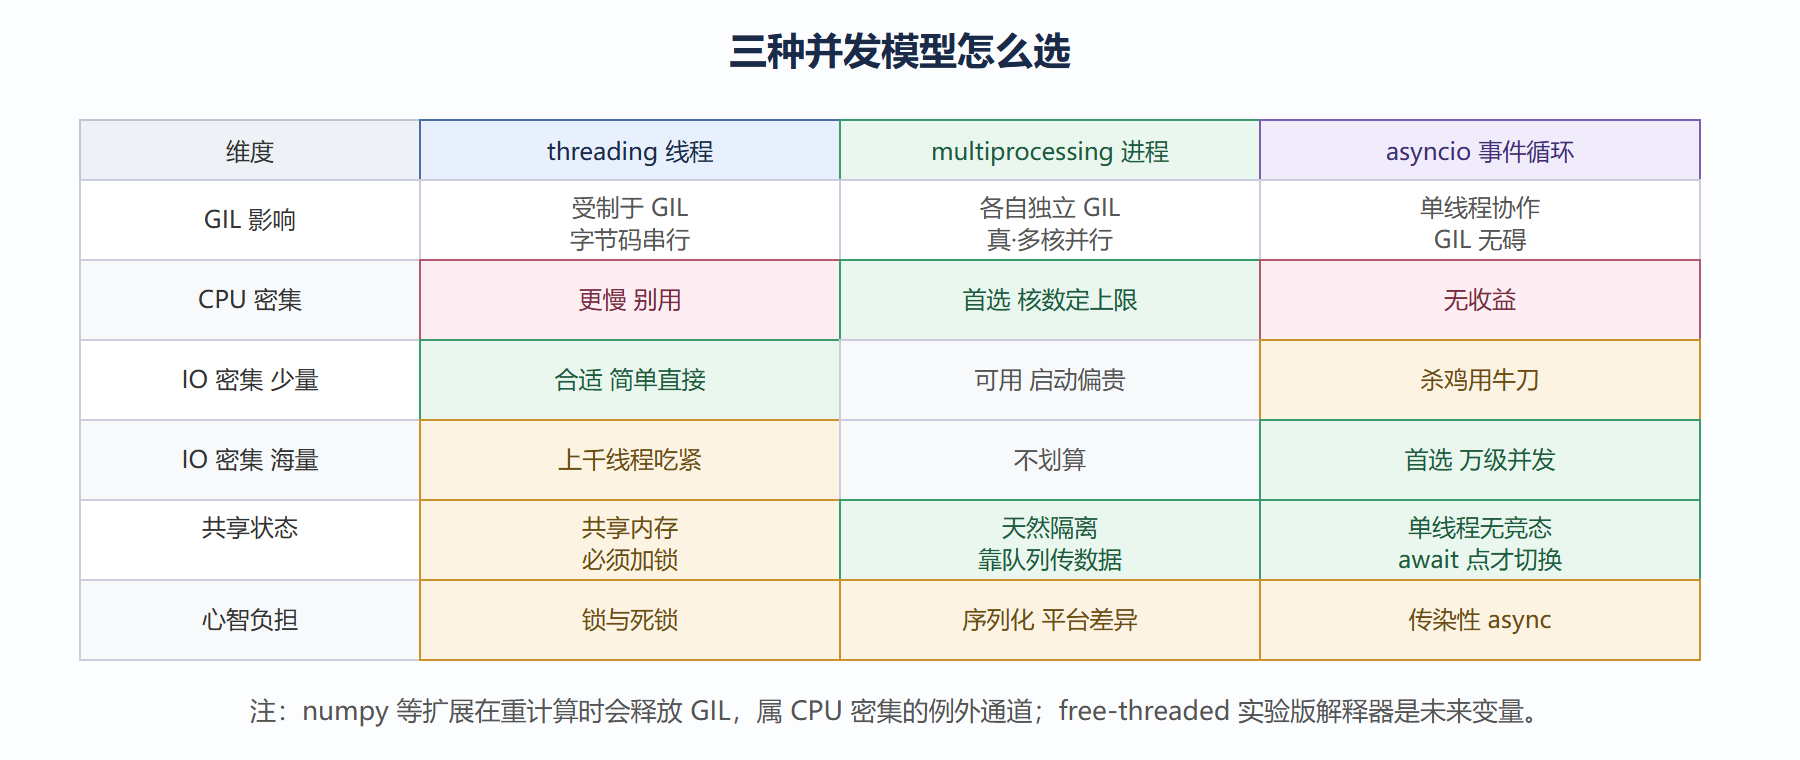
三种并发模型对比矩阵
竞态与锁:共享状态的代价
多线程共享内存(进程内的全局对象、闭包变量),IO 释放 GIL 的窗口正好制造竞态。最小复现:
import threading counter = 0 def bump(): global counter for _ in range(100_000): counter += 1 # 读-改-写三步,随时被插队 ts = [threading.Thread(target=bump) for _ in range(4)] [t.start() for t in ts]; [t.join() for t in ts] print(counter) # 期望 400000,典型输出 213847 —— 丢更新!
counter += 1 不是原子的:字节码层面是"取值、加一、存回"三步,GIL 可能在任意两步之间切换线程。修复用锁把三步焊成一个临界区:
lock = threading.Lock() def bump(): global counter for _ in range(100_000): with lock: # with 语法:拿锁-干活-放锁,异常也放(6.1 节协议) counter += 1
实战里我更推荐绕开而非硬扛:用 queue.Queue(自带锁的线程安全队列)做生产者-消费者交接,让线程之间传消息而不是改同一份状态;或把计数交给 itertools.count/数据库原子更新这类已经线程安全的设施。锁用对了是工具,用滥了是死锁温床——两把锁以相反顺序获取就会互相等死,发生率与锁数量正相关。
⚠️ 常见坑:Windows 下 multiprocessing 不守
__main__入口直接无限弹进程;把大 DataFrame 往进程池里传(序列化开销吞掉并行收益);以为 GIL 让锁变得多余(竞态实验反例);在多进程里用全局变量传结果(各自的副本互不可见)。
💡 关键直觉:拿到并发需求先跑本章两个实验的变体——测一下"纯等"与"纯算"的时间占比。IO 占九成就线程/异步,CPU 占九成就进程池,混合任务拆开分治。
本节要点回顾
- GIL 的因果:引用计数的线程安全 → 一把全局锁 → 字节码级串行。
- 两副面孔:阻塞 IO 与时间片会释放 GIL——IO 并发有效、CPU 并行无效。
- 多进程真并行:代价是启动、序列化与内存隔离;
__main__入口必须守。 - 竞态根源:
+=非原子;修复用锁,更好的方案是队列传消息。 - 选型矩阵:CPU 密集→进程池;IO 少量→线程;IO 海量→asyncio(下一节)。
- 例外通道:numpy 等重计算扩展主动放锁,纯 Python 循环才是 GIL 的重灾区。
下一节讲 asyncio:单线程怎么做到万级并发,以及 async/await 这门"传染性"语法的正确打开方式。