9.1 数据分析与科学计算
9.1 数据分析与科学计算
本节摘要:数据栈的地基是 NumPy——同类型连续内存数组加向量化运算,把 Python 循环换底成 C 级速度;Pandas 在其上提供带标签的表格能力。本节讲向量化思维的建立、视图与拷贝的别名问题(第 1 章主题的回归)、Pandas 清洗分析三件套,并用一张图看清数据栈分层。
从一个对比开始:快 100 倍的加法
同样是两个数组的元素级相加,纯 Python 与 NumPy:
>>> import numpy as np >>> a = list(range(1_000_000)); b = list(range(1_000_000)) >>> arr_a = np.array(a); arr_b = np.array(b) >>> timeit -n 3 >>> # 纯 Python 列表推导 >>> %timeit [x + y for x, y in zip(a, b)] 78 ms >>> # NumPy 向量化 >>> %timeit arr_a + arr_b 1.1 ms
快 70 倍。原因用全书的视角一眼看穿:list 是"指针数组"(2.1 节),每个元素是独立 PyObject,x + y 每步都要类型检查、拆箱、装箱;NumPy 数组是一块连续的、无对象头的同类型内存,arr_a + arr_b 整段交给编译好的 C 循环一次跑完——这就是向量化:把"逐元素做什么"翻译成"整段做什么"。
还有个隐藏红利连接第 8 章:NumPy 的重计算会主动释放 GIL,多线程跑在 NumPy 上是真并行——8.1 节矩阵里"CPU 密集别用多线程"的例外通道就是它。
视图与拷贝:别名问题在数组上的回归
NumPy 切片默认返回视图——不复制数据,只是同一块内存的另一个观察窗。第 1.3 节的别名问题原样回归,还更隐蔽:
>>> mat = np.arange(12).reshape(3, 4) >>> row0 = mat[0] # 视图!不是拷贝 >>> row0[0] = 999 >>> mat array([[999, 1, 2, 3], [ 4, 5, 6, 7], [ 8, 9, 10, 11]]) # 原数组被改了 >>> copy0 = mat[0].copy() # 显式拷贝才隔离 >>> copy0[0] = -1 >>> mat[0, 0] # 999,纹丝不动
判定规则:基本切片是视图,花式索引(列表/布尔数组下标)是拷贝。数据科学代码里"改了 A 却发现 B 也变了"的疑难杂症,九成是视图。Pandas 的一条核心告警 SettingWithCopyWarning 也是同一颗种子——链式索引到底落在视图还是拷贝上,解释器都未必确定,索性警告你写明确。
Pandas:带标签的表格
Pandas 的两大容器对应两类数据:一维 Series(带索引的序列)、二维 DataFrame(行列双索引的表格)。分析工作永远的三段式——读入、清洗、聚合:
import pandas as pd df = pd.read_csv("orders.csv", parse_dates=["created_at"]) # 读入 # 清洗:空值、类型、派生列(链式风格) clean = ( df.dropna(subset=["amount"]) .assign(amount=df["amount"].fillna(0), month=lambda d: d["created_at"].dt.to_period("M")) .query("amount > 0") ) # 聚合:分组汇总——数据栈的"透视"动作 report = (clean.groupby(["month", "channel"]) .agg(订单数=("amount", "count"), 总额=("amount", "sum"), 均价=("amount", "mean")) .round(2))
groupby-agg 是把 2.2 节 dict 分组直觉规模化:按键切桶、桶内各算各的、结果拼回表格。assign 与 query 让清洗以管道链式书写,与 7.1 节生成器管道是同一种"数据流思维",只是块更大、引擎更快。
数据栈分层地图
生态地图:数据科学栈分层
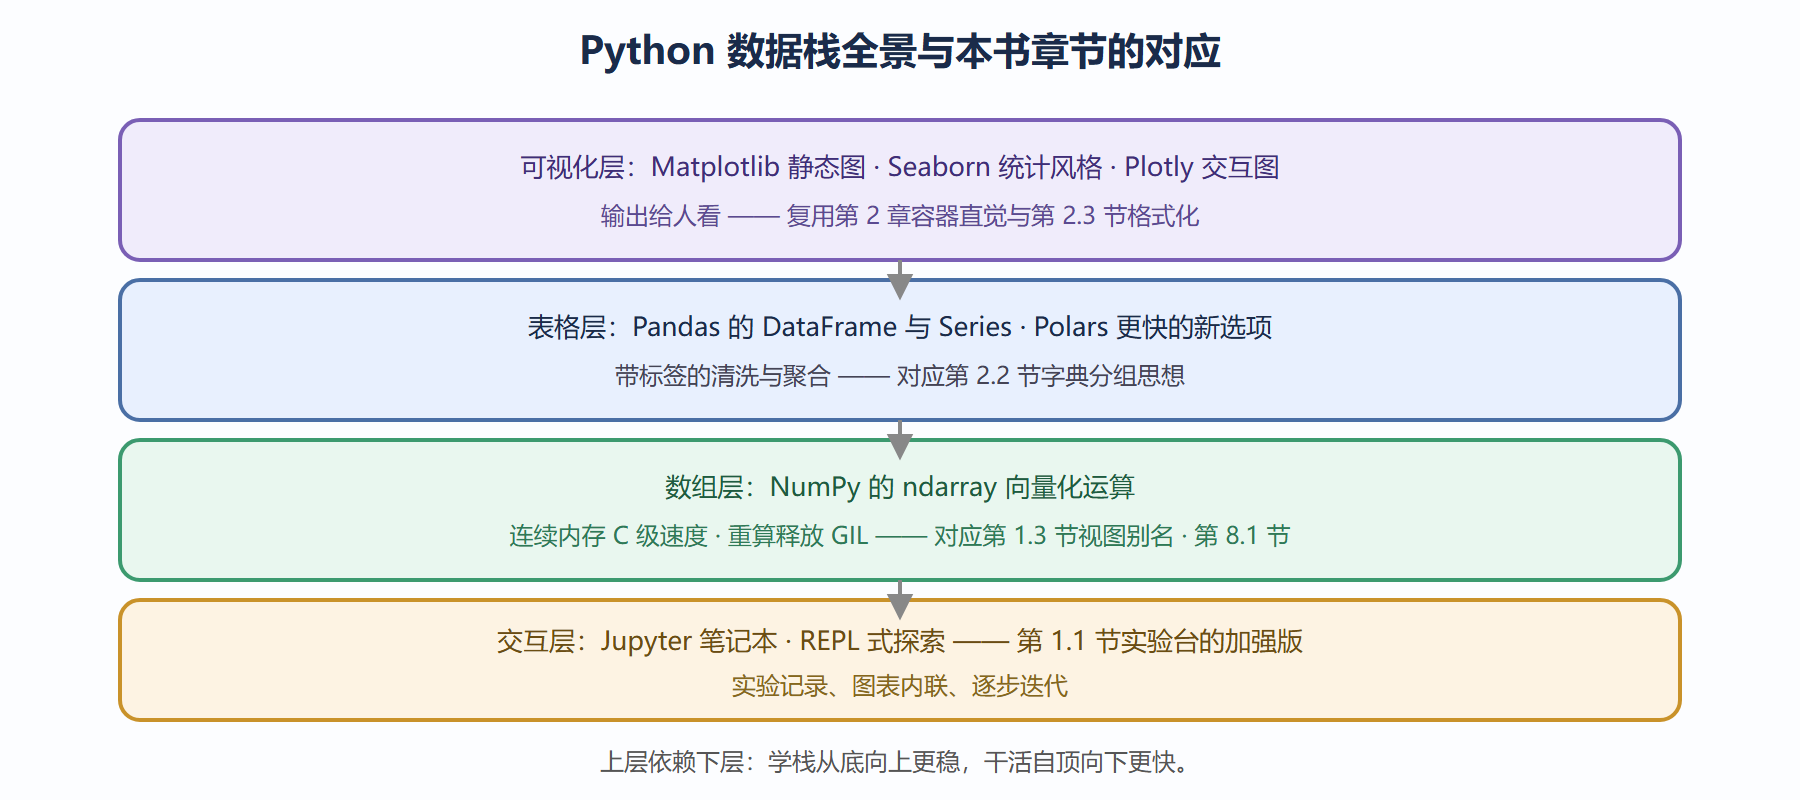
工具选型的经验:探索分析用 Jupyter + Pandas 足够;数据量大到 Pandas 吃力(内存爆、单核慢),再考虑 Polars(多线程、惰性 API 与 7.1 节生成器思想同构)或直接下沉到 NumPy/数据库。可视化日常 Matplotlib 打底、汇报用 Seaborn 一行变好看、需要网页交互再上 Plotly——按受众选,不按流行度选。
⚠️ 常见坑:
SettingWithCopyWarning被无视,改了半天改在拷贝上、原表没变;df["col"] == None得不到想要的结果(Pandas 里判空用isna);groupby 后忘了聚合操作就遍历;在 DataFrame 上写 Python 逐行循环——能用向量化/apply 的别用 for。
💡 关键直觉:数据分析的提速心法一句话——"别让解释器进循环"。逐元素逻辑想办法翻译成数组级表达式,交给底层的 C 去 loop。
深挖:广播——形状不同的数组怎么运算
向量化还有一个必考知识点:广播。两个形状不同的数组相加时,NumPy 不报错,而是按规则自动"拉伸"维度较小的那个:从尾部对齐比较,某维为 1(或缺失)就沿该维复制到与对方一致。典型如矩阵减去每行的均值——均值是长度为列数的一维数组,广播把它当成每行都减同一组数,一行代码完成整个操作,无需任何循环。可广播与不可广播的边界要记牢:要么维度相等,要么一方为 1,否则直接抛异常(错误信息里会写出两个形状,读一眼就知道哪一维对不上)。工程上广播带来的最大陷阱是意外的形状匹配——本该报错暴露 bug 的地方,恰好能广播出一个形状不对的结果,顺着算下去错到很远。防御办法是把关键数组的形状断言写进代码(shape 属性比较),让错误在发生点爆炸而不是在下游爆炸。
本节要点回顾
- 向量化:同类型连续内存 + 整段 C 运算,比解释器循环快一两个数量级。
- 视图与拷贝:基本切片是视图,花式索引是拷贝——第 1 章别名问题在数组上的重现。
- Pandas 三段式:读入(read_csv)→ 清洗(dropna/assign/query 链)→ 聚合(groupby-agg)。
- 分层地图:可视化 / 表格 / 数组 / 交互四层,上层依赖下层。
- NumPy 释放 GIL:多线程跑重计算的真并行通道。
- 选型按受众:Jupyter 探索、Matplotlib 打底、数据量撑爆再换 Polars。
下一节进入 Web 开发:HTTP 服务的最小模型,以及 Flask 与 FastAPI 这两代框架的取舍。