2.3 多项式拟合基线校正
2.3 多项式拟合基线校正
本节摘要:基线是叠在谱峰之下的缓变背景,多项式拟合是最直观的拆除手法——在无峰区域挑点、拟合低阶多项式、整条减掉。窗口怎么挑、阶数怎么定,决定你是拆掉了背景还是咬掉了峰。本节用一整份模拟档案做四档阶数的对照实验。
噪声压下去了,档案上那条斜坡还在。这条斜坡在拉曼谱里常来自荧光背景,在近红外漫反射里来自颗粒散射,在紫外-可见里来自浑浊散射——第 1 章五段链路的"样品接口"段欠下的债,本节开始偿还。手工多项式是基线校正的第一课,它的逻辑直觉到近乎朴素:背景是缓变的,峰是陡变的,只拿"缓变区"的数据去拟合背景,再把背景整条减掉。
一、先看清对手长什么样
构造一份典型档案:一条二次型缓变背景叠加一个宽包(模拟荧光隆起),上面立三个峰:
# 模拟档案:缓变基线 + 三峰 + 噪声 import numpy as np rng = np.random.default_rng(21) x = np.linspace(0, 100, 400) true_bl = 0.30 + 0.006*x - 6.0e-5*x**2 + 0.25*np.exp(-0.5*((x-88)/25)**2) peaks = (1.0*np.exp(-0.5*((x-30)/2.5)**2) + 0.6*np.exp(-0.5*((x-52)/3.0)**2) + 0.35*np.exp(-0.5*((x-70)/2.0)**2)) y = true_bl + peaks + rng.normal(0, 0.01, x.size) def rmse(a, b): return float(np.sqrt(np.mean((a-b)**2))) m_pk1 = (x >= 25) & (x <= 35) # 峰1 邻域(检验峰高恢复) m_val = (x >= 40) & (x <= 47) # 两峰间的谷(检验有没有扣过头) print("truth peak1 height =", round(peaks[m_pk1].max(), 3))
输出:
truth peak1 height = 1.0
真值峰高 1.0,基线真值也在手上——这让它成为一块难得的"标定试金石":任何校正方法的成与败,都能和真值当场对账。真实数据没有真值,所以先用模拟档案建立手感,再上真实档案,是整备车间的训练路径。
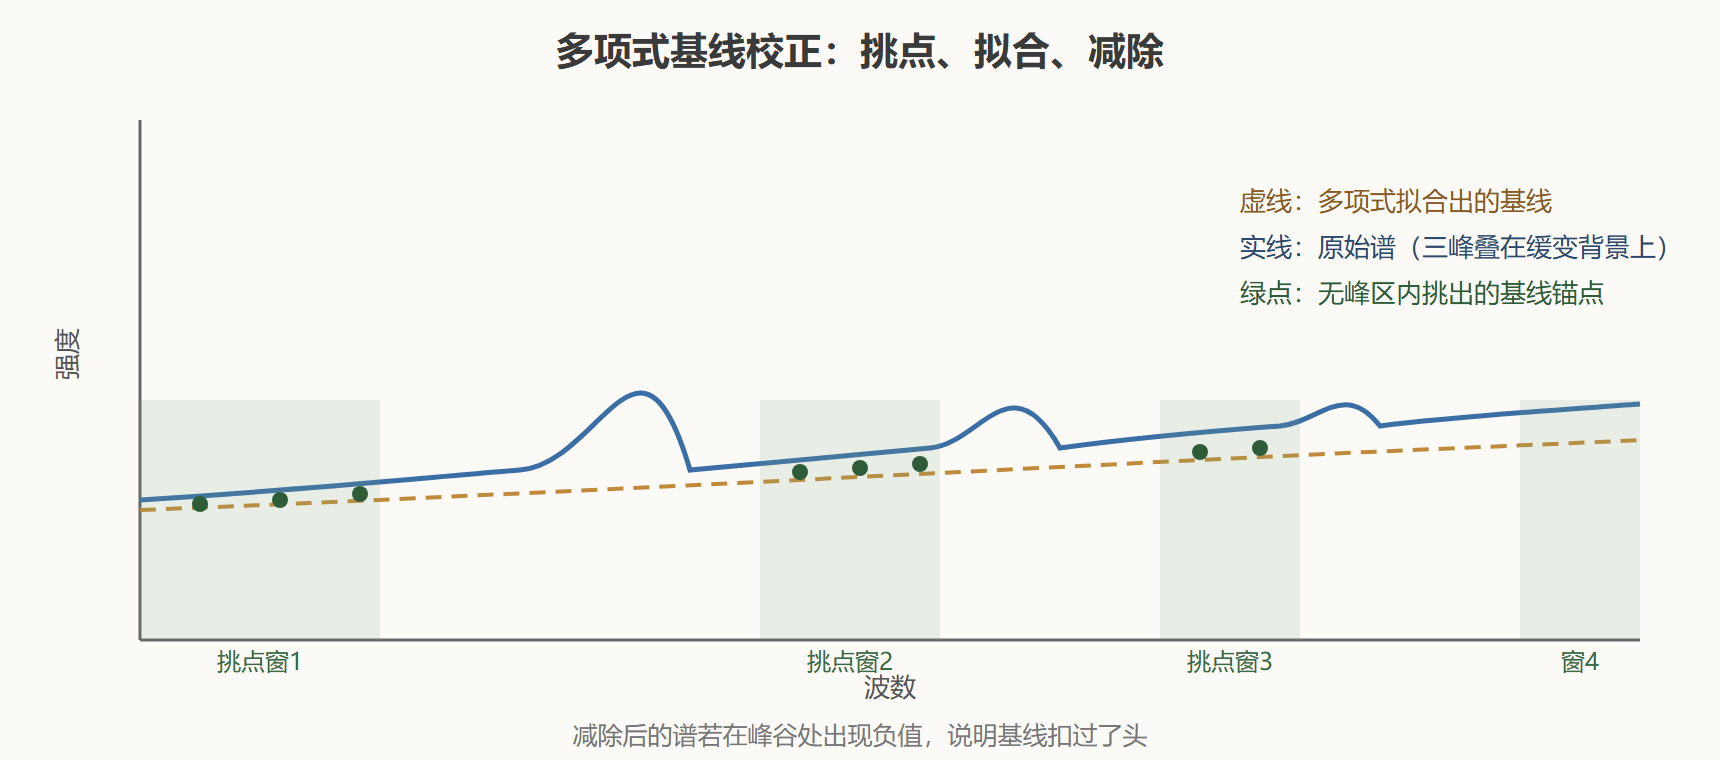
图2 基线校正的解剖图
二、四档阶数的对照实验
在无峰区(峰前、峰间、峰后共五段窗口)挑出锚点,分别用 1、2、3、5 次多项式拟合基线并减除:
# 无峰区挑点,四档阶数对照 mask = np.zeros_like(x, bool) for lo, hi in [(0,20), (40,47), (60,65), (78,82), (95,100)]: mask |= (x >= lo) & (x <= hi) # 只在这些窗口里取锚点 print("baseline anchor points:", mask.sum()) for deg in [1, 2, 3, 5]: coef = np.polyfit(x[mask], y[mask], deg) # 锚点上拟合多项式 bl_hat = np.polyval(coef, x) # 全谱求值 print(f"poly{deg}: bl_RMSE={rmse(bl_hat, true_bl):.4f} " f"rec_peak1={(y-bl_hat)[m_pk1].max():.3f} valley={(y-bl_hat)[m_val].min():.4f}")
输出:
baseline anchor points: 164 poly1: bl_RMSE=0.0408 rec_peak1=1.008 valley=0.0110 poly2: bl_RMSE=0.0282 rec_peak1=0.960 valley=-0.0511 poly3: bl_RMSE=0.0164 rec_peak1=0.986 valley=-0.0355 poly5: bl_RMSE=0.0135 rec_peak1=0.982 valley=-0.0337
这张四行小表浓缩了手工基线的全部取舍。线性(poly1)最保守:基线残差 0.0408 最大,但峰高恢复 1.008 最准、峰谷还是正的——它宁可漏扣也不咬峰。二次(poly2)反而咬峰:基线拟合变好了(0.0282),峰高却掉到 0.960、谷底被扣到负 0.05——抛物线在峰区附近上翘,把峰"脚"削掉了一块。三次和五次继续改善基线(0.0164、0.0135),峰高稳定在 0.98 附近,但谷底的负值提示:阶数越高,多项式越想讨好锚点之间的峰区,五次已经有一点点爬峰的苗头。
经验法则由此而来:基线平缓用 1 到 2 次,有单侧隆起用 3 到 5 次,超过 6 次基本必咬峰。另一个同样重要的旋钮是锚点质量——把窗口画宽一点、让锚点蹭到峰脚,拟合立刻恶化;反过来在峰密区硬要找窗,不如改用下一节的自动方法。
三、迭代多项式:让算法自己扔掉峰点
手工挑点的痛点是"峰密区找不到窗"。迭代多项式(IModPoly 一族的思路)给了一个聪明的解法:先用全部点拟合,然后把明显高于拟合线的点判定为峰点扔掉,用剩下的点重新拟合,反复几轮,留下的自然都是背景点。伪代码只有四行:
# 迭代多项式基线(示意) pts = np.ones_like(x, bool) # 初始:全体参与 for _ in range(8): # 迭代轮数 coef = np.polyfit(x[pts], y[pts], deg) # 当前点集上拟合 resid = y - np.polyval(coef, x) dev = resid[pts].std() # 参与点的残差散布 pts = resid < 2.0 * dev # 比拟合线高两个标准差的点出局 baseline = np.polyval(coef, x)
这段代码没有魔法常数需要背:2.0 倍标准差是常用的出局门槛,轮数 8 轮足够收敛。它把"哪里是峰"的判断交给了残差统计,把"背景是什么形状"仍然留给人选的阶数——一半手工一半自动,正好是 2.3 与 2.4 两节之间的过渡形态。
⚠️ 常见坑:拉曼谱的荧光背景常呈指数式陡降,直接拿多项式硬拟合需要很高的阶数,而高阶必咬峰。此时先做对数变换(强度取对数后背景近似线性),拟合完再变换回来,低阶就能搞定。
本节要点回顾
- 缓变与陡变是分界线:背景缓、峰陡,锚点只从缓变区取;
- 阶数是敏感旋钮:实验里二次基线最好却咬掉峰高 4%,三次是平衡点;超过 6 次慎用;
- 锚点质量不亚于阶数:窗口画宽蹭到峰脚,拟合立刻恶化;
- 迭代多项式解放挑点:残差超出两倍标准差的点自动出局,峰密区的救命稻草;
- 指数背景先取对数:变换域里低阶多项式就够。
手工与半自动的方法对付几十条谱还行,几百条的批处理里逐条挑点不现实。下一节的 ALS 把"哪里是峰"的判断也交给算法,只剩两个超参数留给人。