3.3 定量校正模型
3.3 定量校正模型
本节摘要:定量分析回答"有多少"。单波长校准曲线是物理直觉,但真实光谱四百个波长高度共线、变量远多于样本,普通多元回归无解——PCR 用主成分换稳定,PLS 用与浓度的协方差换精度。本节用一套模拟近红外数据把三种模型从头跑通,变量选择的思路一并交代。
比对回答了"是谁",定量接着问"有多少"。做法听起来耳熟:配一组浓度已知的标样,测谱、建模,再对未知样预测。麻烦在数据形状——光谱矩阵是四十行(样本)乘两百列(波长),变量比样本多五倍,而且相邻波长你抄我我抄你(相关系数普遍 0.99)。这个"多变量、高共线"的困局是化学计量学的出生证明,本节三种方法就是三代解法。
一、三代模型的家谱
图2 多元校正三代模型与它们化解的困局
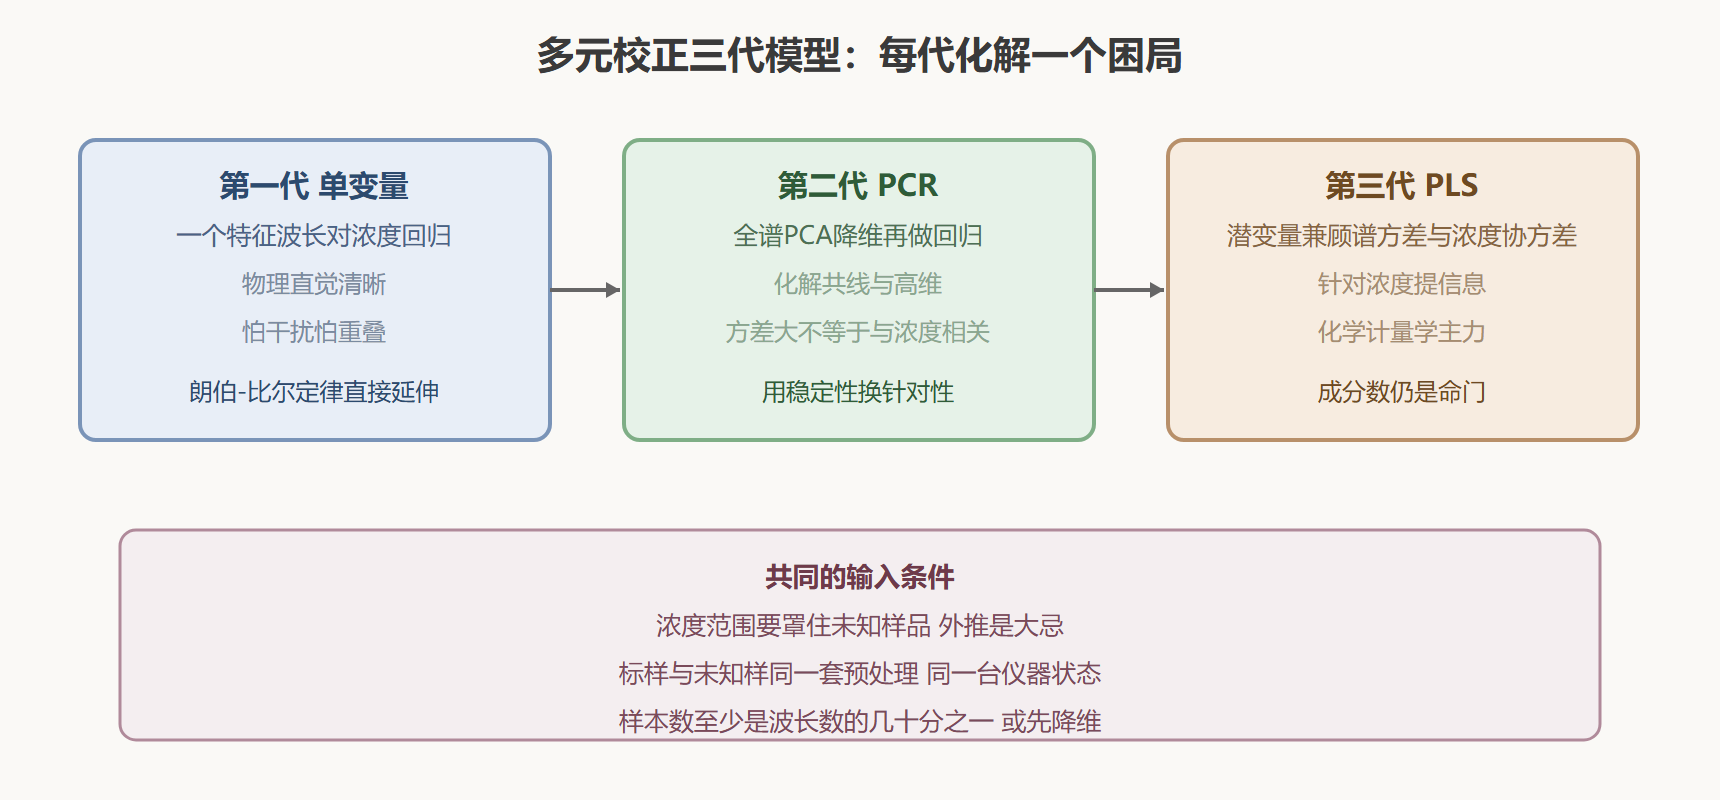
普通最小二乘插不进这张家谱的原因一句话讲完:两百个变量、四十个样本,方程组欠定,且高度共线让系数方差爆炸——回归系数今天算出来是正三百、明天换两个样本就变负两百。降维是唯一出路,分歧只在"往哪个方向降"。
二、三代同台:一套模拟数据跑到底
模拟近红外场景:两百个波长点,待测组分在 1180 有特征带,另有一个不受控的干扰物在 1210 出带,四十个校正样本、十五个测试样本,浓度与干扰都随机:
# 三代模型同台:单变量 / PCR / PLS import numpy as np rng = np.random.default_rng(42) p = 200 x = np.linspace(1100, 1250, p) s_ana = 0.8*np.exp(-0.5*((x-1180)/12)**2) # 待测组分特征带 s_int = 0.5*np.exp(-0.5*((x-1210)/20)**2) # 不受控的干扰带 def make_set(n): c = rng.uniform(0, 10, n) # 待测浓度 ci = rng.uniform(2, 6, n) # 干扰物浓度 X = np.array([c[i]*s_ana + ci[i]*s_int + rng.normal(0, 0.02, p) for i in range(n)]) return c, X c_cal, X_cal = make_set(40) c_test, X_test = make_set(15) def rmse(a, b): return float(np.sqrt(np.mean((a-b)**2))) # 单变量:1180 处峰高回归 h = X_cal[:, np.argmin(np.abs(x-1180))] k, b0 = np.polyfit(h, c_cal, 1) h_t = X_test[:, np.argmin(np.abs(x-1180))] print(f"univariate: RMSEP={rmse(np.polyval([k, b0], h_t), c_test):.3f}")
输出:
univariate: RMSEP=0.235
单变量在浓度范围 0 到 10 上误差 0.235,看起来不错——但注意它的误差来源:1180 处的峰高里掺着干扰带 1210 的裙边贡献,这部分与待测浓度无关,纯属系统噪声。真实样品里干扰往往不止一个,裙边叠裙边,单变量的误差就是这么一点点攒大的。
接着是 PCR 与 PLS 的完整实现(PLS 用 NIPALS 算法逐潜变量提取,十几行就能写完):
# PCR:SVD 降维 + 回归;PLS:NIPALS 提潜变量 def pcr_fit(X, y, ncomp): mu, my = X.mean(axis=0), y.mean() U, S, Vt = np.linalg.svd(X - mu, full_matrices=False) T = U[:, :ncomp] * S[:ncomp] # 主成分得分 bt = np.linalg.lstsq(T, y - my, rcond=None)[0] return mu, my, Vt[:ncomp], bt def pcr_pred(m, X): mu, my, V, bt = m return my + (X - mu) @ V.T @ bt def pls_fit(X, y, ncomp): mu, my = X.mean(axis=0), y.mean() Xc, yc = X - mu, y - my Wl, Pl, Ql = [], [], [] for _ in range(ncomp): w = Xc.T @ yc; w /= np.linalg.norm(w) # 与浓度最相关的方向 t = Xc @ w # 潜变量得分 pl = Xc.T @ t / (t @ t) q = yc @ t / (t @ t) Xc -= np.outer(t, pl); yc -= q*t # 残差进下一轮 Wl.append(w); Pl.append(pl); Ql.append(q) W, P, Q = np.array(Wl).T, np.array(Pl).T, np.array(Ql) return mu, my, W, P, Q def pls_pred(m, X): mu, my, W, P, Q = m return my + (X - mu) @ W @ np.linalg.inv(P.T @ W) @ Q for kk in [1, 2, 3]: m = pcr_fit(X_cal, c_cal, kk) print(f"PCR k={kk}: RMSEP={rmse(pcr_pred(m, X_test), c_test):.3f}") for kk in [1, 2]: m = pls_fit(X_cal, c_cal, kk) print(f"PLS k={kk}: RMSEP={rmse(pls_pred(m, X_test), c_test):.3f}")
输出:
PCR k=1: RMSEP=0.406 PCR k=2: RMSEP=0.006 PCR k=3: RMSEP=0.006 PLS k=1: RMSEP=0.378 PLS k=2: RMSEP=0.006
这张小表值得逐行读。k=1 时两家都不行(0.406 与 0.378):只留一个成分,模型把待测带与干扰带搅在一起,分不清谁贡献的吸收。k=2 时两家同时通杀(0.006,接近噪声极限 0.02 除以峰高斜率):第二个成分恰好把干扰方向补上——数据里只有两个化学物种,两个潜变量刚好讲完整个故事。**k=3 与 k=2 持平**:第三个成分无事可讲,只分到一点噪声。这组数字印证了化学计量学的一条经验律:**最优成分数常等于体系里的化学物种数**,从化学出发猜成分数,再用下一节的交叉验证核实,比盲扫参数快得多。
PCR 与 PLS 的差异在 k=1 那行露了一手(PLS 0.378 略优于 PCR 0.406):PCR 的第一主成分只讨好光谱方差,不管它与浓度的关系;PLS 的每个潜变量都朝着"与浓度协方差最大"的方向找。体系越复杂(干扰越多、信息越藏),这个差距越大——这也是 PLS 成为绝对主力的原因。
三、变量选择:给模型减负的另一条路
全谱建模把两百个波长都喂给模型,其实一半以上是冗余甚至拖累。变量选择从反方向入手:只留对浓度真正有贡献的波长。三类常用打法——相关系数排序(每个波长与浓度算相关,留头部),简单但会被共线骗(一整段都相关,留哪个都行也都不行);回归系数与 VIP 分数(模型建完看每个变量的贡献分),有模型背书;无信息变量消除与竞争性自适应重加权(反复随机扰动、按保留频率筛),计算重但更彻底。选择的标准只有一条:测试集或交叉验证误差降没降。留五个精选波长、误差不变,那五个波长就是更好的模型——简、可解释、仪器可以做窄波段低成本版。第 5 章食用油案例会实际用相关系数法挑波长。
⚠️ 常见坑:拿 PLS 回归系数的绝对值当"哪个波长重要"的铁证。潜变量是两百个波长的线性组合,系数相互牵制;解读变量重要性用 VIP 分数或回归系数的稳定性(多次重采样的符号一致性),别看单次系数大小。
本节要点回顾
- 高维高共线是多元校正的出生问题,普通回归无解,降维是共同出路;
- PCR 按方差降维,PLS 按协方差降维,后者针对浓度提信息,复杂体系优势明显;
- 最优成分数常等于化学物种数(实验里 k=2 同时通杀),从化学出发猜、交叉验证核实;
- 单变量误差来自干扰裙边,多元模型把它分摊进额外潜变量;
- 变量选择的唯一裁判是预测误差,波段越窄成本越低。
模型建好了,但 0.006 的 RMSEP 是测试集给的——真实流程里测试集金贵,日常靠交叉验证过日子。下一节把误差的会计学补全:RMSEC、RMSECV、RMSEP 三本账各记什么,杠杆值与残差怎么把问题样本揪出来。