4.4 HTML 验证
4.4 HTML 验证
本节摘要:验证是用标准条文比对你的标记、找出偏离的过程。本节讲验证器检查什么、错误与警告怎么分级解读、哪些"错误"其实无伤大雅而哪些警告藏着真雷、验证如何接进持续集成,以及它与第 4.1 节规范的关系——规范是团队的约定,验证是标准的合约。
学习目标
阅读完本节,你应当能够:
- 说明验证器的工作原理与检查范围;
- 区分错误与警告,按"是否影响语义或行为"排修复优先级;
- 识别三类必须修的错误与三类可以先放的警告;
- 把验证接入提交流程,让它成为质量门禁;
- 解释验证、规范、可访问性三者的分工。
验证器是什么
HTML 验证器(以 W3C 的官方校验服务为代表)做的事很朴素:拿标准条文逐条比对你的文档。它检查四个层面——语法层(标签闭合、属性合法、元素嵌套符合内容模型)、必备项(DOCTYPE 声明、字符编码声明、title)、唯一性约束(id 不得重复)、弃用项(已废弃的元素与属性)。输入是一份 HTML,输出是一份错误与警告清单。
使用成本极低:官方校验服务贴网址或上传文件即得报告;主流编辑器也有内置或插件式的实时校验,写错当场标红。工程里验证器扮演的角色是"机器评审员":人评审会累、会有盲区、标准条文没人背得全,验证器不知疲倦且条文一条不落。第 1 章讲过浏览器解析的容错性——标签没闭合页面照样显示,这正是验证存在的理由:浏览器替你兜底渲染,没人替你兜底语义,而语义的坑(第 2 章讲过谁在消费语义)在渲染层完全看不见。
报告解读:错误与警告的分级
验证报告分两级,解读各有心法。
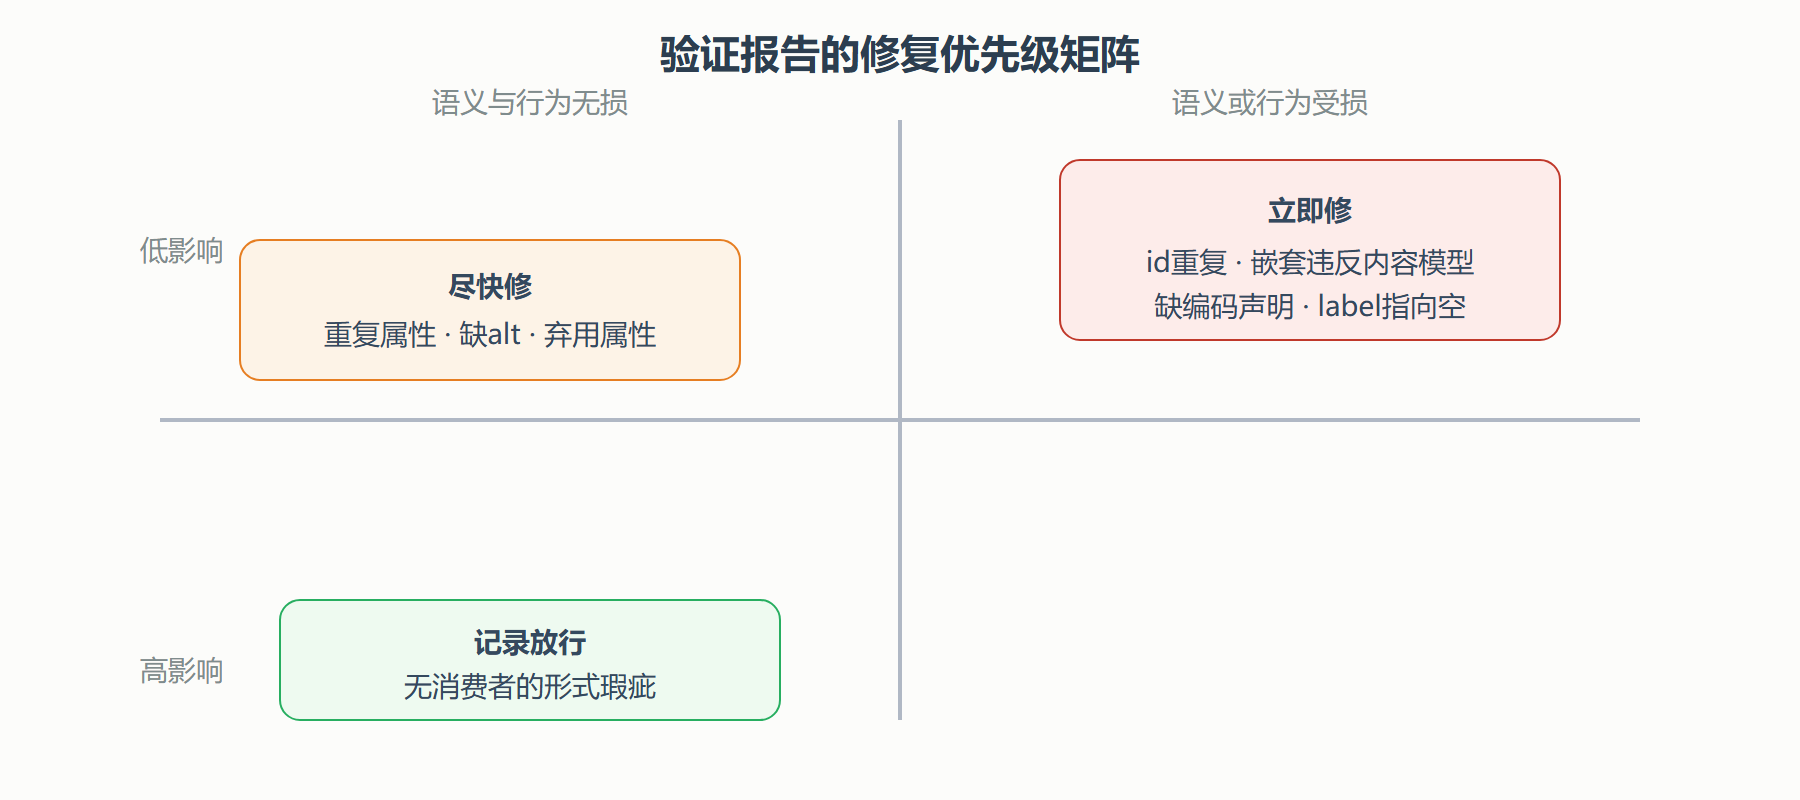
错误表示文档确实不符合标准。但"不符合标准"不等于"页面会坏",要按影响分级:
第一档,必须修:影响语义或行为的错。id 重复(锚点错乱、label 关联失效)、元素嵌套违反内容模型(form 套 form、p 里塞 div——后者会让解析器自动拆开你的结构,渲染结果与源码不一致,排查起来极其隐蔽)、缺少字符编码声明(第 1 章的乱码关卡)、label 的 for 指向不存在的 id。
第二档,尽快修:影响互操作性的错。属性值不带引号且含特殊字符、img 缺 alt(验证器会报,第 4.2 节讲过它同时是无障碍问题)、重复属性(第一个生效后面的失效,行为与直觉相反)。
第三档,可以缓:纯形式错。结束标签顺序小瑕疵、过时的表现性属性(多数场景该清理,但存量代码里优先级最低)。
警告表示"可能有问题,请人工判断"。常见如:内容模型外的元素被解析器重排、experimental 属性、可访问性提示(图片缺替代文本也会以警告形式出现)。警告的解读要回到因果:它指向的地方有没有真实的消费者受损——有就当错误修,没有就记录放行。
三类必修错误详解
id 重复。浏览器不报错,但每个依赖 id 的机制都悄悄指向第一个匹配:页内锚点跳错位置、label 关联失联、脚本按 id 取元素拿到错的那个。模板循环里复制 id 是高发场景(第 1 章的误用清单提过),验证器是唯一能兜住它的自动检查。
内容模型违规。最典型的如 p 里放 div:解析器容错时会把 p 拆成两段,DOM 结构与源码大相径庭——样式选择器按源码理解,浏览器按拆后的 DOM 渲染,"样式莫名失效"的老大难源头之一。第 1 章讲内容模型时说过"p 为什么装不下 div",验证器就是那条规则的执法者。
编码声明缺失。第 1 章的三道关卡第二关,浏览器会猜编码,猜错就乱码。验证器直接点名,五秒修掉一个未来两小时的排查。
验证与规范、可访问性的分工
到这里可以画清三者的边界:验证对照标准(条文来自 HTML 规范,全球统一)、规范对照团队约定(缩进命名类,标准不管)、可访问性检查对照辅助技术需求(部分与验证重叠,如 alt;部分超出,如对比度、焦点顺序)。三套检查各查一摊,工具链上常常合并成一个命令——但理解边界仍有必要:验证通过不等于规范达标(格式问题验证器不管),更不等于可访问(键盘走查必须人做)。把验证报告当"质量终点"是常见误区,它是机器能查的那部分终点。
三类可先放的问题
与必修清单对应,也有三类可以先放的问题,明确说出来避免过度纠结构。
其一,形式性弃用警告。存量代码里用到的旧式表现属性(如某些对齐属性),在纯展示场景不伤任何消费者,清理它们的价值要排在功能缺陷之后。其二,第三方注入内容的错误。广告脚本、嵌入组件注入的标记你控制不了,验证器会如实报告但修复责任不在你——报告里分清"我的文件"与"注入产物",别为别人的标记加班。其三,实验性特性的提示。使用了带实验前缀的属性时验证器会提示,这类提示是信息不是指责:你该确认的是降级路径(第 2 章的判断框架),而不是删除特性。
分清必修与可放的判断主线始终是那条:有没有真实的消费者受损。机器报告给了线索,因果判断仍然由工程师做——这也是本章反复强调"验证是手段不是目的"的落点。
接进流程:从手跑到门禁
验证的价值与执行频率成正比。落地三档:
第一档,编辑时实时校验。编辑器插件随写随标,成本为零,抓闭合、拼写这类低级错。
第二档,提交前本地跑一遍。命令行验证工具对整个项目跑,改动文件必过。
第三档,持续集成门禁。构建流水线里跑验证,错误数超过阈值(新项目为零,存量项目"不增反降")则拦截合并。阈值策略要务实:接手一个有三百个历史错误的存量项目,目标定为"今天三百明天二百九十九"的递减曲线,而不是一刀切的零——后者只会导致流程被绕过。
⚠️ 常见坑:为了报告清零而"修复"出问题。见过为了消掉内容模型警告把结构改坏、为了过校验删除了必要的注释甚至内容的案例。验证是手段不是目的,每条修复都该能回答"这修复让哪个消费者受益"——答不出的"修复"是应付检查。
动手实验:一份自带错误清单的样本
<!DOCTYPE html> <html lang="zh-CN"> <head> <meta charset="UTF-8"> <title>验证练习样本</title> </head> <body> <p> 段落里塞一个区块级元素 <div>我是被解析器强制拆队的 div</div> </p> <p id="dup">第一个 dup</p> <p id="dup">第二个 dup:id 重复了</p> <img src="pic.png"> <label for="ghost">幽灵关联</label> <input type="text" name="a" name="b"> </body> </html>
把这份样本送进任意验证器,对照报告逐条打钩:p 内嵌 div(内容模型)、id 重复、img 缺 alt、label 的 for 指向不存在的 id、input 重复的 name 属性。然后在浏览器里打开它,用开发者工具看 DOM——注意 p 的结构被解析器拆成了什么样子,与源码对比。最后按优先级矩阵修复全部问题,再跑一次验证到零错误。这一来一回,验证报告从"英文报错列表"变成"带因果的施工图"。
一个历史注脚:验证器为何重要过又边缘过
验证的地位经历了一轮有趣的浮沉。XHTML 时代(要求严格 XML 语法,一个未闭合标签整页拒绝渲染),验证是生死攸关的事——不验证页面直接打不开。HTML5 回到"容错优先"的路线后,浏览器对错误越来越宽容,验证一度被当成"形式主义的老古董",很多团队的流程里干脆消失了。近几年它回归,原因有两个:一是第 2 章讲的那批新消费者(读屏、爬虫、各种机器读取)重新放大了语义错误的代价——浏览器宽容它们不宽容;二是持续集成让验证的执行成本降到了接近零,机器能查的问题没理由再靠人眼。这段浮沉的教学价值在于:工具会随生态变迁改变重要性,但"文档要与标准一致"这条底线从未变过,变的只是谁来守、成本多少。
顺带一提验证与测试的关系,这是新人常混的一对概念。验证检查的是"标记是否符合 HTML 标准",自动化测试检查的是"我的代码是否实现了我想要的行为"——一个对照外部契约,一个对照内部意图。两者互补而非替代:一份通过验证的文档完全可以行为错误(比如用对了标签但交互逻辑写反了),一份行为正常的页面也可能验证一塌糊涂(比如 id 重复碰巧没触发问题)。质量流程里它们各占一行,谁也不能替谁站岗。
高频疑问两则
收束一句:验证器是最便宜的质量投资——零成本接入、机器不知疲倦、条文一条不落,接入越早回报越大。
问:大厂页面验证也一堆错误,是不是说明验证无所谓?
不。这恰恰说明"零错误"不是质量的充分条件也不是必要条件,但报告内容仍然有信息量——大厂页面的错误多是模板拼接产生的形式性问题,而 id 重复、结构拆裂这类语义错误在任何团队都是要修的。正确的结论不是"别人也错所以无所谓",而是"按影响分级,先修有消费者的错"。
问:框架与构建工具时代,手写 HTML 越来越少,验证还有意义吗?
更有意义。组件模板、模板引擎拼接、富文本注入,这些现代来源产出的 HTML 同样要过标准的关卡,而且拼接类来源恰恰更容易产出 id 重复与嵌套违规(两个各自合法的组件拼出整体非法的文档)。验证工具可以接进构建流程对产物 HTML 跑,"写得少"不等于"错得少"。
本节要点回顾
(验证报告读熟之后,你会自然记住高频错误的模式与位置,下次写代码时手就会自动避开,这比背规范条文的记忆方式牢固得多。)
- 验证是机器评审员:标准条文逐条比对,浏览器兜底渲染但没人兜底语义。
- 错误按影响分三档:伤语义与行为的立即修(id 重复、内容模型、编码声明),伤互操作的尽快修,纯形式的可缓。
- 警告回到因果:有消费者受损当错误修,没有就记录放行。
- 阈值务实:存量项目走递减曲线,零错误不是一刀切的目标。
- 三套检查各查一摊:验证对照标准、规范对照约定、可访问性对照辅助技术——验证通过不等于万事大吉。
第 4 章收官。质量四维讲完,下一章进入工程深水区:组件化、交互、性能、安全与未来趋势。