1.2 案发时刻:1998年超新星的异常读数
1.2 案发时刻:1998年超新星的异常读数
本节摘要:1998 年,超新星宇宙学项目与高红移超新星搜索队两个互相竞争的团队,用 Ia 型超新星的标准烛光亮度测量宇宙距离,各自独立发现高红移超新星系统性偏暗——比减速宇宙的预言远出百分之十几到二十。本节复现这次测量的读数逻辑:光度距离的数值积分、距离模数的换算、以及"偏暗零点几个星等"如何翻译成"宇宙在加速"。
上一节立好了减速宇宙的对照基准,本节按时间顺序复盘案发当晚:观测者想测什么、实际读到什么、异常有多大。第二章 2.1 节还会从证词可信度角度深挖标准烛光,这里先把案情框架搭起来。
两位观测者的原始口供
案发的经过值得按档案复述。1998 年 2 月,高红移超新星搜索队率先公布分析:在十几颗红移 0.3 到 0.9 的 Ia 型超新星里,减去预期演化与尘埃效应后,亮度比减速宇宙的预言系统地偏暗。一年后,超新星宇宙学项目用更大的样本(四十余颗)得到同样结论。两个团队用的是同类方法却互相竞争、样本独立、分析管线独立——这种结构在科学取证里几乎等于互为公证。结论被表述为:宇宙的膨胀在过去几十亿年里没有得到预期的减速,反而加速了。
值得强调的是当时观测者的预期方向。两个团队最初的目标都是测量宇宙减速的快慢,进而定出物质密度参数——按主流预期,高红移超新星应当比"空宇宙"更亮(更近),因为减速让它们被推得没那么远。读数却指向相反方向:比空宇宙还暗。第一反应自然是怀疑系统误差,尘埃、演化、选择效应被逐一排查,最后都压不住这个信号。
距离模数:异常读数的计量语言
要把"偏暗"变成可计算的量,需要星等语言。视星等 m 与绝对星等 M 之差叫距离模数,它直接由光度距离决定:m 减 M 等于 5 乘以以十为底、真数为光度距离(单位取兆秒差距、除以十)的对数。Ia 型超新星的峰值绝对星等近似恒定(约负 19.3 等),测到视星等就等于测到距离。两种宇宙模型的差别,则集中在光度距离对红移的依赖上:减速越强的宇宙,同样红移的天体距离越近、显得越亮。
# 演算 1:两种宇宙在同样红移处的距离模数差 import math c, H0 = 299792.458, 67.4 # 光速 km/s,哈勃常数 km/s/Mpc Om, OL = 0.315, 0.685 def dL(z, model): # 光度距离(Gpc),数值积分 n = 4000; dz = z/n if model == "LCDM": f = lambda zz: 1/math.sqrt(Om*(1+zz)**3 + OL) else: # 爱因斯坦-德西特:纯物质、减速最强 f = lambda zz: 1/(1+zz)**1.5 s = sum(f((i+0.5)*dz) for i in range(n))*dz return (c/H0/1000)*(1+z)*s def mu(z, model): # 距离模数 return 5*math.log10(dL(z, model)*1e3) + 25 print("z ΛCDM-纯物质的 Δμ(星等)") for z in [0.3, 0.5, 0.7, 1.0, 1.5]: print("%.2f %+.3f" % (z, mu(z,"LCDM")-mu(z,"EdS"))) # 输出: # z ΛCDM-纯物质的 Δμ(星等) # 0.30 +0.266 # 0.50 +0.388 # 0.70 +0.479 # 1.00 +0.579 # 1.50 +0.685
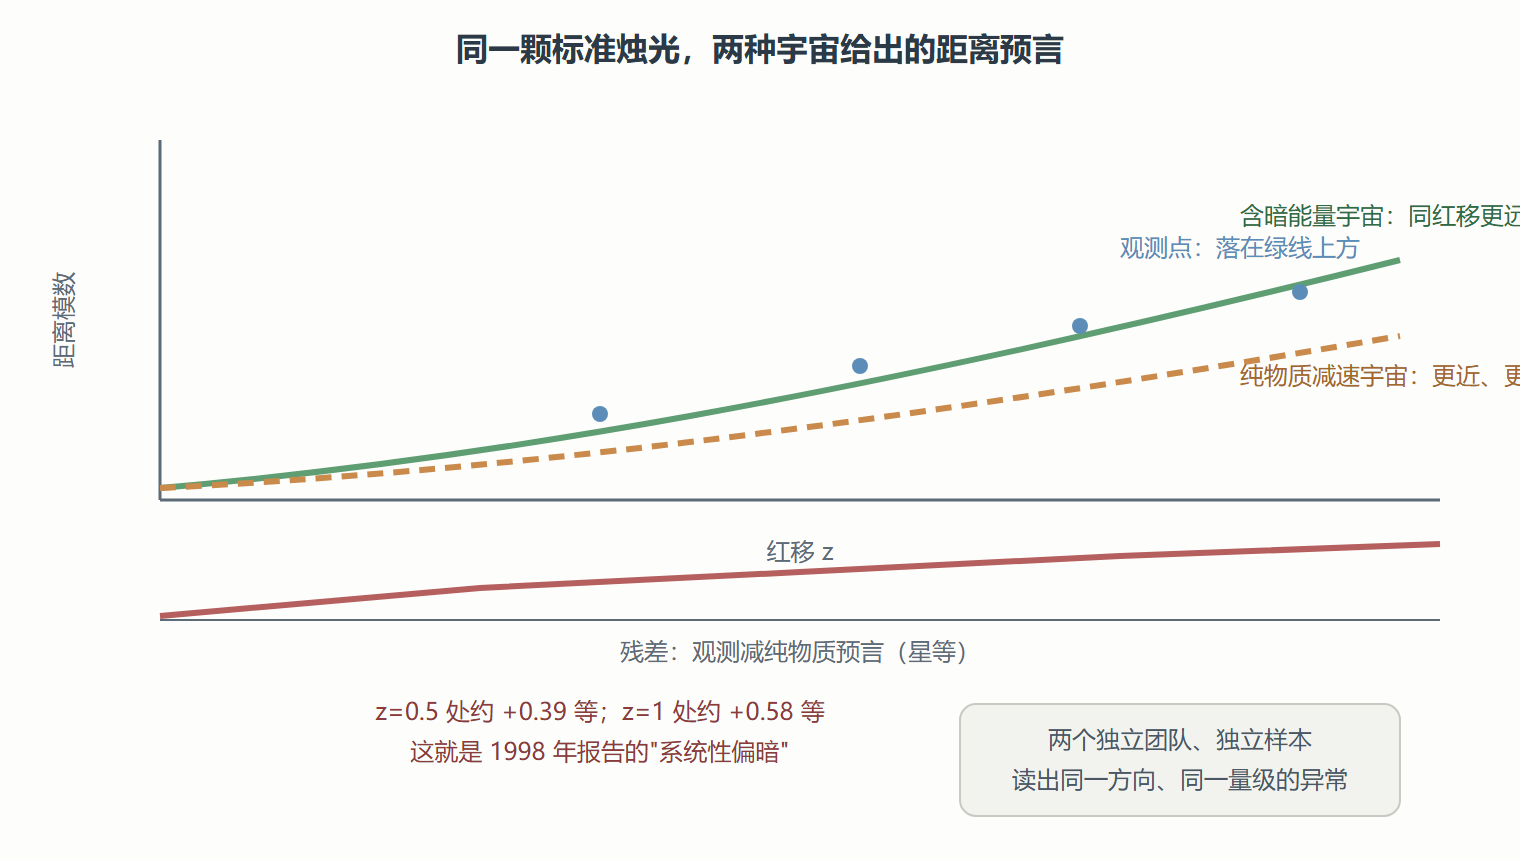
这张表就是案发读数的理论对照版:如果真实宇宙是含暗能量的 ΛCDM,而观测者用纯物质减速宇宙去预期,那么红移 0.5 的超新星会偏暗 0.39 星等、红移 1 处偏暗 0.58 星等。星等每差 5 等,亮度差一百倍,0.4 星等即亮度差约 30%——正在当年测量管线可分辨的范围内,但足以醒目。
图 案发读数:两条哈勃曲线的分岔
异常的量级与"暗多少"的换算
# 演算 2:把 0.39 星等换算成人话 d = 10**(0.39/5) # 亮度比 = 10^(-Δμ/2.5) print("偏暗 0.39 星等 = 亮度只有预期的 %.0f%%" % (100/d)) print("等价于距离比预期远 %.0f%%" % ((d-1)*100)) # 输出: # 偏暗 0.39 星等 = 亮度只有预期的 70% # 等价于距离比预期远 30%
红移 0.5 的超新星比减速宇宙的预期远三成——案发读数就是这一句话。两支团队读出的量级与上表一致(当年对比的模型细节不同,数字略有出入,但量级相同),于是 1998 年的报告把问题钉死:要么高红移宇宙存在未知的系统性暗化(尘埃被证明解释不了全部),要么宇宙的膨胀史与减速判决冲突。顺带一提,这条证据链的两位领队与发起者获得 2011 年诺贝尔物理学奖,颁奖词写的是"通过观测遥远超新星发现宇宙加速膨胀"。
案头验算:这么小的信号凭什么敢立案
0.39 星等听起来是个能被各种细节吃掉的小量,立案的底气来自样本统计。假设单颗超新星的测光加校准误差合计 0.15 星等,42 颗独立样本的均值误差就缩到 0.023 星等,0.39 的信号相当于十七倍标准差;哪怕只有 10 颗,也有八倍标准差。当年两支团队敢把"宇宙在加速"写进摘要,靠的不是哪一颗超新星亮得离谱,而是一批读数朝同一个方向偏。
# 演算 3:样本均值误差与显著性 import math # 信号 mu = 0.39 星等;单颗误差 sigma_1 = 0.15;N 颗独立样本的均值误差 = sigma_1/根号N for N in (10, 42, 100): sig = 0.15/math.sqrt(N) print("N = %3d 均值误差 %.3f 星等 显著性 %.1f sigma" % (N, sig, 0.39/sig)) # 输出: # N = 10 均值误差 0.047 星等 显著性 8.2 sigma # N = 42 均值误差 0.023 星等 显著性 16.8 sigma # N = 100 均值误差 0.015 星等 显著性 26.0 sigma
变式提醒:统计显著性高不等于系统误差归零。若样本里混进十分之一"年轻超新星被当成老年同类",平均亮度会整体偏移零点零几星等,量级足以吞掉半个信号——这就是 2.1 节把光度曲线宽度修正列为重点审讯对象的原因,也是两支团队当年互相检查清单时最较真的地方。
案情登记与后续侦办方向
- 案发时间:1998 年 2 月与 1999 年,两份独立报告先后归档
- 异常读数:红移 0.5 附近偏暗约 0.4 星等(亮度七成、距离多三成)
- 排除的干扰:银河系尘埃消光、超新星随宇宙年龄的演化、样本选择效应
- 待办:什么样的能量成分能产生这个方向的偏差——下一节从读数反推嫌疑人的必备特征
有一条现场经验值得记下:超新星测距真正的敌人从来不是统计误差,而是校准。把几十颗高红移超新星的亮度比较到零点几星等,需要低红移样本、同类归类、尘埃修正全部做对——这也是为什么单靠超新星一路证据不足以定案,第二章将看到另外四路证词如何补齐证据链。