3.3 超参数优化
3.3 超参数优化
本节摘要:学习率、批次、轮数这些"训练前定好的参数"叫超参数,它们对效果影响巨大却只能靠搜索。本节讲清三个关键超参数的作用、三种搜索方法(网格、随机、贝叶斯)的取舍,以及微调场景的高效调参策略。
本节目标
阅读完本节,你应当能够:
- 说出影响最大的三个超参数
- 对比三种超参数搜索方法
- 理解"学习率最重要"的原因
- 用高效策略调微调超参数
- 避免调参的常见陷阱
一、问题与直觉
超参数像菜谱里的"盐、火候、时长"——差一点,成品天差地别。但超参数没有公式可算,只能试。盲目试是碰运气,系统化搜索是工程:先知道哪个参数影响最大,再用对的搜索方法,最后用最少次数找到好配置。
二、核心原理
超参数没有公式可算,只能搜索:
2.1 三个关键超参数的影响
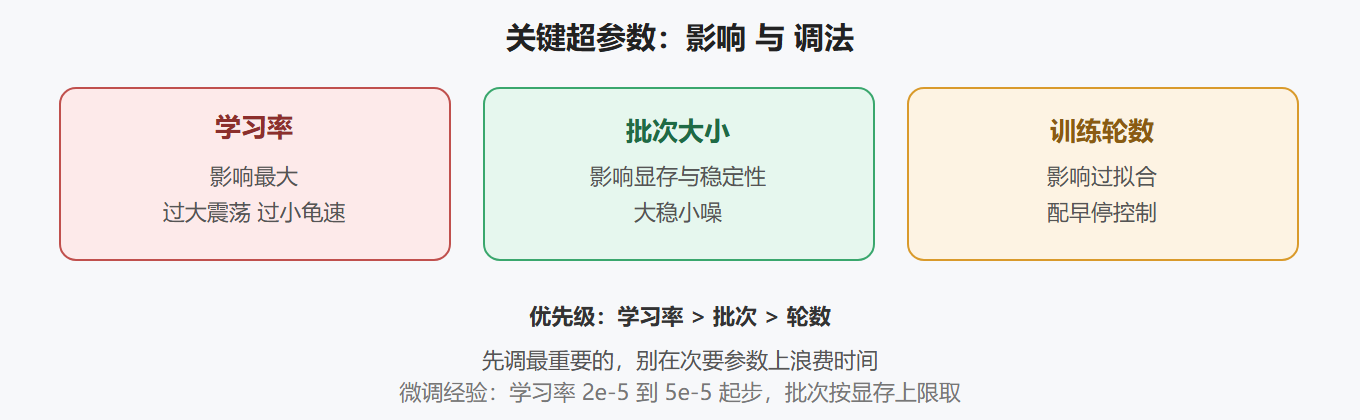
2.2 三种搜索方法
| 方法 | 做法 | 优劣 |
|---|---|---|
| 网格搜索 | 遍历所有组合 | 全面但极贵 |
| 随机搜索 | 随机采样组合 | 便宜且常更优 |
| 贝叶斯优化 | 根据历史结果智能试 | 高效但复杂 |
💡 关键直觉:随机搜索常优于网格搜索——超参数真正重要的没几个,随机采样更容易碰到"重要参数的好值"。多数场景用随机搜索就够。
三、工程实践要点
3.1 微调的高效调参策略
第一步 定学习率:小规模跑几轮,试 2e-5/3e-5/5e-5 第二步 定批次:按显存上限取最大可行值 第三步 定轮数:用早停决定 第四步 微调其他:warmup、衰减等按默认
3.2 学习率优先的原因
学习率是"步幅",直接影响能否收敛、收敛多快、最终效果。学习率错,其他都白调——所以调参第一刀永远砍在学习率上。
3.3 调参的工程工具
简单:手写循环跑几组配置 中阶:用随机搜索脚本 高阶:自动调参框架(超参数优化库)
⚠️ 常见坑:一次只改一个参数是调参铁律。同时改学习率和批次,效果变差时不知道是哪个的锅——控制变量,才能归因。
3.4 调参记录表
| 实验 | 学习率 | 批次 | 结果 | 结论 |
|---|---|---|---|---|
| 1 | 5e-5 | 4 | 0.72 | 基线 |
| 2 | 3e-5 | 4 | 0.75 | 学习率有效 |
| 3 | 3e-5 | 8 | 0.76 | 批次微升 |
每次实验记录配置与结果——没有记录就没有"经验",只有"感觉"。
3.5 贝叶斯优化的直觉
网格搜索把参数空间切成格子逐个试,随机搜索在空间里撒点——两者都"盲试"。贝叶斯优化则利用历史结果:它维护一个"效果关于参数的代理模型",每轮在"可能更好的区域"采样,并自动在"探索(试没试过的地方)"与"利用(试已知好的地方)"之间权衡。对微调来说,超参数不多但每次实验成本高(一次训练几小时),贝叶斯优化通常比网格搜索省一半以上的实验次数。
# 用 Optuna 做贝叶斯优化(概念示意) import optuna def objective(trial): lr = trial.suggest_float("lr", 1e-6, 1e-4, log=True) r = trial.suggest_int("lora_r", 8, 64) # 用 (lr, r) 跑一次微调,返回验证集指标 return run_finetune(lr=lr, lora_r=r) study = optuna.create_study(direction="maximize") study.optimize(objective, n_trials=20) print(study.best_params) # 20 次实验内逼近最优配置
注意一个实践细节:贝叶斯优化里每次实验应当固定随机种子与数据切分,否则验证指标的噪声会误导代理模型。建议先做两次小规模实验确认"学习率影响最大"再上优化器,让每一分算力都花在刀刃上。
3.6 超参数优化的三条铁律
第一,学习率永远第一个调,它影响最大且最直观(损失曲线震荡就降、不降就升);第二,每次只动一个变量,改完记录验证指标再动下一个,否则多个变量同时改,出了问题无法归因;第三,固定随机种子和数据切分,保证不同实验之间可比。遵守这三条,即使不用任何自动优化工具,手工调参也能稳定收敛到不错的结果。
核心回顾
- 要点一:三个关键超参数——学习率、批次、轮数
- 要点二:学习率影响最大,第一刀砍它
- 要点三:随机搜索常优于网格搜索
- 要点四:微调策略——先定学习率、批次取上限、轮数靠早停
- 要点五:一次只改一个参数,控制变量
- 要点六:实验记录是调参经验的载体
超参数找好了,最后一节上线前的体检——训练监控与调试。