4.2 自然语言处理领域应用案例
4.2 自然语言处理领域应用案例
本节摘要:NLP 是当前微调最热门的领域。本节以"领域客服问答"为例,走一遍大模型指令微调的完整流程:任务定义、对话数据构建、LoRA 微调训练、评估上线,并重点讲清"指令数据怎么造"这个决定成败的环节。
核心问题
阅读完本节,你应当能够:
- 定义 NLP 微调的任务
- 构建高质量的指令数据
- 用 LoRA 微调大模型
- 设计评估方法与基线
- 规避指令微调的常见坑
一、问题与直觉
"让通用大模型变成懂我们产品的客服"——指令微调的标准做法。通用模型懂语言但不懂你的业务;用"问题-标准回答"对微调,它就学会了你的回答风格与业务知识。NLP 微调里数据构建的功夫占七成——数据不好,训练白费。
二、核心原理
指令微调的主线非常清晰:
2.1 NLP 微调流程
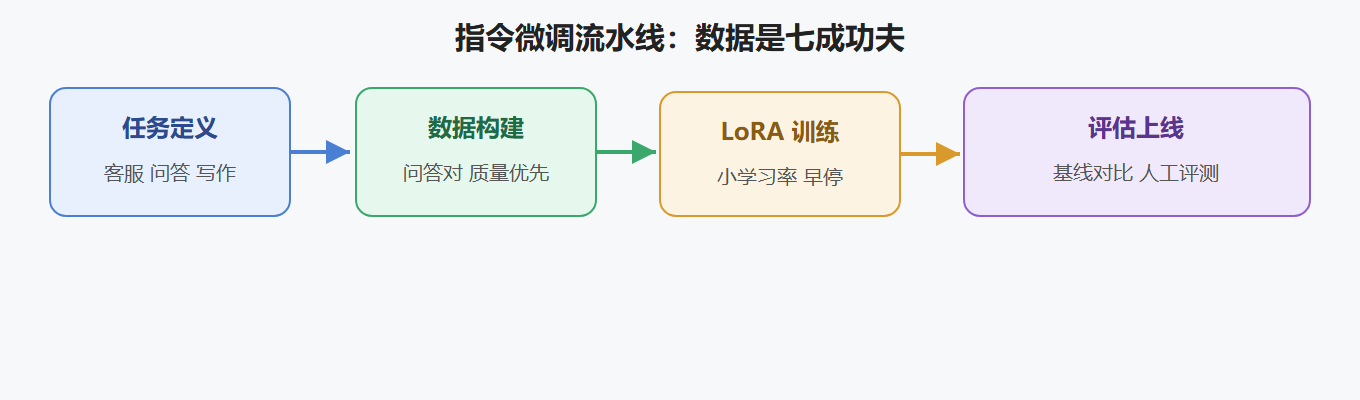
2.2 指令数据的形态
{ "instruction": "我们支持哪些支付方式?", "output": "我们支持微信、支付宝和银行卡……" }
一条指令数据 = 问题 + 标准回答。模型从大量这样的"问答对"中学会"面对这类问题该怎么答"。
三、工程实践要点
3.1 数据构建的五个来源
| 来源 | 做法 |
|---|---|
| 历史客服记录 | 清洗成问答对 |
| 文档提炼 | 从产品文档生成 QA |
| 人工撰写 | 领域专家写标准答案 |
| 大模型生成 | 让通用模型起草再人工审核 |
| 用户反馈 | 高频问题专项补充 |
💡 关键直觉:质量 > 数量。一千条"真实问法 + 专家答案"远胜一万条"机器造的泛泛问答"。每一条数据都要能代表一种真实问法。
3.2 LoRA 微调训练要点
模型:开源基座模型(7B 级别) 策略:LoRA(r=8-16, alpha=16-32) 学习率:2e-5 到 5e-5 轮数:1-3 轮(配早停) 显存:消费级显卡可跑
3.3 评估方法
| 方法 | 做法 |
|---|---|
| 基线对比 | 微调前后回答同批问题 |
| 人工评测 | 打分:准确、自然、全面 |
| 高频问题集 | 覆盖业务高频场景的测试集 |
⚠️ 常见坑:只跑自动指标不人工看回答。生成式模型的回答质量,机器指标常常失真——务必抽一批真实回答人工过目。
3.4 上线注意
- 保留基线模型:微调效果不好能回滚
- 监控回答质量:上线后持续抽检
- 定期再训练:业务变化后更新数据重训
3.5 指令微调数据的构建细节
NLP 案例里最影响效果的不是模型而是数据。指令微调(instruction tuning)数据通常长这样:系统提示(人设)、用户指令(问题)、期望回答。三个常见的构建错误是:回答里混入模型自己的思考痕迹、指令与回答风格不统一、样本重复度过高导致模型背题。建议每条数据经过"编写—抽检—去重—配比"四步:先人工写 50 条标杆样本定风格,再批量生成后抽检 20%,用向量去重去掉近似重复,最后按业务场景配比(高频问题多写、低频问题保底)。
{"system": "你是电商客服,回答简洁、给出可执行步骤。", "user": "退货怎么申请?", "assistant": "在订单页点击申请退货,选择原因并提交,审核通过后 48 小时内退款。"}
另一个细节是负样本:只喂"正确的回答"会让模型对错误输入过于宽容,适当加入"拒绝不合理请求"的样本,能显著改善模型的边界行为。
还要提醒一个 NLP 微调特有的细节:长度与批次的关系。对话类样本长度差异大,一个批次里最长样本决定 padding 长度,浪费算力。工程上常用"按长度分桶"(把长度相近的样本放同一批次)加动态 padding,能把训练吞吐提升 30% 以上;同时设置 max_length 截断并统计数据长度分布,避免长尾样本拖慢整个训练。
本章回顾
- 要点一:指令微调 = 问答对继续训练,让通用模型懂业务
- 要点二:数据构建占七成功夫,质量大于数量
- 要点三:五个数据来源——记录、文档、人工、生成、反馈
- 要点四:LoRA + 小学习率 + 早停是标准配置
- 要点五:人工评测不可省,抽批真实回答过目
- 要点六:保留基线、监控质量、定期重训
NLP 案例完成,下一节跨领域——模型迁移的适配之道。
把本节要点收成一句话:NLP 微调的成功七成在数据(风格标杆、抽检去重、负样本配比),三成在训练细节(按长度分桶、动态 padding、小学习率)——数据先行、细节跟上,效果自然提升。