5.4 AutoML 与自动模型微调
5.4 AutoML 与自动模型微调
本节摘要:微调要调数据、调策略、调超参数——能不能自动化?AutoML(自动机器学习)把"试错"变成"搜索"。本节讲清 AutoML 要自动化什么、搜索怎么进行、对微调意味着什么,以及它的边界。
本节目标
阅读完本节,你应当能够:
- 说出 AutoML 自动化什么
- 理解搜索空间与搜索策略
- 认识 AutoML 对微调的意义
- 了解 AutoML 的成本与边界
- 判断是否值得用 AutoML
一、问题与直觉
微调里最耗人的环节:调超参数(试几十组)、试策略(全量还是 LoRA)、折腾数据(增强怎么配)。AutoML 把这些"试错"自动化:定义一个搜索空间(哪些参数、什么范围),让算法自己找最优组合。人从"手动试"变成"定范围、看结果"。
二、核心原理
AutoML 的循环逻辑:
2.1 AutoML 自动化什么
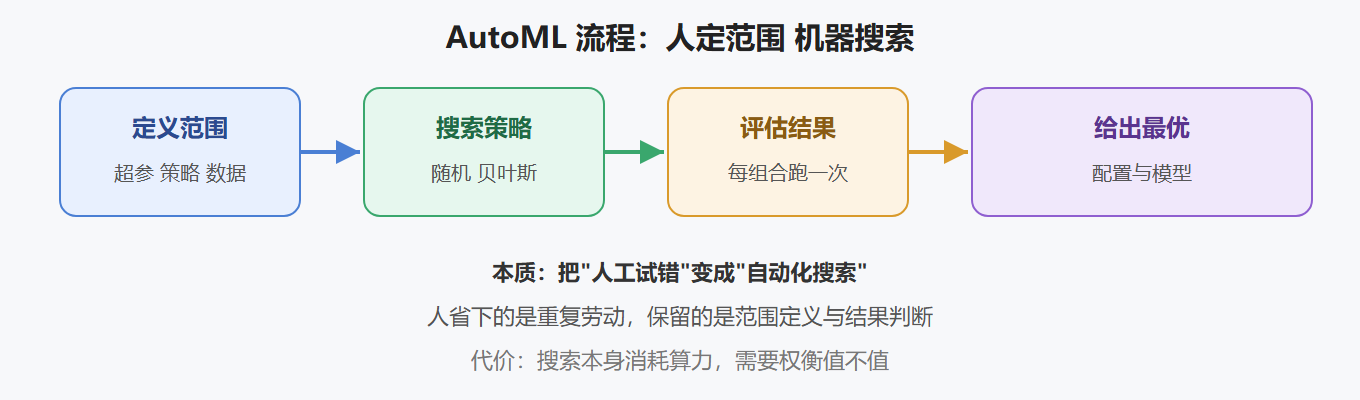
2.2 搜索策略的演进
| 策略 | 思路 | 效率 |
|---|---|---|
| 网格搜索 | 全组合遍历 | 低 |
| 随机搜索 | 随机采样 | 中 |
| 贝叶斯优化 | 用历史结果智能选 | 高 |
| 强化学习 | 学一个搜索策略 | 最高(也最贵) |
💡 关键直觉:AutoML 是用算力换人力。搜索一次要跑几十上百次训练——算力便宜、人力贵时划算;小项目手动调几组可能更快。
三、工程实践要点
3.1 AutoML 对微调的意义
| 环节 | AutoML 能自动什么 |
|---|---|
| 超参数 | 学习率、批次、轮数 |
| 策略 | 全量 vs PEFT 对比 |
| 数据增强 | 增强方式与强度 |
| 模型选择 | 基座模型选型 |
3.2 实用落地方式
起步:先用随机搜索自动扫超参数 进阶:限定范围,用贝叶斯优化 全套:数据、策略、超参一体化搜索
3.3 AutoML 的边界
- 成本:搜索比单次训练贵得多
- 不可解释:自动找到的配置"不知道为什么好"
- 不算银弹:数据质量与任务定义仍需人来定
⚠️ 常见坑:小项目也上全套 AutoML。搜索成本可能超过手动调参——先评估"人力 vs 算力"哪个贵,再决定要不要自动化。
3.4 判断是否值得
| 情况 | 建议 |
|---|---|
| 超参数多、人调费时 | 值得 AutoML |
| 一次性的小项目 | 手动调更快 |
| 生产要持续更新 | AutoML 可复用到每次重训 |
3.5 AutoML 的适用边界
AutoML 擅长"在已定义的空间里找最优配置",但它不能替你做三件事:定义正确的目标(评测指标选错,搜索再久也白搭)、准备干净的数据(垃圾数据搜出的配置没有意义)、判断"是否该微调"(AutoML 默认你该微调,但有时提示词加 RAG 已经够了)。工程上的务实定位是:AutoML 作为"搜索器"帮你在少量候选配置里挑优,而不是作为"黑盒"替你包办整个项目。
AutoML 该做的:搜索学习率、LoRA 秩、数据配比等连续/离散空间 AutoML 不该做的:替你定义评测目标、判断是否值得微调
实际使用建议:先用小规模数据做一轮 AutoML 粗搜(预算 10-20 次实验),把搜索出的配置在小规模下验证稳定性,再手工精调最有把握的一两个参数(通常是学习率)。这样既享受自动化的效率,又保留人的判断,避免把关键决策完全交给搜索算法。
补充 AutoML 与人工经验的结合方式:搜索出的最优配置往往集中在某个稳定区域(比如学习率总在 1e-5 到 3e-5、LoRA 秩总在 16 到 32),这说明这些超参数存在"经验区间"。把搜索历史沉淀成团队的超参数基线表,后续同类任务直接从中取值,比每次重新搜索更省算力。AutoML 的价值不只是"这次的最优解",更是"这类问题的经验库"。
本节速览
- 要点一:AutoML = 把试错自动化,人定范围机器搜索
- 要点二:搜索策略演进——网格、随机、贝叶斯、强化
- 要点三:用算力换人力,先算账再决定
- 要点四:能自动超参数、策略、数据增强、模型选择
- 要点五:搜索贵、不可解释、非银弹
- 要点六:持续更新项目 AutoML 价值更大
AutoML 让流程"更自动",最后一节让结果"更可信"——模型可解释性与微调。
一句话收束:AutoML 是"加速器"不是"自动驾驶"——把搜索交给算法,把目标定义、数据质量与是否值得微调的判断留给自己,才是自动微调的正确打开方式。
换句话说,让机器替你跑实验,让你替机器定方向。