2.4 词法错误的诊断与恢复
2.4 词法错误的诊断与恢复
本节摘要:词法层的错误有两类——非法字符与残缺词素(未闭合字符串、超长数字、坏转义)。本节给出"恐慌模式"恢复策略的实现:报错带行号与词素原文、跳过最小坏段继续扫描、限制错误总数防止雪崩,并讨论错误信息怎么写才能真正帮到排错的人。
阅读完本节,你应当能够:
- 区分非法字符错误与残缺词素错误,分别给出检测方法
- 实现恐慌模式恢复:报错、跳过、继续
- 说明"错一个报一串"级联雪崩的成因与抑制手段
- 写出包含位置、原文、原因、建议四要素的错误信息
错误长什么样
给 2.3 节的扫描器喂一段带伤的输入:
源程序片段: total = price * qty - discount @ ; msg = "unterminated string rate = 1e; 三类病灶: 第 1 行:@ 是非法字符,任何模式都套不中 第 2 行:字符串开了头没有结尾,扫描器读到换行甚至文件尾 第 3 行:1e 是残缺的科学计数法,e 后面没有数字
第一类最好办:所有分支都匹配不上,当场报错跳过一个字符。第二、三类麻烦在"词素开了头收不了尾"——扫描器已经消费了若干字符,进退两难。处理原则是:以词素为单位报错并整体丢弃,绝不把半截词素交给语法分析器。半截字符串进了单元流,语法层会报出一堆莫名其妙的错,把真正的病灶淹掉。
恐慌模式恢复
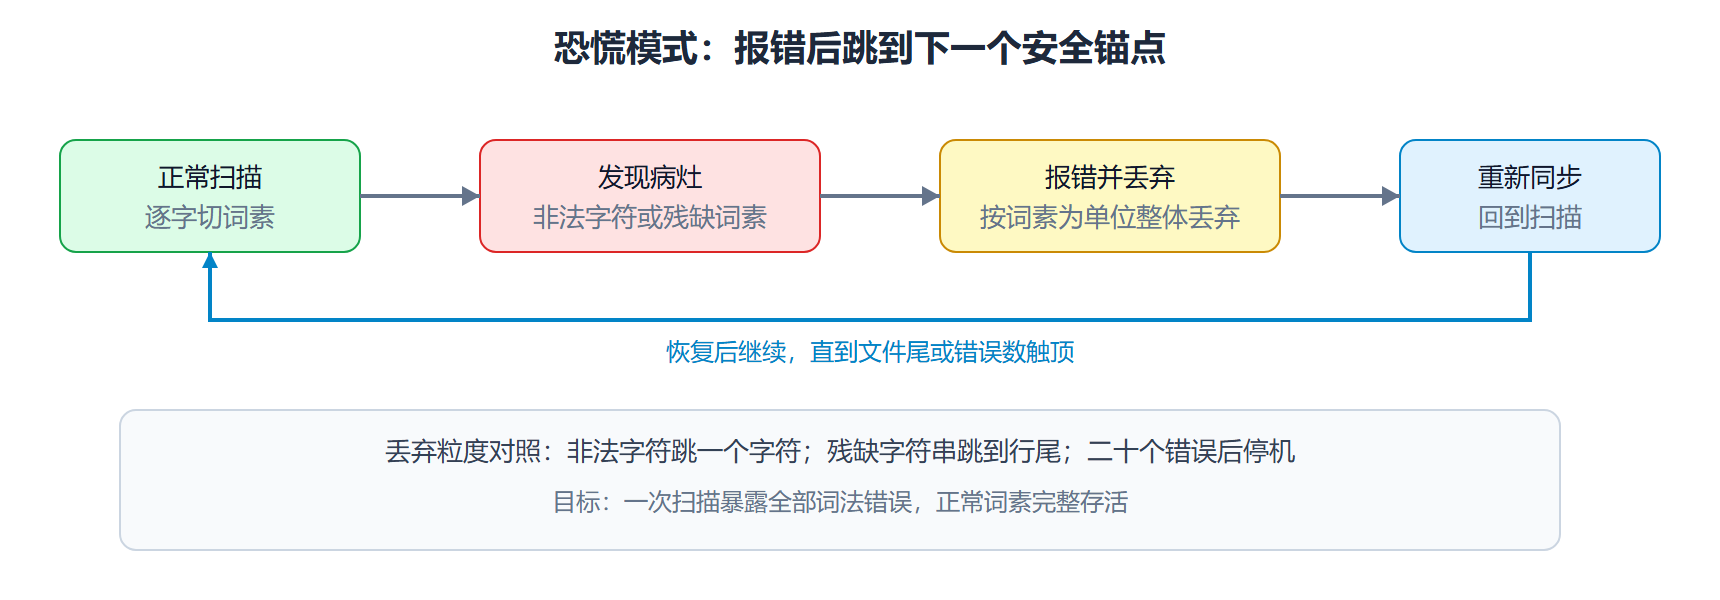
词法层最常用的恢复策略叫恐慌模式:丢弃字符直到重新同步到一个安全位置。对词法而言,安全位置就是"下一个能被某模式套中的词素起点"。把它加进扫描器:
def tokenize_safe(src): tokens, errors = [], [] i, line, n = 0, 1, len(src) while i < n: c = src[i] if c == "\n": line += 1; i += 1 elif c == '"': # 字符串分支:带闭合检查 start, i = i, i + 1 while i < n and src[i] not in ('"', "\n"): i += 1 if i < n and src[i] == '"': # 正常闭合 tokens.append(Token("STR", src[start:i+1], line)); i += 1 else: # 残缺词素:整体丢弃 errors.append(f"第 {line} 行:字符串未闭合,起于 {src[start:start+14]}") i = i + 1 if i < n else i # 跳过换行,行号由分支一处理 elif c.isalpha(): start = i while i < n and src[i].isalnum(): i += 1 tokens.append(Token("ID", src[start:i], line)) elif c.isdigit(): # 数字分支:科学计数法检查 start = i while i < n and (src[i].isdigit() or src[i] in ".eE"): i += 1 lex = src[start:i] if lex.endswith(("e", "E", ".")): # 残缺:e 后无数字 errors.append(f"第 {line} 行:数字 {lex} 不完整,已丢弃") else: tokens.append(Token("NUM", lex, line)) else: errors.append(f"第 {line} 行:非法字符 {c!r},已跳过") i += 1 # 恐慌恢复:跳一个字符 if len(errors) >= 20: # 雪崩保险丝 errors.append("错误过多,扫描中止") break return tokens, errors
三个恢复动作各有分寸:非法字符只跳一个字符(最小丢弃);残缺字符串跳到行尾(词素边界);错误总数设上限(保险丝)。跑一下带伤输入:
输出单元流(正常部分照常切出): ID total ASSIGN = ID price MUL * ID qty SUB - ID discount SEMI ; ID msg ASSIGN = ← 未闭合字符串未进入单元流 ID rate ASSIGN = 错误列表: 第 1 行:非法字符 '@',已跳过 第 2 行:字符串未闭合,起于 "unterminated 第 3 行:数字 1e 不完整,已丢弃
三处病灶各自报了一行,正常词素全部存活——这就是恢复的目标:一次编译尽量暴露所有错误,而不是修一个错重跑一遍。
图 恐慌模式恢复的循环视角
错误信息怎么写
同样是报错,质量天差地别。四要素模板:位置、原文、原因、建议。
差:"syntax error" 好:"第 2 行第 9 列:字符串以 unterminated 开头但到行尾未闭合; 请检查是否漏了右引号,或改用可跨行的字符串写法"
第一句没给任何信息,用户只能干瞪眼。第二句有行号列号(定位)、词素原文(对照)、原因(未闭合)、建议(补引号或换写法)。特别强调"原文"这一项:报错里带上源码片段,用户不用切回编辑器对行号。主流 C 编译器与 Clang 的报错质量口碑差距,很大程度上就是这一项的功夫——后者会把出错的那一行原样打印,用插入记号指出确切列位。
级联雪崩与保险丝
错误最怕连锁。一个未闭合的字符串会把后面几十行全部吞进字符串内部,等真正闭合时,中间的正常代码全没了,随后语法分析器看到支离破碎的单元流,再报五十个错。五十个错里四十九个是幻影。抑制手段按代价从低到高:
- 限制单类错误重复次数:同样的错连报三次后合并为"此处省略 N 个同类错误"
- 错误总数保险丝:到二十个就停机,提示用户先修前面的
- 换行即放弃字符串:多数语言字符串不跨行,行尾强制闭合检查能掐断最大雪崩源
- 同步锚点升级:词法层的锚是"下一个词素起点",语法层的锚是"下一个分号"(第 3 章会见到)
💡 关键直觉:恢复策略的本质是赌注——赌丢弃的坏段后面还有能对上模式的内容。恐慌模式粗鲁但稳健,因为它只赌一个字符或一行;更聪明的恢复(猜用户想写什么)看似体贴,猜错时反而制造新幻影。工程上永远选"少猜多报"。
本节要点回顾
- 两类病灶:非法字符(无模式可套)与残缺词素(开了头收不了尾),后者必须整段丢弃
- 恐慌模式:报错、按词素为单位跳过、在下一个模式可套位置重新同步
- 四要素报错:位置、原文、原因、建议,缺一项都会让排错变盲飞
- 保险丝:错误总数上限加同类合并,防止幻影错误淹没真病灶
- 少猜多报:恢复不猜意图,一次扫描暴露全部错误是最高目标
词法阶段就此收官,主线语句已是干净的七个单元加分号。下一章的语法分析器将检查这些单元的排列是否合法,并搭出表达式的树。