3.2 自顶向下分析:递归下降与LL
3.2 自顶向下分析:递归下降与 LL
本节摘要:自顶向下分析从开始符号出发猜结构,最直观的实现是递归下降——每个非终结符写一个函数,函数体按产生式候选式逐个试探。本节手写分析主线语句的分析器(含建树),讲清向前看符号如何驱动候选式选择、左递归为什么必须消除、LL(1) 分析表与 FIRST/FOLLOW 集合的关系。
阅读完本节,你应当能够:
- 写出表达式各层的递归下降函数,正确处理优先级
- 解释候选式选择为什么只需要看一个向前看符号
- 消除左递归并说明不消的后果
- 说出递归下降与 LL(1) 表驱动实现的等价关系
一个函数一层文法
递归下降的代码结构与 3.1 节的文法一一对应。每个非终结符一个函数,函数内部按当前向前看符号选择候选式:
# 递归下降分析器:吃单元流,吐语法树 class Parser: def __init__(self, tokens): self.toks = tokens # 词法单元流 self.pos = 0 # 当前位置 def peek(self): # 向前看,不消费 return self.toks[self.pos] if self.pos < len(self.toks) else None def eat(self, kind): # 消费一个期望类别的单元 t = self.peek() if t is None or t.kind != kind: raise SyntaxError(f"第 {t.line if t else '?'} 行:期望 {kind}," f"实际 {t.kind if t else '文件尾'} {t.lexeme if t else ''}") self.pos += 1 return t # 因子 → ID 竖 NUM 竖 括号表达式 def factor(self): t = self.peek() if t.kind == "ID": return ("ID", self.eat("ID").lexeme) if t.kind == "NUM": return ("NUM", self.eat("NUM").lexeme) self.eat("LPAREN") e = self.expr() self.eat("RPAREN") return e # 括号只改结合,不进树 # 项 → 因子 乘 因子 乘 ...(循环 = 左递归的迭代写法) def term(self): node = self.factor() while self.peek() and self.peek().kind == "MUL": self.eat("MUL") right = self.factor() node = ("MUL", node, right) # 越循环越左,左结合 return node # 表达式 → 项 加减 项 加减 ... def expr(self): node = self.term() while self.peek() and self.peek().kind in ("SUB", "ADD"): op = self.eat(self.peek().kind) right = self.term() node = (op.kind, node, right) return node # 语句 → ID ASSIGN 表达式 SEMI def statement(self): name = self.eat("ID").lexeme self.eat("ASSIGN") value = self.expr() self.eat("SEMI") return ("ASSIGN", name, value)
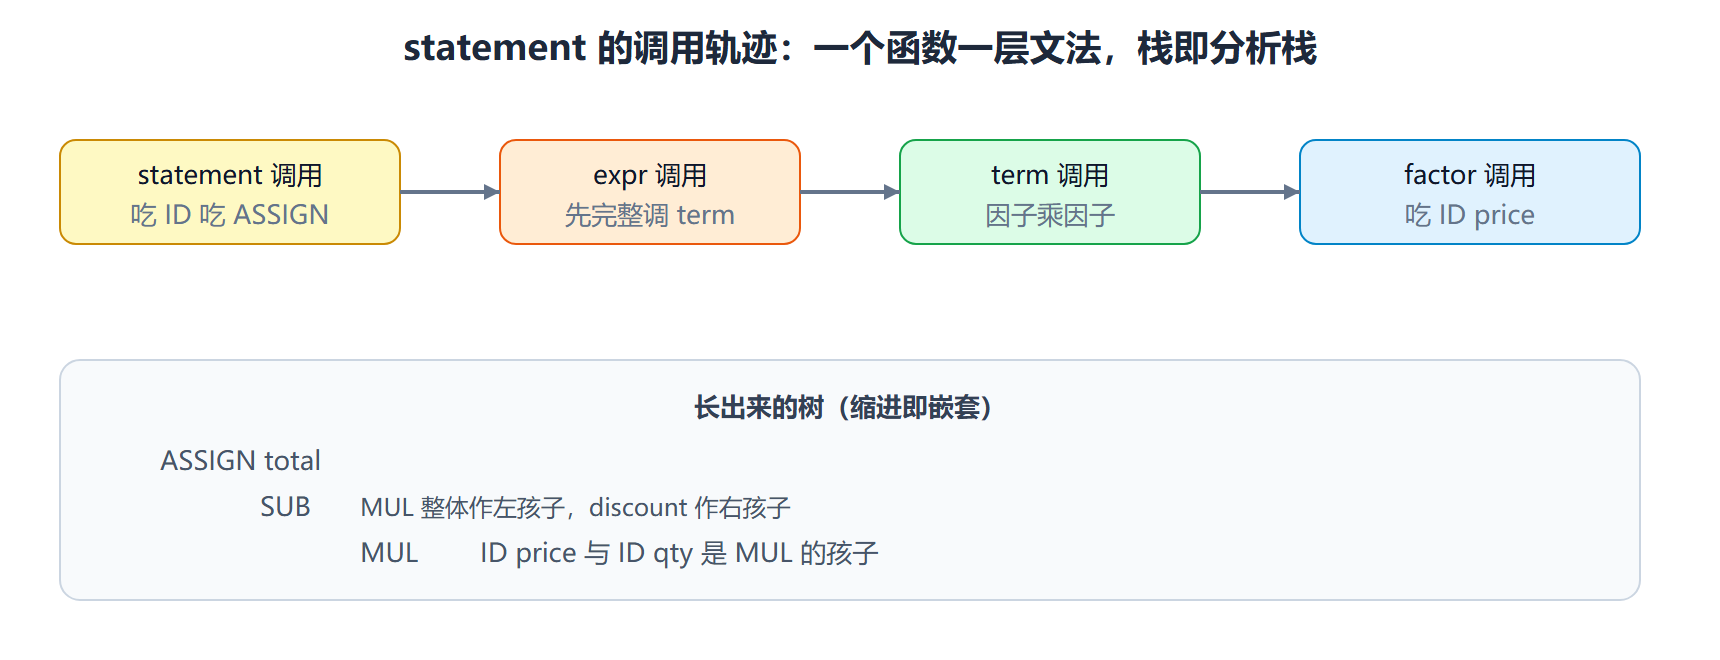
调用栈走一遍主线语句,看结构怎么长出来:
tokens = tokenize("total = price * qty - discount;")[0] tree = Parser(tokens).statement() print(tree) # 输出(缩进表示嵌套): # ASSIGN total # SUB # MUL # ID price # ID qty # ID discount
注意两件事。乘法节点比减法节点深——优先级来自 term 在 expr 之前被完整调用。减法循环把乘法结果当左操作数——左结合来自"先算左节点"的循环结构。文法的两层设计,在代码里变成两层函数调用,树形自动正确。
选择候选式:靠一个向前看符号
递归下降在每个分叉口要做决定:当前候选式走哪条?依据只有一个——当前向前看符号(peek 的结果)。这背后有一套计算:FIRST 集合(每个候选式能推出的第一个终结符的全体)与 FOLLOW 集合(非终结符后面可能跟什么)。若各候选式的 FIRST 集互不相交,看一个符号就够定夺,文法是 LL(1);相交就得试探或回溯,效率崩塌。
因子 的候选式:ID、NUM、LPAREN 表达式 RPAREN FIRST 集:{ID}、{NUM}、{LPAREN} 三者互不相交 → 看一个符号即可选定 表意:peek 是 ID 走第一支,NUM 走第二支,LPAREN 走第三支
表驱动的 LL(1) 分析器把这套选择做成一张 M[非终结符, 终结符] 表,配一个显式分析栈循环执行;递归下降则把分析栈藏在函数调用栈里。两者能力等价——递归下降就是用人能读的函数调用模拟 LL 分析栈。
左递归:递归下降的头号天敌
文法"表达式 → 表达式 ADDOP 项"直接翻译成函数会怎样?函数 expr 的第一件事是调用 expr,无限递归,还没消费任何单元就栈溢出。所以递归下降必须先消除左递归:
改写规则: 表达式 → 表达式 ADDOP 项 变成 表达式 → 项 表达式残 表达式残 → ADDOP 项 表达式残 竖 空串 代码层面即:先调 term,再 while 循环吃 ADDOP 左递归 → 循环,结合性保持左结合
通用变换模板:A → A α 竖 β 改写为 A → β A',A' → α A' 竖 空。函数体里的 while 循环就是 A' 的迭代形态。这条"左递归必须先消"的限制,是自顶向下路线相对自底向上路线最明显的文法约束,也是 yacc 文档反复提醒用户的地方。
图 递归下降的调用轨迹:函数栈即分析过程
递归下降的工程优势
为什么 GCC、Clang 这些大工程的前端至今手写递归下降?三个理由。错误信息好做:异常抛出点就在出错位置,带上单元原文即可,不像表驱动那样只有表项失败。语境传递自然:分析函数参数可以携带"当前在声明区还是表达式区"这类状态,直接改变词法或语义行为(第 2 章提过的语境反馈)。可断点可单步:函数调用栈就是人能读的分析过程,调试器里一目了然。代价是文法改动牵动代码——改一条产生式要改一个函数,大重构时不如生成器来得机械。
⚠️ 常见坑:在 term 循环里把 peek 写成 eat,提前消费了本不属于本层的符号,后面的 expr 拿到的单元流缺了一块,报出一个错位的语法错。向前看永不消费,是递归下降的铁律。
💡 关键直觉:判断一个文法能不能写递归下降,先查三件事——有没有左递归、各候选式 FIRST 集是否相交、公共前缀长不长。三关全过,一个符号的向前看就够;否则要么改文法,要么增加回溯(性能换文法自由度)。
本节要点回顾
- 结构映射:非终结符对应函数,产生式候选式对应 if 分支,循环替代左递归
- 优先级落地:term 在 expr 内先被完整调用,乘法自动比减法深一层
- LL(1) 条件:候选式 FIRST 集互不相交,一个向前看符号即可定夺
- 左递归必消:改写为循环,结合性不丢
- 工程取舍:错误信息、语境传递、可调试性让大编译器偏爱手写递归下降
自顶向下讲完,下一节掉头从叶子往根走:LR 家族的移进归约,以及它们凭什么被称为"万能分析器"。