3.4 语法错误的检测与恢复
3.4 语法错误的检测与恢复
本节摘要:语法错误在分析器"期望 A 却见到 B"的瞬间暴露,检测容易、恢复难。本节比较三种恢复策略——恐慌模式(跳到同步符号)、短语级恢复(局部替换删除)、产生式级恢复(错误产生式兜底),给出递归下降分析器的恢复实现,并讨论"错误信息该指认哪一行"这个比想象中微妙的问题。
阅读完本节,你应当能够:
- 说明分析器在什么条件下检出语法错误,错误定位为何天然精确到单元
- 实现递归下降的 panic 恢复:跳到分号或右花括号再续
- 比较三种恢复策略的代价与疗效
- 处理"错误在上一行末尾"的定位偏移问题
检出:期望与现实的落差
语法错误不需要专门检测——分析器按表行事,表说"此状态下遇到此单元无路可走",错误就浮出水面。递归下降里就是 eat 函数的期望检查;表驱动里就是查到空白表项。这带来一个天然优势:错误位置精确到单元,行号列号来自词法单元自带的属性。对比人工排错"到底错在哪一行"的抓瞎,编译器手握确切位置,报错质量的上限很高,实际产品却常常低于下限——问题全出在恢复与措辞。
三段带伤输入,三处病灶:
输入一(漏分号): total = price * qty discount = 0; 输入二(多右括号):total = ((price * qty) - discount); 输入三(错位符号):total = * price;
输入一的分析器走到 qty 之后期望 SEMI 却见到 ID——错误在"discount 之前的分号缺失"处检出。输入二多打的括号会在 RPAREN 期望处爆出。输入三的星号紧跟 ASSIGN,factor 无候选式可走。三者的检测点都是分析表空白,难点全在检测之后:报完错怎么办?直接崩溃,用户修一个错跑一次编译;硬着头皮继续,又可能后面全是幻影错。
三种恢复策略
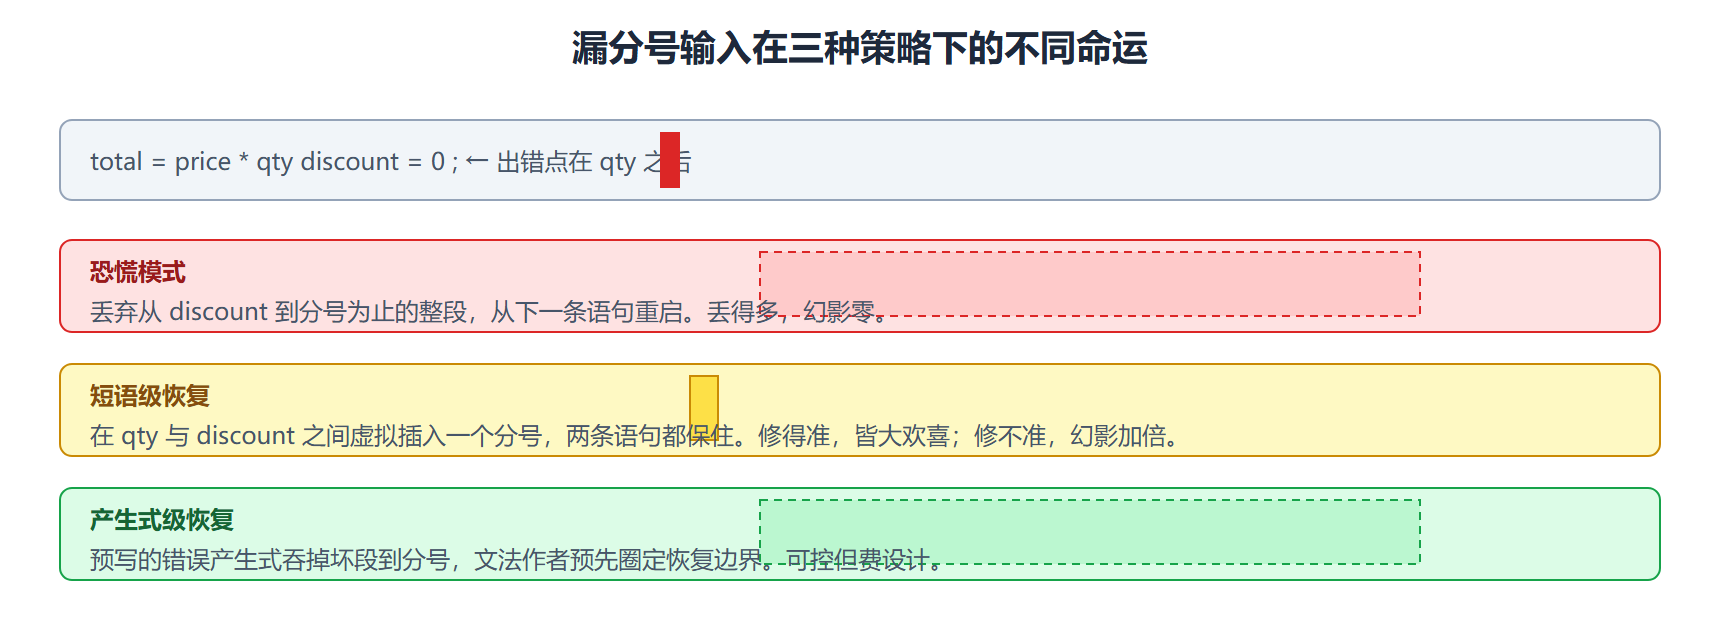
恐慌模式(同步到锚点)。丢弃单元直到遇到同步符号(分号、右花括号、begin/end 类关键字),从那里重启分析。粒度粗、实现简、极难产生幻影——因为丢得干净。给 3.2 节的递归下降分析器加上:
SYNC = {"SEMI", "RBRACE", "ID"} # 同步锚点集合 def safe_statement(self): try: return self.statement() except SyntaxError as e: print("语法错误:", e) while self.peek() and self.peek().kind not in SYNC: self.pos += 1 # 恐慌跳过,直到锚点 if self.peek() and self.peek().kind == "SEMI": self.pos += 1 # 锚点本身也吃掉,语句边界闭合 return None # 返回空树,主循环继续下一条语句 def parse_program(self): trees = [] while self.peek(): st = self.safe_statement() if st: trees.append(st) return trees
跑输入一:qty 后报"期望 SEMI 实际 ID",跳过 discount 与等号与零,落在分号上吃掉,接着扫下一条(本例已到结尾)。一条错,一个幻影都没有。
短语级恢复(局部手术)。在错误点做最小修正:把逗号当分号补、删掉多余右括号、插入缺失的分号。疗效好——语句大体保住,后续分析能继续在正确的结构上。风险也大:猜错修正方向会制造新幻影。表驱动工具的经典做法是给空白表项填"错误修正动作",等价于在表里预埋补丁。
产生式级恢复(错误产生式)。在文法里显式写"坏语句"的产生式,如 语句 → ID ASSIGN 错误 SEMI,非终结符"错误"在运行时吞掉从出错点到分号的一切。yacc 的 error 记号就是这个思路:文法作者预判哪里会坏、坏成什么样,把恢复逻辑编进文法。三者中它最可控,也最费设计。
图 三种恢复策略的丢弃范围对照
定位偏移:错在上一行
一个微妙问题:错误报在哪一行未必是出错的那一行。total = price * qty 漏了分号,错误却在下一行的 discount 处才检出——报"第 2 行错误"会误导用户去改第 2 行。成熟编译器的做法是双信息:报检出位置(第 2 行第 1 列),同时提示"或许在第 1 行末尾缺少分号"。这需要对错误模式做归因,短语级恢复天然携带这种归因能力(它明确知道要补什么),恐慌模式则只能报丢弃范围。实践中两者的报错措辞差距,是用户体感"编译器聪不聪明"的主要来源。
理想报错示例: main.c 第 2 行第 1 列:语法错误,发现标识符 discount 提示:上一行末尾可能缺少分号 1 行 total = price * qty 2 行 discount = 0; ^ 这里检出的错,病灶在上行末尾
恢复与继续的质量责任
错误的另一半是"继续之后的行为质量"。恢复后分析器应尽快回到正常轨道,并保证两点:其一,不再为同一段输入重复报错(同锚点去重);其二,语法树里不要留残缺节点混过语义分析——恢复产出的空树或错误节点要有标记,让第 4 章的语义分析知道绕行。语言服务时代又添新要求:编辑器里增量分析、边打字边报错,恢复策略还要可重入、无全局状态。这些工程细节比算法本身更决定产品口碑。
⚠️ 常见坑:恢复只跳单元不重置状态,分析器带着错误现场的状态进入新语句,好输入也报错。恐慌模式必须"跳干净":栈、位置、待处理状态全部复位到锚点。
💡 关键直觉:错误处理不是分析器的事后补丁,而是设计约束。一个语言把分号设计成语句终结符(而不是分隔符),错误恢复就能拿分号当天然锚点——语法设计的好坏,直接决定几十年后编译器报错的质量。
本节要点回顾
- 检出点:分析表空白或 eat 期望失配,位置天然精确到单元
- 三种恢复:恐慌模式丢段保命、短语级微创修补、错误产生式预埋兜底
- 定位偏移:检出位置不等于病灶位置,报错要携带归因提示
- 恢复后纪律:同锚点去重、残缺节点打标、语义层绕行
- 语言设计联动:分隔符与终结符的选型影响恢复锚点的天然性
至此语法分析收官,主线语句已是一棵结构合法的树。下一章语义分析上树作业:查类型、登记名字,然后把树翻译成三条三地址码。