4.1 类型系统与类型检查
4.1 类型系统与类型检查
本节摘要:类型是值的集合加可施于其上的运算;类型检查在语法树上自底向上计算每个节点的类型属性,遇到相容性缺口时按语言规则插入隐式转换或报错。本节以主线语句的浮点整型混合乘法为案例走完检查全程,并比较静态与动态、强与弱两组常见维度。
阅读完本节,你应当能够:
- 用"值集加运算"的定义解释 int 与 float 是不同类型
- 写出二元运算的类型合成规则表,判断混合类型的处理
- 在语法树上标注每个节点的类型属性并插入转换节点
- 区分静态/动态检查与强/弱类型两组正交概念
类型到底是什么
"类型是值集加运算"这个定义值得咀嚼。整型是某个范围内的整数集合,配上加减乘除取模;浮点是另一套近似实数的集合,配上浮点运算。两个集合不同、运算规则不同(整除对浮点除、溢出行为、精度损失),所以是两个类型。说"3 和 3.0 类型不同"不是抬杠——它们的位模式、可参与的运算、编译后的指令全都不一样。
类型系统就是一套规则,回答两个问题:怎样组合出新的类型(数组、结构、指针、函数签名),以及怎样的组合是相容的。主线语句的病灶正在第二个问题上:
声明: float total, price, discount; int qty; 表达式 price * qty 的检查: 节点 ID price 类型 float 节点 ID qty 类型 int 节点 MUL 需要:两操作数同类型且支持乘法 缺口:float 对 int,不同类型
合成规则与转换插入
类型检查是典型的综合属性计算:子节点的类型沿树向上合成,父节点规则裁决。设一份 C 风格的规则表(浮点高于整型,低向高隐式提升):
| 左操作数 | 右操作数 | 结果 | 需要的动作 |
|---|---|---|---|
| int | int | int | 无 |
| float | float | float | 无 |
| float | int | float | 右操作数插入 int 转 float |
| int | float | float | 左操作数插入 int 转 float |
| char 指针 | int | 报错 | 算术加或许合法,乘必错(按语言定) |
把规则套到主线语句的树上,走完整个自底向上的过程:
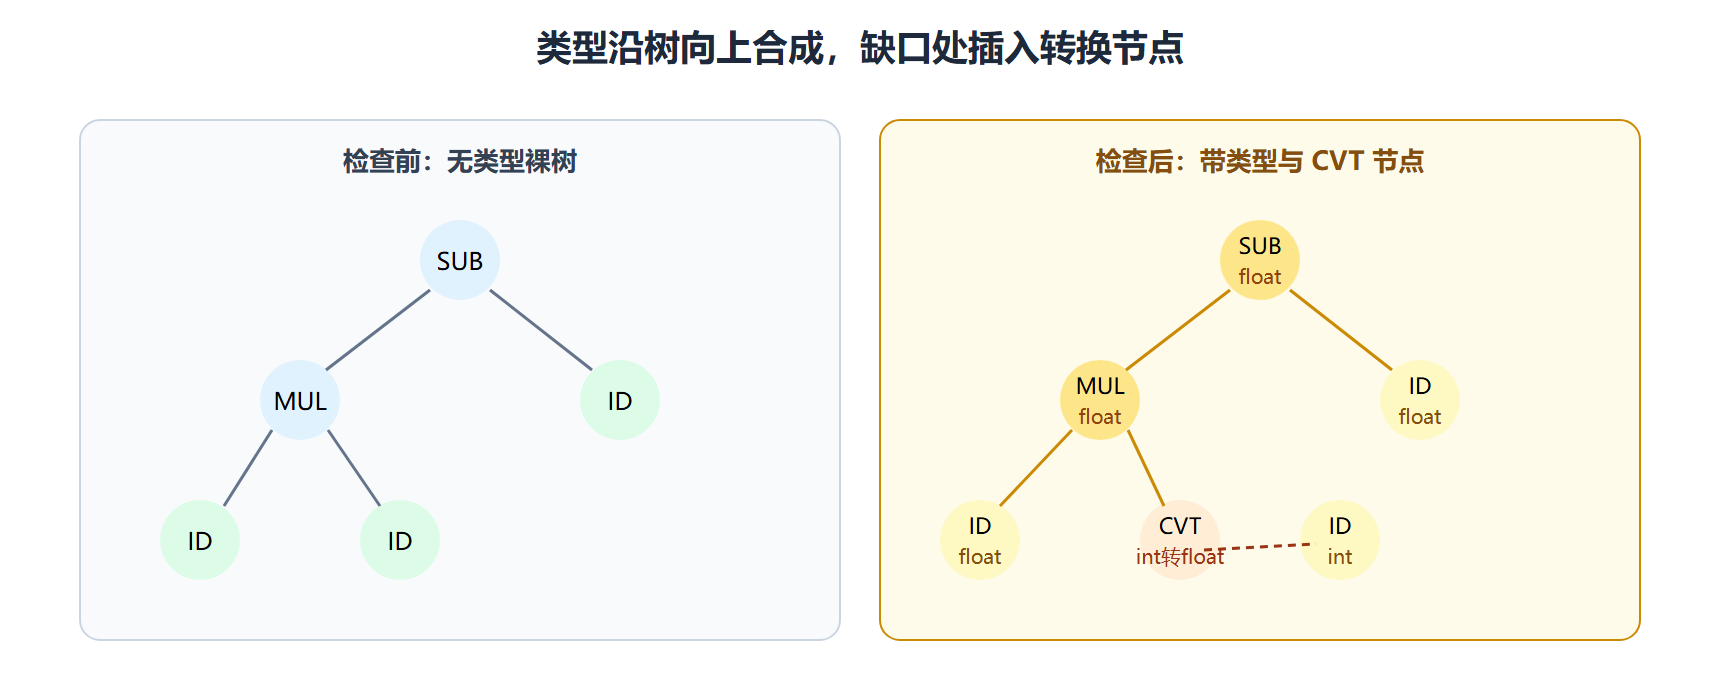
树与类型合成过程(声明同上): SUB ← float 合 float → float / \ MUL ID discount ← float / \ ID price ID qty float int 第1步 ID price 合成 float 第2步 ID qty 合成 int 第3步 MUL 节点:float 对 int → 插入转换节点 CVT,qty 转 float MUL 重新合成 float 第4步 ID discount 合成 float 第5步 SUB 节点:float 合 float → float 第6步 ASSIGN 节点:右 float,左 total 是 float → 相容,直接赋值 结论:一条隐式转换,零错误;树多了一个 CVT 节点
插入的 CVT 节点不是摆设——第 4.3 节生成中间代码时,它对应一条显式的转换指令;第 6 章生成汇编时,它对应一条定点转浮点的机器指令。语义层的一次"补丁",一路传导到目标码。
图 类型检查:自底向上的属性合成与转换插入
两组正交的维度
静态对动态:检查时机。静态检查在编译期完成(C、Java、Rust 的主流部分),错误早暴露、运行零开销;动态检查推迟到运行期(Python 的变量类型、Java 的数组越界与类型转换),灵活但要背运行期检查成本。主线语句的类型插转换是典型的静态成果——转换在编译期敲定,运行期直接执行浮点乘法指令。
强对弱:相容规则的严格程度。强类型系统禁止不合规则的隐式转换(Rust 连整型之间都要显式),弱类型系统默许多种自动转换(C 的整型与字符与指针互转传统)。强弱的边界不是二值的,而是光谱——Java 比 C 强,比 Rust 弱。工程判断:强类型把错误压到编译期,弱类型减少显式转换的书写负担,语言设计就是在两头找位置。
⚠️ 常见坑:把隐式转换当免费午餐。C 里
float * int的提升看似无害,但在热循环里大量出现时,转换指令会吃掉可观的周期;更隐蔽的是精度陷阱——整型到浮点的转换在值很大时可能丢失精度。看汇编、数转换指令,是性能排查的常规动作。
💡 关键直觉:类型检查器本质上是一个"树的求值器",只是它求的不是数值,是类型。把它想成"用类型当值的解释器",综合属性的计算次序、短路求值、报错传播就全都顺理成章了。
边界上的追问
问:隐式转换的级联会失控吗? 会。三个操作数类型各异的表达式可能连插两条转换,最著名的反面教材是 C 与 C++ 中无符号与有符号的比较:有符号一侧被提升为无符号,负数变成巨大的正数,比较结果反直觉。语言演进史的一半内容,就是给这类转换立规矩(显式化、收紧、报错)。
问:类型推断和类型检查是一回事吗? 方向相反。检查是验证已有标注(total 标了 float,看相不相容);推断是从使用方式反推类型(total 参与 price * qty 又减 discount,推出它该是 float)。现代语言两者并用:推断省去书写,检查守住安全,第 8 章即时编译里的类型特化,本质是运行期的再推断。
补一问:类型检查在语法分析之后才做,会不会太晚? 一点都不晚,反而是最优安排:语法阶段树已成型,检查可以集中一次遍历完成;若在语法分析中穿插类型判断(老式一遍编译器的做法),两个阶段的错误混在一起,恢复逻辑互相干扰。分阶段串行不是教条,是错误处理与模块化的工程结论。
再补一问:子类型检查和本节的相容规则什么关系? 子类型是相容表的推广:int 到 float 的提升是语言内置的子类型关系,面向对象语言里的继承链是用户可扩展的子类型关系。检查算法因此从查表升级为沿继承链搜索,但骨架不变——仍然是对每个运算节点自底向上问一句"两边相容吗、要不要插转换"。
本节要点回顾
- 类型定义:值集加运算,位模式与规则的双重差异
- 综合属性计算:子节点类型向上合成,父节点规则裁决相容性
- 转换插入:混合类型按提升表插 CVT 节点,一路传导到目标码
- 两组正交维度:静态对动态是时机问题,强对弱是严格度问题
- 工程视角:隐式转换有运行代价,热路径的转换密度值得审视
类型裁决完毕,树带上了标注。下一节看被反复查询的符号表——四个名字如何登记、同名遮蔽如何处理。