4.3 中间代码生成:三地址码
4.3 中间代码生成:三地址码
本节摘要:三地址码每条指令至多一个运算、至多三个地址,是语法树最直接的线性化产物。本节实现从带类型标注的树到三地址码的翻译器,讲清临时变量的编号管理、转换节点如何落地成指令,并对比四元组、字节码、SSA 几种中间表示的定位差异。
阅读完本节,你应当能够:
- 写出表达式树到三地址码的语法制导翻译器
- 解释临时变量命名与释放策略对代码体积的影响
- 对比三地址码、四元组、栈式字节码、SSA 的表达形态
- 说明中间表示"离两端都不太远"的选型哲学
一条树节点,一两条指令
三地址码的名字来自它的形态约束:每条指令右边至多一个运算符,至多两个源地址加一个目标地址。这个"笨"约束是刻意的——指令简单到机械可翻译(到任何目标机都直白),又规整到方便做优化(第 5 章的所有变换都在这个形态上进行)。
把 4.1 节检查过的树(含 CVT 转换节点)翻译过来:
带标注的树: ASSIGN total / \ SUB ← float / \ MUL ID discount / \ ID price CVT | ID qty(int→float) 翻译结果: t1 = cvt_float(qty) ← CVT 节点落地为转换指令 t2 = price * t1 ← MUL 节点 t3 = t2 - discount ← SUB 节点 total = t3 ← ASSIGN 节点
比第 1 章预告的三条多了一条——那是还没算类型转换的简化版。转换一旦发生,中间代码就多一条指令,这就是"语义层的补丁传导到指令层"的实况。
翻译器:一次后序遍历
翻译逻辑是对树的后序遍历:先算子节点的代码,再把父节点的运算建立在子结果之上。代码极短:
temp_count = 0 def new_temp(): # 临时变量发号器 global temp_count temp_count += 1 return f"t{temp_count}" def gen(node): kind = node[0] if kind == "ID" or kind == "NUM": return node[1] # 叶子:直接返回名字/常量 if kind == "CVT": # 转换节点:一条指令 src = gen(node[1]) t = new_temp() print(f"{t} = cvt_float({src})") return t if kind in ("MUL", "SUB", "ADD"): left, right = gen(node[1]), gen(node[2]) t = new_temp() print(f"{t} = {left} { {'MUL':'*','SUB':'-','ADD':'+'}[kind] } {right}") return t if kind == "ASSIGN": value = gen(node[2]) print(f"{node[1]} = {value}") return node[1] # 喂入主线语句的树,输出: # t1 = cvt_float(qty) # t2 = price * t1 # t3 = t2 - discount # total = t3
翻译器的核心就这么多——新临时变量承接每个内部节点的值,父节点用子临时的名字继续运算。这个模式叫语法制导翻译:语法结构的处理规则(属性、动作)附着在文法或树上,遍历即执行。
三地址码的指令面
实际编译器的三地址码指令面比四则运算宽,常用的几类:
1. 二元运算 x = y op z ;加减乘除取模比较 2. 一元运算 x = op y ;负号、逻辑非、类型转换 3. 复制 x = y 4. 无条件跳转 goto L 5. 条件跳转 if x relop y goto L ;小于等比较 6. 索引 x = y[i] 与 x[i] = y 7. 调用与返回 param x / call p / return x
有了跳转与调用,三地址码就能表达任何控制流——第 5 章讲基本块时会看到,跳转指令正是切分基本块的刀口。
中间表示江湖
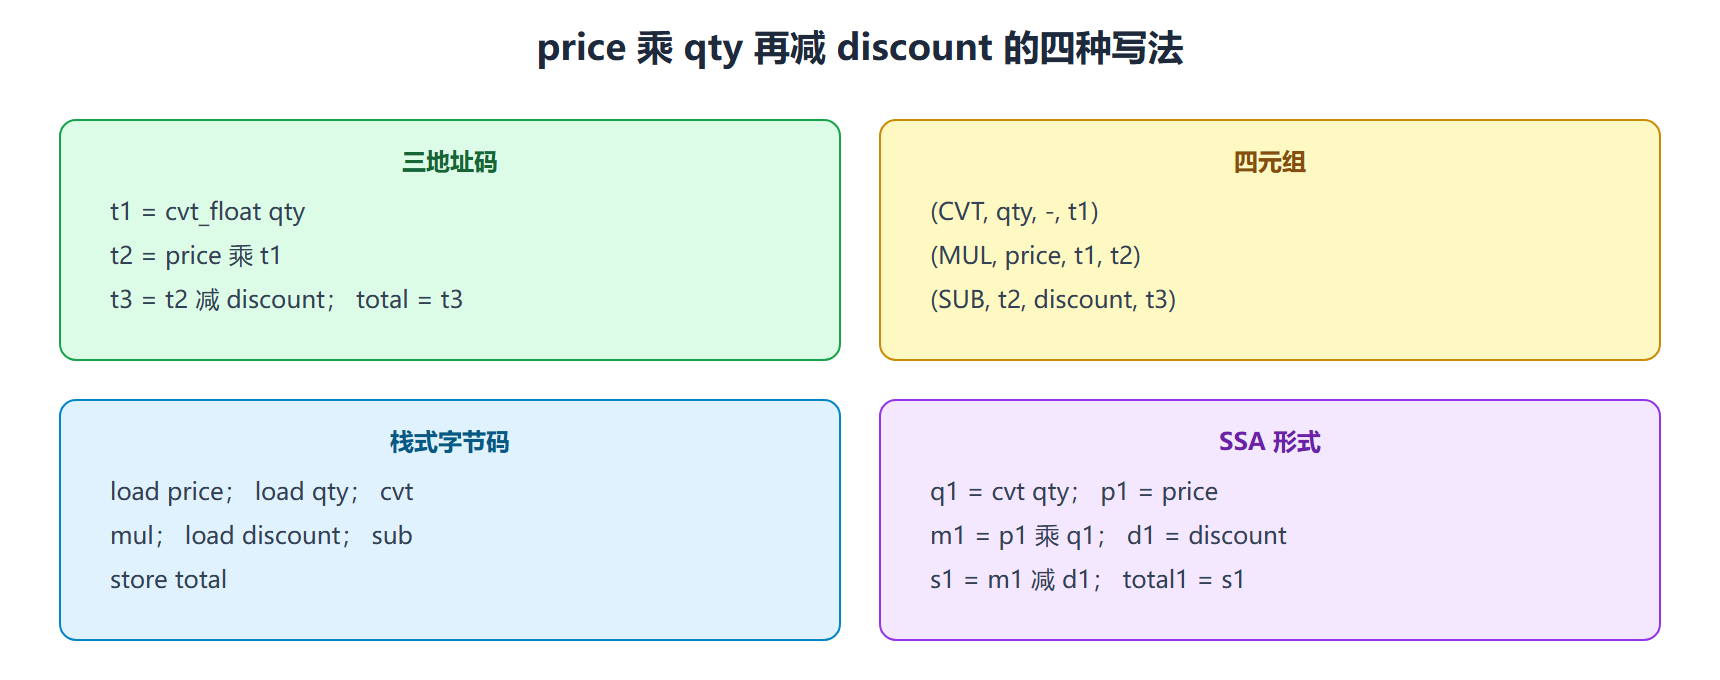
三地址码不是唯一选择。几种主流形态对照:
| 表示 | 形态示例 | 优 | 劣 |
|---|---|---|---|
| 三地址码 | t2 = price 乘 t1 | 翻译直接、优化好做 | 与机器指令仍有距离 |
| 四元组 | (MUL, price, t1, t2) | 结构化、便于表驱动 | 与三地址码等价,形式差异 |
| 栈式字节码 | push price、push t1、mul | 紧凑、虚拟机好实现 | 优化需先转寄存器形式 |
| SSA | t2 = price 乘 t1 且每个名字只定义一次 | 数据流显式、优化天堂 | 变量版本爆炸需善后 |
三者关系常被误解:它们不是竞争关系,而是编译器内部的不同楼层。GCC 用的是寄存器转移语言形式的中间表示,LLVM IR 是 SSA 风格的三地址码,JVM 字节码是栈式。同一家编译器里也可能多态并存——前端吐三地址码,进优化器前转 SSA,出优化器再降回普通形式。
图 同一表达式在四种中间表示下的形态
⚠️ 常见坑:临时变量只发不收,一个长函数生成几千个 t 编号,代码体积与后续分析的图规模一起膨胀。真实编译器有临时变量复用(值已消费且不再使用即可重新分配),最简单的复用策略在下一章基本块内即可完成。
💡 关键直觉:中间表示是编译器的"标准语"。前端只需会说它,后端只需能听懂它,两头的团队可以互不见面地并行开发——LLVM 生态几十种语言前端与几十种目标后端能协作,靠的就是这条语言契约。
形态选择的追问
问:三地址码的临时变量上限是多少? 没有上限,只有管理策略。理论上每个内部节点一个临时变量,长表达式能生成几十个。第 5 章的活跃性分析会证明多数临时变量活不过相邻两条指令,第 6 章的分配器据此复用寄存器——临时变量编号只是占位符,不代表真实占用。
问:能不能跳过中间表示直接生成机器码? 能,最早的编译器就这么干。代价是失去与机器无关的优化层:每种目标机都要重写全套优化。中间表示的本质是为优化和复用付费的抽象层,大型编译器生态(多前端多后端)没有它就无法成立——这笔账在第 1 章的三层工厂图里已经算过一次,现在是它的代码级注脚。
本节要点回顾
- 形态约束:每条至多一个运算三个地址,笨得恰到好处
- 后序遍历翻译:子节点结果进临时变量,父节点引用子临时
- 转换落地:CVT 节点对应一条显式转换指令,语义补丁传导到指令层
- 指令面:运算、复制、跳转、索引、调用,足以表达一切控制流
- 选型哲学:三地址码、四元组、字节码、SSA 是不同楼层,不是死对头
三条(加转换共四条)指令就绪。下一节看语义层怎么拦下"未声明、重复声明、类型冲突"三类错误,以及它比语法恢复难在哪里。